
Klinische validatie houdt in dat wordt getest of software voldoende nauwkeurige en veilige interpretaties oplevert voor de beoogde patiënten, en niet alleen of de software overtuigende rapporten genereert.

Belangrijkste punten
- Validatiebereik moet de beoogde patiënten, laboratoriumgegevens en klinische beslissingen benoemen; succes bij 1 taak bewijst niet de veiligheid bij alle toepassingen.
- Noemers voor nauwkeurigheid moeten onderscheid maken tussen patiënten, rapporten, biomarkers en afzonderlijke uitspraken; 10.000 uitspraken kunnen afkomstig zijn uit slechts 200 rapporten.
- Gevoeligheid meet gedetecteerde referentiepositieve gevallen; een hypothetisch resultaat van 90/100 betekent dat 10 aangedane gevallen zijn gemist.
- Voorspellende waarde hangt af van de prevalentie: bij een prevalentie van 1% leveren een sensitiviteit van 90% en een specificiteit van 95% een positief voorspellende waarde van ongeveer 15.4% op.
- Onafhankelijke tests vereisen beschermde testgegevens, een bevroren softwareversie en bekendmaking van wie de evaluatie heeft ontworpen, gefinancierd en beoordeeld.
- Bewijs per subgroep moet steekproefgroottes en onzekerheid omvatten; 0 gemiste gevallen onder 20 positieve gevallen bewijst geen perfecte sensitiviteit.
- Operationele snelheid van ongeveer 60 seconden beschrijft onze interpretatiefunctie, niet een aangetoonde vermindering van diagnostische fouten of behandelingsvertragingen.
- Adoptiecriteria moeten betrekking hebben op veiligheid op patiëntniveau, prestaties per taal, invoerfouten en een gedocumenteerde reactie op softwarewijzigingen.
De opkomst van AI in medische diagnostiek: wat validatie inhoudt
Validatie van AI-bloedtesten vereist bewijs dat een specifieke softwareversie nauwkeurige, veilige interpretaties oplevert voor de beoogde patiënten en beslissingen. Kopers moeten patiëntspecifieke noemers, onafhankelijke tests, resultaten per subgroep en de afhandeling van fouten onderzoeken—niet alleen een opvallend nauwkeurigheidspercentage. Kantesti is een AI-bloedtestanalysator waarvan de resultaten aan dezelfde bewijsvereisten moeten voldoen.
Interpretatiesoftware meet het oorspronkelijke monster niet. Een laboratoriumanalysator genereert waarden zoals natrium van 138 mmol/L; interpretatiesoftware leest die waarden vervolgens uit en licht de mogelijke betekenis ervan toe, wat een tweede kans op fouten creëert, zelfs wanneer de laboratoriummeting correct is. Kopers hebben daarom afzonderlijk bewijs nodig voor de nauwkeurigheid van gegevensextractie, de verwerking van referentiewaarden en klinisch redeneren.
Klinische validiteit en klinische bruikbaarheid beantwoorden verschillende vragen. Een evaluatie kan overeenstemming aantonen bij 500 rapporten zonder aan te tonen dat patiënten betere zorg krijgen, onnodige onderzoeken vermijden of onzekerheid beter begrijpen. Onze gids voor het toelichten van medische rapporten legt uit waarom begrijpelijke formuleringen nog steeds broncontrole en passende grenzen voor escalatie vereisen.
Adoptiecijfers kunnen een klinische studie niet vervangen. Het door ons platform gerapporteerde bereik van 2M+ gebruikers in 127+ landen beschrijft het gebruik, niet een representatief validatiecohort met bevestigde uitkomsten. De bedrijfsachtergrond helpt de organisatorische verantwoordingsplicht vast te stellen; een afzonderlijk bewijsdossier moet het exacte beoogde gebruik, de in aanmerking komende populatie en de gevolgen van een onjuiste interpretatie vermelden.
Nauwkeurigheidsclaims: tel patiënten, rapporten en beslissingen afzonderlijk
Een nauwkeurigheidsclaim is alleen te interpreteren wanneer de teller, noemer en scoringsregels bekend zijn. Een cijfer zoals 98.49% kan betrekking hebben op geëxtraheerde velden, goedgekeurde uitspraken of geclassificeerde gevallen—heel verschillende taken. Hier is dat getal een voorbeeld van een opvallende claim die kritisch moet worden bekeken, geen onafhankelijk geverifieerd resultaat van klinische prestaties.
Herhaalde uitspraken zijn geen onafhankelijke patiënten. In een hypothetische evaluatie leveren 200 rapporten met elk 50 beoordeelde uitspraken 10.000 observaties op uitspraakniveau op, maar nog steeds slechts 200 rapporten. Een correcte toelichting van natrium van 140 mmol/L mag een gevaarlijke aanbeveling elders in hetzelfde rapport niet compenseren; eis zowel scoring op uitspraakniveau als het aandeel rapporten met klinisch relevante fouten.
Uitgesloten invoer kan de schijnbare betrouwbaarheid verhogen. Stel dat 1.000 rapporten worden ingediend, 100 worden afgewezen en 882 van de resterende 900 aan de beoordelingscriteria voldoen: de nauwkeurigheid onder de voltooide rapporten is 98%, terwijl het aandeel inzendingen dat een aanvaardbaar resultaat oplevert 88.2% is. Geen van beide noemers is per definitie misleidend, maar kopers hebben beide nodig, evenals de redenen voor afwijzing en de vraag of afgewezen gevallen onevenredig vaak urgente afwijkingen betreffen.
De gepubliceerde methodologie moet vastleggen wat als correct gold voordat de scoring begon. De STARD 2015-rapportagerichtlijn vraagt diagnostische-accuratesseonderzoeken de selectie van deelnemers, de referentiestandaard en de deelnemersstroom te beschrijven (Bossuyt et al., 2015). Onze pagina over validatiemethodologie is een uitgangspunt voor vragen over Kantesti; het mag niet worden beschouwd als bewijs van onafhankelijke prestaties op patiëntniveau zonder de onderliggende studiematerialen.
Sensitiviteit, specificiteit en voorspellende waarde beantwoorden verschillende vragen
Sensitiviteit meet de detectie onder referentiepositieve gevallen; specificiteit meet het aantal correcte negatieve uitslagen onder referentienegatieve gevallen. De positief voorspellende waarde geeft aan hoe vaak een positieve uitslag correct is in de geteste setting. Voor een hypothetische tool met een sensitiviteit van 90% en een specificiteit van 95% bij een prevalentie van 1% is de positief voorspellende waarde ongeveer 15.4%.
Een verwarringsmatrix maakt de afweging zichtbaar. Van 10.000 hypothetische patiënten bij een prevalentie van 1% hebben er 100 de aandoening in kwestie: 90 worden gedetecteerd en 10 gemist. Van de 9.900 patiënten die de aandoening niet hebben, krijgen 495 een fout-positieve uitslag; bijgevolg zijn slechts 90 van de 585 positieve uitslagen correct, ook al bedraagt de totale nauwkeurigheid 94.95%.
Precisie is geen universeel synoniem voor nauwkeurigheid. Bij classificatie betekent precisie doorgaans positief voorspellende waarde, terwijl een scoringsrubriek voor narratieve teksten van een leverancier het woord anders kan gebruiken. Onze bespreking van bevestiging van een laag-positieve antistofuitslag illustreert het klinische principe: de interpretatie hangt af van de voorafkans en bevestiging, en niet alleen van de vraag of een eerste uitslag een drempelwaarde overschrijdt.
De keuze van de drempelwaarde verandert de balans tussen gemiste gevallen en fout-positieve alarmen. Vraag om de verwarringsmatrix bij de voorgestelde inzetdrempel, niet alleen om een prestatiecurve die veel drempelwaarden bestrijkt. In een hypothetisch onderzoek naar een alarmsysteem kan het verlagen van een drempelwaarde van 0.7 naar 0.4 de sensitiviteit verhogen en tegelijk het aantal foutieve alarmen verdubbelen; kopers moeten bepalen of die afweging past bij de klinische gevolgen en de beschikbare beoordelingscapaciteit.
Onafhankelijke tests vereisen een beschermde dataset en een geloofwaardige referentiestandaard
Onafhankelijke toetsing evalueert een bevroren model op gegevens die tijdens de ontwikkeling niet beschikbaar waren, met openbaar gemaakte relaties van de beoordelaars en een klinisch verdedigbare referentiestandaard. Alleen externe gegevens garanderen geen onafhankelijke evaluatie. Een onderzoek met 3 ziekenhuizen kan nog steeds vertekende labels, gedeelde datapijplijnen of testgevallen bevatten die de modelafstemming hebben beïnvloed.
Scheiding op patiëntniveau voorkomt een veelvoorkomende vorm van datalekken. Als het rapport van januari van een patiënt in de trainingsset terechtkomt en dat van februari in de testset, kan het model voordeel hebben van terugkerende patronen of identificatoren. Kopers moeten vragen hoe dubbele patiënten, herhaalde ziekenhuisopnamen en rapporten uit 2 gekoppelde laboratoriumsystemen zijn geïdentificeerd, en of de definitieve testset onaangeroerd bleef nadat het model en de prompts waren geselecteerd.
De referentiestandaard moet overeenkomen met de claim. Overeenstemming tussen experts over 300 interpretaties kan de rapportkwaliteit beoordelen, maar bevestigt niet automatisch de aanwezigheid van een aandoening of toekomstige uitkomsten. Het onderscheid is bekend van de nauwkeurigheid en timing van assays: de geëvalueerde test, de comparator en het tijdstip van bevestiging kunnen elk de schijnbare prestaties veranderen.
Synthetische benchmarks testen geconstrueerde gevallen, niet de prevalentie van aandoeningen of de klinische bruikbaarheid in de praktijk. Zelfs 100,000 synthetische scenario's kunnen niet elke ontbrekende anamnese, artefact in een specimen of onverwachte presentatie nabootsen. Voor claims over de beperkingen van troponine-interpretatie, een onderzoek heeft de klinische informatie en diagnostische follow-up nodig die relevant zijn voor de claim; een correcte zin over een laboratoriumdrempel is geen bevestigde diagnose.
Prestaties per subgroep kunnen risico’s aan het licht brengen die verborgen blijven in het gemiddelde
Subgroepvalidatie toetst of de prestaties veranderen tussen klinisch relevante patiëntgroepen en invoeromstandigheden. Kopers moeten vragen om noemers, ernst van fouten en betrouwbaarheidsintervallen voor kinderen, ouderen, zwangeren, mensen met nierfunctiestoornissen en andere beoogde populaties. Nul gemiste gevallen bij 20 referentiepositieve gevallen laten aanzienlijke onzekerheid bestaan over het werkelijke percentage gemiste gevallen.
Leeftijdsspecifieke referentie-intervallen zijn niet onderling uitwisselbaar. Een interpretatie voor kinderen kan niet veilig elke volwassenendrempel overnemen, zelfs wanneer de onderliggende analyt en eenheid identiek zijn. Onze gids over AI-interpretatie voor kinderen legt de veiligheidsgrens uit; kopers moeten vragen om de werkelijke aantallen per leeftijdsgroep in plaats van een brede claim te accepteren die patiënten van 1 tot 18 jaar omvat.
Biologische context is belangrijker dan demografische vuistregels. Een absoluut neutrofielenaantal van 1.2 × 10^9/L kan een andere benadering vereisen bij een stabiel persoon met een Duffy-null-geassocieerd aantal dan bij iemand met een nieuwe daling tijdens de behandeling. De uitleg over Duffy-null-neutrofielen ondersteunt een gerichte testcasus; afkomst alleen mag niet worden gebruikt om een genotype of klinische veiligheid te veronderstellen.
Kleine steekproeven kunnen klinisch relevante foutpercentages verhullen. De benaderende regel van drie betekent dat 0 waargenomen gebeurtenissen bij 20 onafhankelijke observaties overeenkomt met een bovengrens van ongeveer 95%, niet 0%. Voor subgroepvergelijkingen is ook een analyse nodig waarbij rekening wordt gehouden met patiëntclusters wanneer rapporten herhaaldelijk voorkomen; een onderzoek moet niet-geteste groepen vermelden in plaats van een niet-significant verschil te behandelen als bewijs dat de prestaties gelijkwaardig zijn.
Meertalige ondersteuning vereist taalspecifieke veiligheidstests
Meertalige validatie toetst of de klinische betekenis behouden blijft bij vertaling, getalnotatie en uitleg voor patiënten in elke beoogde taal. Kantesti is een AI-platform voor de interpretatie van bloedonderzoek met ondersteuning voor 100+ talen; die mogelijkheid stelt op zichzelf geen gelijkwaardige klinische prestaties in die talen vast. Elke taal vereist een passende evaluatiestrategie en transparante informatie over de dekking.
Decimale conventies kunnen de geïnterpreteerde waarde veranderen. Een glucoseuitslag die in de ene regio wordt geschreven als 5,6 mmol/L mag na extractie niet 56 mmol/L worden, en een eenheidsconversie moet de klinische betekenis behouden in plaats van alleen leestekens te vervangen. Evalueer invoer in de oorspronkelijke taal en vertaalde outputs afzonderlijk; alleen Engelstalige laboratoriumrapporten testen die in 10 talen zijn vertaald, mist fouten aan de invoerkant.
Ontkenningen en uitslagtypen verdienen specifieke testgevallen. Formuleringen zoals niet aangetoond, onder de kwantificeringsgrens en kan niet worden uitgesloten geven verschillende gradaties van zekerheid aan. Onze kwalitatieve versus kwantitatieve gids legt het onderscheid uit; een tweetalig beoordelingskader moet deze betekenissen toetsen, inclusief ongelijkheidssymbolen zoals kleiner dan 0.1, in plaats van alleen vloeiend taalgebruik te belonen.
Leesbaarheid garandeert geen begrip. Bij een nuttige taalevaluatie zouden deelnemers bijvoorbeeld na het lezen van 3 korte rapporten de vereiste actie en onzekerheid kunnen aanwijzen, terwijl wordt vastgelegd of de vertaling de urgentie of het medicatieadvies verandert. Dit zijn voorgestelde evaluatietaken, geen gevalideerde universele drempel; talen met minder middelen hebben mogelijk aanvullende beoordeling nodig omdat de beschikbare klinische terminologie en trainingsdekking verschillen.
API-integratie en rapportage-indelingen moeten de klinische betekenis behouden
Integratievalidatie toetst of patiëntidentiteit, waarden, eenheden, datums en waarschuwingen correct blijven wanneer ze systeemgrenzen passeren. HTML-, JSON- en PDF-outputs moeten dezelfde klinische inhoud overbrengen wanneer deze formaten worden ondersteund. De betekenis van een natriumuitslag van 128 mmol/L mag niet veranderen doordat in de ene output een waarschuwing ontbreekt of in een andere een veld wordt afgekapt.
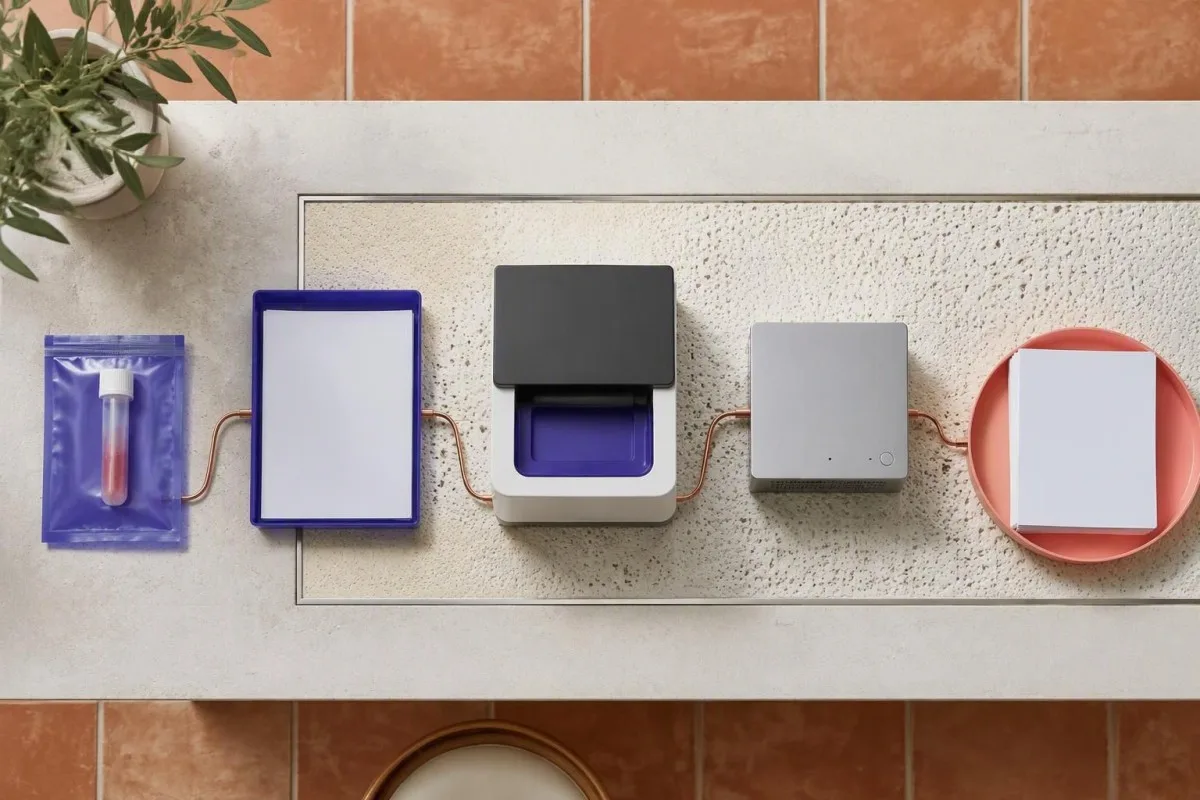
Een werkende API-verbinding is geen gevalideerde klinische integratie. Onze B2B-API vereist implementatiespecifieke controles van mapping, authenticatie, responsafhandeling en versiegedrag; compatibiliteit met een EPD of LIS moet voor de daadwerkelijke interface worden aangetoond. Test ten minste 3 foutklassen—ontbrekende eenheden, niet-overeenkomende patiëntidentificatoren en vertraagde dubbele reacties—in plaats van genoegen te nemen met één succesvolle demonstratieaanvraag.
Afgeleide waarden vereisen expliciete invoerwaarden en herleidbaarheid van de formule. Gecorrigeerd natrium is bijvoorbeeld afhankelijk van het gemeten natrium, glucose en de correctiemethode; verschillende gepubliceerde coëfficiënten kunnen uiteenlopende schattingen opleveren. Onze handleiding voor natriumcorrectie bij glucose biedt een klinisch testgeval, maar kopers moeten controleren of glucose in mg/dL nooit als mmol/L wordt behandeld en of bij elke berekening de aannames worden vermeld.
Een formaatde afspraak moet ook de betekenis omvatten, niet alleen de lay-out. Bij een hypothetische exporttest van 300 rapporten kan JSON een kritieke markering behouden, terwijl een PDF-sjabloon die onder een pagina-einde verbergt. Vergelijk klinische aanbevelingen, onzekerheid, eenheden en tijdstempels tussen ondersteunde uitvoerformaten; zorg dat ruwe waarden herleidbaar blijven tot de bron en leg vast of een ontbrekend veld leidt tot een veilige afwijzing of een niet-onderbouwde interpretatie.
Snelle rapporten en een gebruiksvriendelijke interface vereisen nog steeds bewijs op het gebied van menselijke factoren
Snelheid en gebruiksgemak zijn operationele voordelen, geen direct bewijs van diagnostische nauwkeurigheid. Onze interpretatiefunctie genereert doorgaans binnen ongeveer 60 seconden een toelichting, maar bij klinische implementatie moeten de end-to-endvertraging, mislukte aanvragen en beoordelingslast worden gemeten. Alleen de mediane verwerkingstijd kan niet aantonen of urgente resultaten de juiste persoon veilig bereiken.
De latentie moet als een verdeling worden gerapporteerd. Vraag naar de mediaan, het 95e percentiel en het time-outpercentage bij realistisch gelijktijdig gebruik, inclusief grote bestanden en foto's van slechte kwaliteit. Een hypothetische mediaan van 45 seconden met een 95e percentiel van 240 seconden beschrijft een heel andere dienstverlening dan een dienst die consequent binnen ongeveer 60 seconden klaar is; geen van beide cijfers bewijst dat de behandeling eerder start.
Urgente laboratoriumuitslagen vereisen een geteste presentatie en escalatie. Een kaliumuitslag van 6,5 mmol/L kan op een medisch noodgeval wijzen, hoewel de kwaliteit van het monster en de klinische context van invloed zijn op de interpretatie. Onze handleiding voor urgente elektrolytuitslagen ondersteunt het ontwerpen van scenario's; patiënten met een urgente laboratoriumwaarschuwing moeten direct contact opnemen met de behandelende zorgverlener in plaats van te wachten op een toelichting in een app, vooral wanneer er symptomen zijn.
Tests van menselijke factoren meten wat gebruikers met het rapport doen. Bij toegang via web, iOS, Android en extensies moeten kopers ten minste 3 taken onderzoeken: de oorspronkelijke waarde vinden, onzekerheid herkennen en de volgende passende actie bepalen. Registreer ook onjuiste handelingen, naast de voltooiingstijd, omdat een gepolijste interface het vertrouwen in een niet-onderbouwde aanbeveling kan vergroten en automatiseringsbias moeilijker herkenbaar kan maken.
Bewijs voor beveiliging en privacy hoort naast klinische validatie
De privacybeoordeling verifieert hoe gevoelige laboratoriumgegevens worden verzameld, verwerkt, bewaard, gedeeld en verwijderd. GDPR-conforme verwerking is een geformuleerde aanpak, geen vervanging voor contractueel en technisch bewijs. Voor Kantesti Ltd, UK Company No. 17090423, moeten kopers vóór het verzenden van zelfs maar 1 identificeerbaar rapport de toepasselijke relatie en verantwoordelijkheden tussen verwerkingsverantwoordelijke en verwerker vaststellen.
Gezondheidsinformatie vraagt om meer dan het verwijderen van een naam. Een rapport kan een barcode, exacte geboortedatum, aanvraagnummer of beschrijvend detail bevatten waarmee iemand in combinatie met andere informatie kan worden geïdentificeerd. Onze voorzorgsmaatregelen voor privacy bij uploads praktische dataminimalisatie toelichten; een koper moet ten minste 3 lagen afzonderlijk beoordelen: bestandsinhoud, accountmetadata en operationele logboeken.
Beveiligingsclaims moeten een duidelijk omschreven reikwijdte en bewijsdatum hebben. Bekijk de afspraken over versleuteling, toegangscontroles, lijsten van subverwerkers, voorwaarden voor incidentmeldingen en instellingen voor gegevensbewaring in de documentatie over gegevensprivacy. Als een leverancier naar een audit verwijst, vraag dan op welke dienst en controleperiode deze betrekking heeft; een rapport over 1 infrastructuurcomponent beoordeelt niet automatisch de toegang tot klinische toepassingen of de omgang met modelgegevens.
Internationale implementatie brengt aanvullende verplichtingen met zich mee. Gebruik in landen die onder 127+ vallen, betekent niet dat één contract of rechtsgrondslag voor elk rechtsgebied geldt, en overeenstemming met de GDPR impliceert niet dat HIPAA van toepassing is of dat aan de vereisten ervan is voldaan. Test bij gezinsfuncties de toestemmingsgrenzen met 2 afzonderlijke accounts, inclusief het intrekken van toegang en accountherstel; er moet expliciet worden aangegeven of het verwijderen van een rapport ook back-ups en logboeken verwijdert.
De AI-engine: valideer voorspellingen en aanbevelingen afzonderlijk
Een AI-engine heeft claim-specifieke validatie nodig voor patrooninterpretatie, voorspelling van toekomstige risico's en gepersonaliseerde aanbevelingen. Dit zijn verschillende taken, ook wanneer ze in 1 rapport worden gegenereerd. De architectuur van deep learning en analyse van meerdere parameters beschrijven hoe een systeem werkt; ze bewijzen niet dat de waarschijnlijkheidsschattingen, diagnostische suggesties of voedingsadviezen klinisch betrouwbaar zijn.
Interpretatie van meerdere parameters moet ruimte laten voor alternatieve verklaringen. In een hypothetisch rapport met ferritine van 40 ng/mL en CRP van 20 mg/L kan ferritine alleen de vraag naar de beschikbaarheid van ijzer niet beantwoorden, omdat ferritine kan stijgen als gevolg van een acutefaserespons. Kopers die het neurale netwerk van Kantesti beoordelen, moeten zulke contextgevoelige gevallen gebruiken, terwijl de technologie-uitleg gescheiden blijft van bewijs dat een specifieke klinische conclusie juist is.
Voor risicovoorspelling moeten de uitkomst en tijdshorizon duidelijk zijn omschreven. Een waarschijnlijkheid van 20% is niet te interpreteren zonder te vermelden wat er kan gebeuren, bij wie en binnen welke periode—bijvoorbeeld ziekenhuisopname binnen 30 dagen in plaats van het ontstaan van een ziekte binnen 5 jaar. TRIPOD+AI beveelt transparante rapportage aan voor onderzoeken naar voorspellingsmodellen (Collins et al., 2024); kalibratie en externe validatie zijn van belang, ook voor trendanalyse in verband met medicatie.
Gepersonaliseerd advies brengt een afzonderlijke veiligheidsverplichting met zich mee. Een voedingsaanbeveling kan ongepast zijn wanneer informatie over de nierfunctie, medicatie of een zwangerschap ontbreekt; Family Health Risk vereist eveneens een duidelijke aanpak van onzekere of zelfgerapporteerde medische voorgeschiedenis. Onze nier voedingsveiligheidsgids biedt relevante testscenario's, maar de aanvaarding van een maaltijdplan met 3 items bewijst niet dat dit de uitkomsten verbetert of een individuele beoordeling door een diëtist veilig vervangt.
Hoe AI-bloedonderzoek uitslag werkt: een validatiechecklist voor kopers
Een koper moet de volledige reeks testen: gegevensinvoer, normalisatie, contextuele interpretatie, rapportgeneratie en klinische beoordeling. Beoordeel elke stap afzonderlijk voordat u het gecombineerde systeem test. Met een acceptatieplan van 5 fasen is gemakkelijker vast te stellen of een onveilige uitvoer is begonnen met een verkeerd gelezen waarde, een onjuiste aanname of een ongepaste aanbeveling.
Begin met het definiëren van het beoogde gebruik en het vastleggen van de geëvalueerde versie. Stap 1 is een schriftelijke inventarisatie van claims en risico's; stap 2 is een vergrendelde, representatieve dataset met vooraf vastgestelde geschiktheidscriteria en referentielabels. Test vervolgens het vastleggen van pdf's of foto's met aangepaste lay-outs, decimaalnotaties en onleesbare velden; documenteer weigeringen in plaats van ze stilzwijgend uit de uiteindelijke noemer uit te sluiten.
Test vervolgens de aannames over context en longitudinale gegevens. Stap 3 controleert eenheden, referentie-intervallen en metadata; stap 4 beoordeelt interpretaties en aanbevelingen aan de hand van klinisch betekenisvolle ernstcategorieën. Onze gids voor veranderingen tussen laboratoriumbezoeken vormt een nuttige uitdaging: bij een creatinineverandering van 80 naar 100 µmol/L moet rekening worden gehouden met de timing, assayvariatie en de patiënt, en mag niet automatisch worden geconcludeerd dat er sprake is van verslechtering.
Sluit af met een implementatiebesluit, niet met een slogan over nauwkeurigheid. Stap 5 beoordeelt het toekomstige lokale gebruik en de afhandeling van fouten aan de hand van criteria die zijn overeengekomen voordat de resultaten worden bekeken, waaronder onzekerheidsmarges en het escalatiegedrag. Vraag om een dossier met daarin het cohortverloop, de modelversie, het volledige beoordelingsschema, tabellen per subgroep, voorbeelden van schadelijke output en regels voor wijzigingsbeheer; geen universeel percentage kan acceptatiedrempels vervangen die zijn afgestemd op de gevolgen van fouten.
Voorbeeldrapporten en getuigenissen: maak onderscheid tussen illustratie en bewijs
Een voorbeeldrapport laat de presentatie en redenering zien, terwijl een testimonial een individuele indruk beschrijft. Geen van beide toont de nauwkeurigheid op patiëntniveau of klinische voordelen aan. Neem een duidelijk hypothetische volwassene van 52 jaar met een creatinine van 118 µmol/L, een gerapporteerde eGFR van 58 mL/min/1,73 m² en geen beschikbare eerdere uitslagen: de veilige uitleg moet de onzekerheid behouden.
Eén verlaagde eGFR stelt geen chronische nierziekte vast. KDIGO definieert chronische nierziekte aan de hand van afwijkingen in de structuur of functie van de nieren die ten minste 3 maanden aanwezig zijn; een eGFR lager dan 60 mL/min/1,73 m² vereist beoordeling van de chroniciteit en context (KDIGO CKD Work Group, 2024). In dit hypothetische voorbeeld moet een rapport een beoordeling door een arts en passende follow-up voorstellen, en geen blijvende nierschade diagnosticeren op basis van één uitslag.
Schattingen op basis van creatinine kunnen minder informatief zijn bij een ongebruikelijke lichaamssamenstelling. Als de hypothetische persoon erg gespierd is of onlangs het gebruik van supplementen heeft gewijzigd, moet de interpretatie die factoren benoemen in plaats van de uitslag terzijde te schuiven. Onze bespreking van creatinine bij gespierde volwassenen biedt context; KDIGO ondersteunt, waar beschikbaar, schattingen op basis van creatinine en cystatine C voor passende beoordeling van CKD bij volwassenen, in plaats van ervan uit te gaan dat de eerste schatting definitief is.
Demonstraties moeten ook moeilijke invoer en ongunstige uitkomsten bevatten. Voeg een afzonderlijke hypothetische kaliumuitslag van 6.0 mmol/L toe met een gemarkeerd probleem met het monster, en gebruik onze beperkingen van uitslagen in verband met hemolyse om uit te leggen waarom zowel bevestiging als urgentie in overweging moeten worden genomen. Voor Kantesti is een geblindeerde vergelijking van volledige rapporten een zinvolle evaluatie; professionele testimonials blijven, indien met toestemming gepresenteerd, op ervaring gebaseerde feedback en zijn geen vervanging voor dergelijke tests.
De toekomst van diagnostiek omarmen: onderbouwde invoering
Gebruik AI-interpretatie alleen voor toepassingen die door bewijs worden ondersteund, met lokaal toezicht en een gedocumenteerde aanpak voor fouten. Kantesti is een AI-tool voor de analyse van bloedtesten; ons functieaanbod moet worden beoordeeld aan de hand van dezelfde inkoopnormen die hier worden beschreven. Beginnen met 1 beperkt gebruiksscenario is veiliger dan aannemen dat het bewijs geldt voor iedere patiënt en aanbeveling.
Een gefaseerde introductie moet haalbaarheid onderscheiden van effectiviteit. Een hypothetische schaduwbeoordeling van 100 rapporten kan integratiefouten en veelvoorkomende problemen met de formulering aan het licht brengen zonder patiënten bloot te stellen aan niet-beoordeelde aanbevelingen, maar zal waarschijnlijk geen lage frequentie van zeldzame ernstige fouten aantonen. Voor een bredere prospectieve evaluatie is een onderbouwing van de steekproefomvang nodig, evenals uitkomsten die aansluiten op de daadwerkelijke claim, waaronder onnodige follow-up en gemiste aandachtspunten.
Softwarewijzigingen kunnen eerder gemeten prestaties veranderen. Een nieuw model, een nieuwe prompt, een nieuwe database met referentiewaarden of een nieuw rapportsjabloon kan de output veranderen, ook als de productnaam hetzelfde blijft; leg alle 4 categorieën vast in de implementatiegeschiedenis. Monitor de ernst van fouten, onthoudingen, verschuivingen tussen subgroepen en door gebruikers overschreven adviezen, en bepaal wanneer een wijziging aanleiding geeft tot gerichte regressietests, een hernieuwde lokale evaluatie of opschorting van een specifieke functie.
Het besluit tot invoering moet steunen op een schriftelijke analyse van bewijslacunes. Bepaal wat onafhankelijk is vastgesteld, wat alleen door technische tests wordt ondersteund en wat nog niet is getest; wijs vervolgens voor elk onopgelost risico een verantwoordelijke aan. Onze contactkanaal voor zorginkopers is de juiste plek om documentatie voor een specifieke reikwijdte aan te vragen—geef de voorkeur aan een beperktere, onderbouwde claim boven een 99%-kop met een onduidelijke noemer.
Onderzoekspublicaties: maak onderscheid tussen educatieve gidsen en validatiestudies
De onderstaande 2 DOI-verwijzingen naar repositories identificeren educatieve gidsen, geen klinische validatiestudies van AI-interpretatiesoftware. Een DOI biedt een permanente identificatiecode; deze toont geen peerreview, patiëntrekrutering, onafhankelijke evaluatie of klinische effectiviteit aan. Kopers moeten elke aangehaalde publicatie indelen op basis van de vraag die deze daadwerkelijk kan beantwoorden.
Educatieve gidsen kunnen helpen bij het opstellen van een validatierubric, zonder het product zelf te valideren. Ons helpt het complement- en ANA-onderzoek kan informatie bieden over gevallen waarin 2 complementmetingen en de context van antistoffen zorgvuldig moeten worden toegelicht. Overeenstemming met een gids is niet hetzelfde als overeenstemming met onafhankelijk beoordeelde patiëntuitkomsten, vooral wanneer de gids en de geëvalueerde software dezelfde organisatorische bron hebben.
Gidsen over diagnostische timing behandelen een andere nuttige faalmodus. Ons Nipah diagnostische testgids bespreekt een gespecialiseerde diagnostische context; het mag niet worden gebruikt om te suggereren dat routinematige laboratoriuminterpretatie een bepaald virus identificeert. Als een koper zelfs maar 1 claim over een pathogeen met ernstige gevolgen opneemt in het beoogde gebruik, heeft die claim eigen relevant diagnostisch bewijs en passende grenzen voor escalatie nodig.
Normen voor rapportage van studies ondersteunen de beoordeling, maar certificeren de prestaties niet. STARD 2015 bevat 30 rapportage-items voor onderzoek naar diagnostische nauwkeurigheid, terwijl TRIPOD+AI betrekking heeft op de rapportage van voorspellingsmodellen; geen van beide checklists verleent software een klinisch goedkeuringsstempel. De onderstaande referenties scheiden die methodologische bronnen en de KDIGO-richtlijn uit 2024 van de 2 educatieve DOI-vermeldingen, zodat lezers klinische aanbevelingen, rapportagerichtlijnen en productspecifiek bewijs van elkaar kunnen onderscheiden.
Veelgestelde vragen
Wat is klinische validatie van AI-software voor bloedtests?
Klinische validatie beoordeelt of een gespecificeerde softwareversie voor AI-bloedtests voldoende nauwkeurige en veilige resultaten oplevert voor de beoogde patiënten en beslissingen. Daarbij moeten ten minste 3 taken van elkaar worden onderscheiden: het lezen van het brondocument, het interpreteren van de klinische betekenis en het aanbevelen van een actie. Het bewijs moet de referentiestandaard, de steekproefomvang op patiëntniveau, onafhankelijke tests en de afhandeling van fouten beschrijven. Een technisch correcte uitleg bewijst op zichzelf niet dat de patiëntuitkomsten zijn verbeterd.
Is de nauwkeurigheid van 99% voldoende om een AI-bloedtestanalysator te vertrouwen?
Een nauwkeurigheidsclaim van 99% kan de veiligheid niet aantonen zonder de noemer, de taakdefinitie en de ernst van fouten. In een hypothetische groep waarin slechts 1% de betreffende aandoening heeft, behaalt software die iedereen als negatief bestempelt een nauwkeurigheid van 99%, terwijl geen enkele getroffen patiënt wordt herkend. Kopers moeten vragen om de sensitiviteit, specificiteit, fouten in rapporten op patiëntniveau en het aantal afgewezen invoeren. Zeldzame maar gevaarlijke aanbevelingen mogen niet verdwijnen in een gemiddelde dat wordt gedomineerd door eenvoudige uitspraken.
Wat is het verschil tussen een synthetische benchmark en klinische validatie?
Een synthetische benchmark evalueert software op geconstrueerde gevallen, terwijl klinische validatie bewijs vereist dat passend is voor de beoogde patiëntenpopulatie en klinische claim. Zelfs 100.000 synthetische gevallen kunnen geen bewijs leveren voor de prevalentie in de praktijk, het klinische voordeel of de prestaties bij elk probleem rond ontbrekende voorgeschiedenis en de kwaliteit van specimens. Synthetische tests kunnen helpen technische fouten op te sporen en regressietests ondersteunen. Ze moeten een representatieve externe en prospectieve evaluatie aanvullen, niet vervangen.
Hoeveel onafhankelijke tests heeft AI in de gezondheidszorg nodig?
0 Gezondheidszorg-AI moet onafhankelijk worden getest, in verhouding tot de gevolgen van een onjuiste uitkomst, en niet aan de hand van een universeel minimumaantal rapporten. Bij 0 fouten in 100 onafhankelijke gevallen blijft de benaderde bovengrens van het foutpercentage volgens de regel van drie bijna 3%, met een geschatte onzekerheid van 95%. Kopers moeten vragen om beschermde testgegevens, een bevroren modelversie en openbaarmaking van relaties met beoordelaars. Voor claims over zeldzame ernstige fouten is doorgaans meer bewijs nodig dan een kleine bruikbaarheids- of haalbaarheidspilot kan leveren.
Betekent ondersteuning voor 100 talen gelijke nauwkeurigheid in elke taal?
0 Ondersteuning voor 100 talen bewijst niet dat de klinische nauwkeurigheid in al die talen gelijk is. Taalgerichte evaluatie moet de extractie van invoer, decimaalnotaties, eenheden, negaties en de betekenis van aanbevelingen toetsen. Glucose die bijvoorbeeld als 5,6 mmol/L is geschreven, mag niet worden geïnterpreteerd als 56 mmol/L. Kopers moeten taalgerichte noemers opvragen en vermelden welke talen geen klinische beoordeling hebben ondergaan.
Kan AI chronische nierziekte diagnosticeren op basis van één lage eGFR-uitslag?
Eén eGFR-resultaat lager dan 60 mL/min/1.73 m² stelt op zichzelf geen chronische nierziekte vast. De KDIGO-richtlijn van 2024 definieert chronische nierziekte aan de hand van nierafwijkingen die gedurende ten minste 3 maanden aanwezig zijn, waarbij rekening wordt gehouden met de chroniciteit en de klinische context. Acute veranderingen, lichaamssamenstelling en andere factoren kunnen de interpretatie beïnvloeden. AI-software moet de onzekerheid uitleggen en de follow-up door de arts ondersteunen, in plaats van één verlaagde schatting als een blijvende aandoening te bestempelen.
Laat uw bloedwaarden begrijpen
Upload uw laboratoriumrapport en de AI van Kantesti legt elke biomarker binnen enkele seconden uit in begrijpelijke taal. Wereldwijd gebruikt door meer dan 2 miljoen mensen.
Referenties
- Klein, T., Mitchell, S., & Weber, H. (2025). Gids voor C3-, C4-complementbloedtesten en ANA-titers. Kantesti AI Medisch Onderzoek. DOI
- Klein, T., Mitchell, S., & Weber, H. (2025). Nipah-virusbloedtest: gids voor vroege detectie en diagnose 2026. Kantesti AI Medisch Onderzoek. DOI
- Bossuyt PM et al. (2015). STARD 2015: een bijgewerkte lijst van essentiële items voor de rapportage van onderzoeken naar diagnostische nauwkeurigheid. BMJ. DOI PubMed
- Collins GS et al. (2024). TRIPOD+AI-verklaring: bijgewerkte richtlijnen voor de rapportage van klinische voorspellingsmodellen die regressie- of machinelearningmethoden gebruiken. BMJ. DOI
- Kidney Disease: Improving Global Outcomes (KDIGO) CKD Work Group (2024). KDIGO-richtlijn voor de klinische praktijk 2024 voor de evaluatie en behandeling van chronische nierziekte. Kidney International. DOI
- 2M+Geanalyseerde tests
- 127+Landen
- 100+Talen
Over het medische team


E-E-A-T Vertrouwenssignalen
Ervaring
Klinische beoordeling door artsen van lab-interpretatieworkflows.
Expertise
Laboratoriumgeneeskunde met focus op hoe biomarkers zich gedragen in een klinische context.
Gezag
Medisch beoordeeld door Dr. Thomas Klein, met bijdragen van Dr. Sarah Mitchell en Prof. Dr. Hans Weber.
Betrouwbaarheid
Evidence-based interpretatie met duidelijke vervolgstappen om onrust te verminderen.
Medische disclaimer
Dit artikel is uitsluitend bedoeld voor educatieve doeleinden en vormt geen medisch advies. Raadpleeg altijd een gekwalificeerde zorgverlener voor beslissingen over diagnose en behandeling.
Gepubliceerd · Bijgewerkt · Neem contact op met het redactieteam
Uitgegeven door Kantesti Ltd, geregistreerd in Engeland en Wales, bedrijfsnr. 17090423, Londen, Verenigd Koninkrijk.
