
Walidacja kliniczna oznacza sprawdzenie, czy oprogramowanie dostarcza wystarczająco dokładnych i bezpiecznych interpretacji dla pacjentów, dla których jest przeznaczone — a nie tylko tego, czy generuje przekonujące raporty.

Najważniejsze wnioski
- Zakres walidacji musi określać docelowych pacjentów, dane laboratoryjne i decyzje kliniczne; sukces w 1 zadaniu nie potwierdza bezpieczeństwa we wszystkich zastosowaniach.
- Mianowniki dokładności powinny rozróżniać pacjentów, raporty, biomarkery i poszczególne stwierdzenia; 10 000 stwierdzeń może pochodzić z zaledwie 200 raportów.
- Wrażliwość mierzy wykryte przypadki dodatnie według standardu referencyjnego; hipotetyczny wynik 90/100 oznacza, że przeoczono 10 przypadków choroby.
- Wartość predykcyjna zależy od częstości występowania: przy częstości występowania 1% czułość 90% i swoistość 95% dają dodatnią wartość predykcyjną wynoszącą około 15,4%.
- Niezależne testowanie wymaga chronionych danych testowych, zamrożonej wersji oprogramowania oraz ujawnienia, kto zaprojektował, sfinansował i rozstrzygał wyniki oceny.
- Dowody dotyczące podgrup musi uwzględniać liczebność próby i niepewność; zaobserwowanie 0 pominięć wśród 20 przypadków pozytywnych nie dowodzi doskonałej czułości.
- Szybkość działania wynosząca około 60 sekund opisuje naszą funkcję interpretacji, a nie udowodnione ograniczenie liczby błędów diagnostycznych lub opóźnień w leczeniu.
- Kryteria wdrożenia powinny obejmować bezpieczeństwo na poziomie pacjenta, skuteczność w poszczególnych językach, błędy danych wejściowych oraz udokumentowaną reakcję na zmiany oprogramowania.
Rozwój AI w diagnostyce medycznej: co oznacza walidacja
Walidacja AI blood test wymaga dowodów, że określona wersja oprogramowania zapewnia dokładne i bezpieczne interpretacje dla docelowych pacjentów i decyzji. Kupujący powinni sprawdzać mianowniki na poziomie pacjenta, niezależne testy, wyniki dla podgrup i obsługę błędów — a nie wyłącznie nagłówek z procentową wartością dokładności. Kantesti to analizator AI blood test, którego wyniki powinny podlegać tym samym wymogom dowodowym.
Oprogramowanie interpretacyjne nie mierzy pierwotnej próbki. Analizator laboratoryjny generuje wartości, takie jak stężenie sodu wynoszące 138 mmol/L; oprogramowanie interpretacyjne odczytuje następnie te wartości i wyjaśnia ich możliwe znaczenie, stwarzając kolejną możliwość wystąpienia błędu, nawet gdy pomiar laboratoryjny jest prawidłowy. Dlatego kupujący potrzebują odrębnych dowodów dotyczących dokładności ekstrakcji, obsługi zakresów referencyjnych i rozumowania klinicznego.
Trafność kliniczna i użyteczność kliniczna odpowiadają na różne pytania. Ocena może wykazać zgodność w 500 raportach, nie wykazując, że pacjenci otrzymują lepszą opiekę, unikają niepotrzebnych badań lub trafniej rozumieją niepewność. Nasz przewodnik po objaśnianiu raportów medycznych wyjaśnia, dlaczego zrozumiałe sformułowania nadal wymagają sprawdzenia źródeł i odpowiednich granic eskalacji.
Statystyki wdrożeń nie mogą zastąpić badania klinicznego. Zasięg naszej platformy, wynoszący 2M+ użytkowników w 127+ krajach, opisuje sposób korzystania, a nie reprezentatywną kohortę walidacyjną z potwierdzonymi wynikami. Dokument tło firmy pomaga ustalić odpowiedzialność organizacyjną; odrębna dokumentacja dowodowa musi określać dokładne przeznaczenie, kwalifikującą się populację oraz konsekwencje błędnej interpretacji.
Deklaracje dotyczące dokładności: osobno licz pacjentów, raporty i decyzje
Twierdzenie o dokładności można zinterpretować tylko wtedy, gdy ujawniono licznik, mianownik i zasady oceny. Wartość taka jak 98.49% może dotyczyć wyodrębnionych pól, zaakceptowanych stwierdzeń lub sklasyfikowanych przypadków — bardzo różnych zadań. Podana liczba jest tu przykładem wartości nagłówkowej wymagającej weryfikacji, a nie niezależnie potwierdzonym wynikiem skuteczności klinicznej.
Powtarzające się stwierdzenia nie oznaczają niezależnych pacjentów. W hipotetycznej ocenie 200 raportów zawierających po 50 ocenianych stwierdzeń daje 10 000 obserwacji na poziomie stwierdzeń, ale nadal tylko 200 raportów. Prawidłowe objaśnienie stężenia sodu wynoszącego 140 mmol/L nie powinno równoważyć niebezpiecznego zalecenia w innym miejscu tego samego raportu; należy wymagać zarówno oceny na poziomie stwierdzeń, jak i odsetka raportów zawierających błędy o istotnych konsekwencjach klinicznych.
Wykluczanie danych wejściowych może zawyżać pozorną wiarygodność. Załóżmy, że przesłano 1,000 raportów, odrzucono 100, a 882 z pozostałych 900 spełniły kryteria oceny: dokładność wśród ukończonych raportów wynosi 98%, natomiast odsetek prawidłowych, akceptowalnych wyników wśród wszystkich zgłoszeń wynosi 88.2%. Żaden z tych mianowników nie jest z natury nieuczciwy, ale kupujący potrzebują obu, a także informacji o przyczynach odrzucenia i o tym, czy odrzucone przypadki nieproporcjonalnie często obejmują pilne nieprawidłowości.
Opublikowana metodologia powinna określać, co uznawano za poprawne, zanim rozpoczęto ocenę. Wytyczne STARD 2015 dotyczące raportowania wymagają, aby w badaniach dokładności diagnostycznej opisano dobór uczestników, standard referencyjny i przepływ uczestników (Bossuyt et al., 2015). Nasz strona metodologii walidacji stanowi punkt wyjścia do pytań dotyczących Kantesti; nie należy traktować go jako dowodu niezależnej skuteczności na poziomie pacjenta bez dostępu do materiałów źródłowych badania.
Czułość, swoistość i wartość predykcyjna odpowiadają na różne pytania
Czułość mierzy wykrywanie przypadków z wynikiem dodatnim według standardu referencyjnego; swoistość mierzy poprawne wyniki ujemne wśród przypadków z wynikiem ujemnym według standardu referencyjnego. Dodatnia wartość predykcyjna określa, jak często wynik dodatni jest prawidłowy w badanym środowisku. Dla hipotetycznego narzędzia o czułości 90% i swoistości 95% przy częstości występowania wynoszącej 1% dodatnia wartość predykcyjna wynosi około 15.4%.
Macierz pomyłek uwidacznia kompromis. Spośród 10 000 hipotetycznych pacjentów przy częstości występowania wynoszącej 1% docelowe schorzenie występuje u 100: 90 zostaje wykrytych, a 10 przeoczonych. Spośród 9 900 osób, u których ono nie występuje, 495 otrzymuje wyniki fałszywie dodatnie; w konsekwencji tylko 90 spośród 585 wyników dodatnich jest prawidłowych, mimo że ogólna trafność wynosi 94.95%.
Precyzja nie jest uniwersalnym synonimem trafności. W klasyfikacji precyzja zwykle oznacza dodatnią wartość predykcyjną, natomiast w narracyjnej skali punktowej dostawcy termin ten może mieć inne znaczenie. Nasze omówienie potwierdzania niskiego stężenia przeciwciał ilustruje zasadę kliniczną: interpretacja zależy od prawdopodobieństwa wstępnego i potwierdzenia, a nie jedynie od tego, czy początkowy wynik przekracza próg.
Wybór progu zmienia proporcje przypadków przeoczonych i wyników fałszywie alarmujących. Należy poprosić o macierz pomyłek dla proponowanego progu wdrożeniowego, a nie tylko o krzywą skuteczności obejmującą wiele progów. W hipotetycznym badaniu systemu alarmowego obniżenie progu z 0.7 do 0.4 mogłoby poprawić czułość, a jednocześnie podwoić liczbę fałszywych alarmów; nabywcy muszą zdecydować, czy taki kompromis odpowiada konsekwencjom klinicznym i możliwościom weryfikacji.
Niezależne testowanie wymaga chronionego zbioru danych i wiarygodnego standardu referencyjnego
Niezależne testowanie ocenia zamrożony model na danych niedostępnych podczas jego opracowywania, przy ujawnionych powiązaniach ewaluatorów i klinicznie uzasadnionym standardzie referencyjnym. Same dane zewnętrzne nie gwarantują niezależnej oceny. Badanie obejmujące 3 szpitale nadal może mieć obciążone etykiety, współdzielone potoki danych lub przypadki testowe, które wpłynęły na dostrajanie modelu.
Podział na poziomie pacjenta zapobiega częstej formie przecieku danych. Jeśli styczniowe sprawozdanie jednego pacjenta trafi do zbioru treningowego, a lutowe do testowego, model może korzystać z powtarzających się wzorców lub identyfikatorów. Nabywcy powinni zapytać, jak identyfikowano zduplikowanych pacjentów, ponowne przyjęcia i sprawozdania z 2 połączonych systemów laboratoryjnych oraz czy końcowy zbiór testowy pozostał nietknięty po wyborze modelu i promptów.
Standard referencyjny musi odpowiadać deklarowanemu zastosowaniu. Zgodność ekspertów w ocenie 300 interpretacji może służyć do oceny jakości sprawozdań, ale nie potwierdza automatycznie obecności choroby ani przyszłych wyników. To rozróżnienie jest dobrze znane z dokładności testu i czasu jego wykonania: test podlegający ocenie, metoda porównawcza i czas potwierdzenia mogą wpływać na pozorną skuteczność.
Benchmarki syntetyczne badają skonstruowane przypadki, a nie częstość występowania chorób w warunkach rzeczywistych ani użyteczność kliniczną. Nawet 100 000 syntetycznych scenariuszy nie odtworzy każdego brakującego wywiadu, artefaktu próbki ani nietypowego obrazu klinicznego. W przypadku deklaracji dotyczących ograniczeń interpretacji troponiny, badanie wymaga informacji klinicznych i obserwacji diagnostycznej odpowiednich dla danego twierdzenia; poprawne zdanie na temat progu laboratoryjnego nie stanowi potwierdzonego rozpoznania.
Wyniki w podgrupach mogą ujawnić ryzyko ukryte przez średnią
Testy walidacyjne podgrup sprawdzają, czy skuteczność zmienia się w różnych klinicznie istotnych grupach pacjentów i warunkach wejściowych. Kupujący powinni zażądać liczebności mianowników, ciężkości błędów i przedziałów ufności dla dzieci, osób starszych, kobiet w ciąży, osób z zaburzeniami czynności nerek i innych populacji docelowych. Zaobserwowanie 0 przeoczeń wśród 20 przypadków z dodatnim wynikiem referencyjnym pozostawia znaczną niepewność co do rzeczywistego odsetka przeoczeń.
Przedziały referencyjne właściwe dla wieku nie są wymienne. Interpretacja pediatryczna nie może bezpiecznie przejmować wszystkich progów dla dorosłych, nawet gdy analit i jednostka są identyczne. Nasz przewodnik po Interpretacja AI dla dzieci wyjaśnia granice bezpieczeństwa; kupujący powinni zażądać rzeczywistych liczebności w poszczególnych przedziałach wiekowych, zamiast akceptować ogólne twierdzenie obejmujące pacjentów w wieku od 1 do 18 lat.
Kontekst biologiczny ma większe znaczenie niż uproszczenia demograficzne. Bezwzględna liczba neutrofili wynosząca 1.2 × 10^9/L może wymagać innego podejścia u stabilnej osoby z liczbą związaną z fenotypem Duffy-null niż u osoby, u której podczas leczenia nastąpił jej niedawny spadek. wyjaśnienie dotyczące neutrofili z fenotypem Duffy-null stanowi podstawę do opracowania ukierunkowanego przypadku testowego; nie wolno na podstawie samego pochodzenia zakładać genotypu ani bezpieczeństwa klinicznego.
Małe próby mogą ukrywać klinicznie istotne wskaźniki niepowodzeń. Przybliżona reguła trzech oznacza, że 0 zaobserwowanych zdarzeń w 20 niezależnych obserwacjach odpowiada górnej granicy 95% w pobliżu 15%, a nie 0%. Porównania podgrup wymagają także analizy uwzględniającej grupowanie pacjentów, gdy raporty się powtarzają; badanie powinno ujawniać nieprzetestowane grupy, zamiast traktować nieistotną statystycznie różnicę jako dowód równoważnej skuteczności.
Obsługa wielu języków wymaga testów bezpieczeństwa dla każdego języka
Walidacja wielojęzyczna sprawdza, czy znaczenie kliniczne zostaje zachowane w tłumaczeniu, formatowaniu liczb i objaśnieniach dla pacjentów w każdym języku docelowym. Kantesti to platforma AI do interpretacji wyników badań krwi, obsługująca 100+ języków; sama ta funkcja nie potwierdza równoważnej skuteczności klinicznej w tych językach. Każdy język wymaga odpowiedniej strategii oceny i ujawnienia zakresu objętych nią treści.
Konwencje zapisu dziesiętnego mogą zmienić interpretowaną wartość. Wynik glukozy zapisany w jednej lokalizacji jako 5,6 mmol/L nie może po ekstrakcji zmienić się w 56 mmol/L, a przeliczenie jednostek musi zachować znaczenie kliniczne, a nie tylko zastąpić znak interpunkcyjny. Oceniaj osobno dane wejściowe w oryginalnym języku i przetłumaczone wyniki; testowanie wyłącznie angielskich raportów laboratoryjnych przetłumaczonych na 10 języków nie ujawnia błędów po stronie danych wejściowych.
Negacja i typ wyniku wymagają odrębnych przypadków testowych. Sformułowania takie jak „nie wykryto”, „poniżej granicy oznaczalności” i „nie można wykluczyć” komunikują różne stopnie pewności. Nasz przewodnik po metodach jakościowych i ilościowych wyjaśnia tę różnicę; dwujęzyczna rubryka oceny powinna sprawdzać te znaczenia, w tym symbole nierówności, takie jak „mniej niż 0.1”, zamiast oceniać wyłącznie płynność sformułowań.
Czytelność nie gwarantuje zrozumienia. Przydatna ocena językowa mogłaby polegać na poproszeniu uczestników o wskazanie wymaganych działań i stopnia niepewności po przeczytaniu 3 krótkich raportów, przy jednoczesnym odnotowaniu, czy tłumaczenie zmienia pilność lub zalecenia dotyczące leków. Są to proponowane zadania oceniające, a nie uniwersalny, zwalidowany próg; języki o mniejszych zasobach mogą wymagać dodatkowej weryfikacji ze względu na różnice w dostępnej terminologii klinicznej i zakresie szkoleń.
Integracja API i formaty raportów muszą zachować znaczenie kliniczne
Walidacja integracji sprawdza, czy tożsamość pacjenta, wartości, jednostki, daty i ostrzeżenia pozostają prawidłowe na granicach systemów. Wyniki HTML, JSON i PDF powinny przekazywać tę samą treść kliniczną, jeśli obsługiwane są te formaty. Wynik sodu wynoszący 128 mmol/L nie może zmienić znaczenia z powodu utraty ostrzeżenia w jednym formacie lub ucięcia pola w innym.
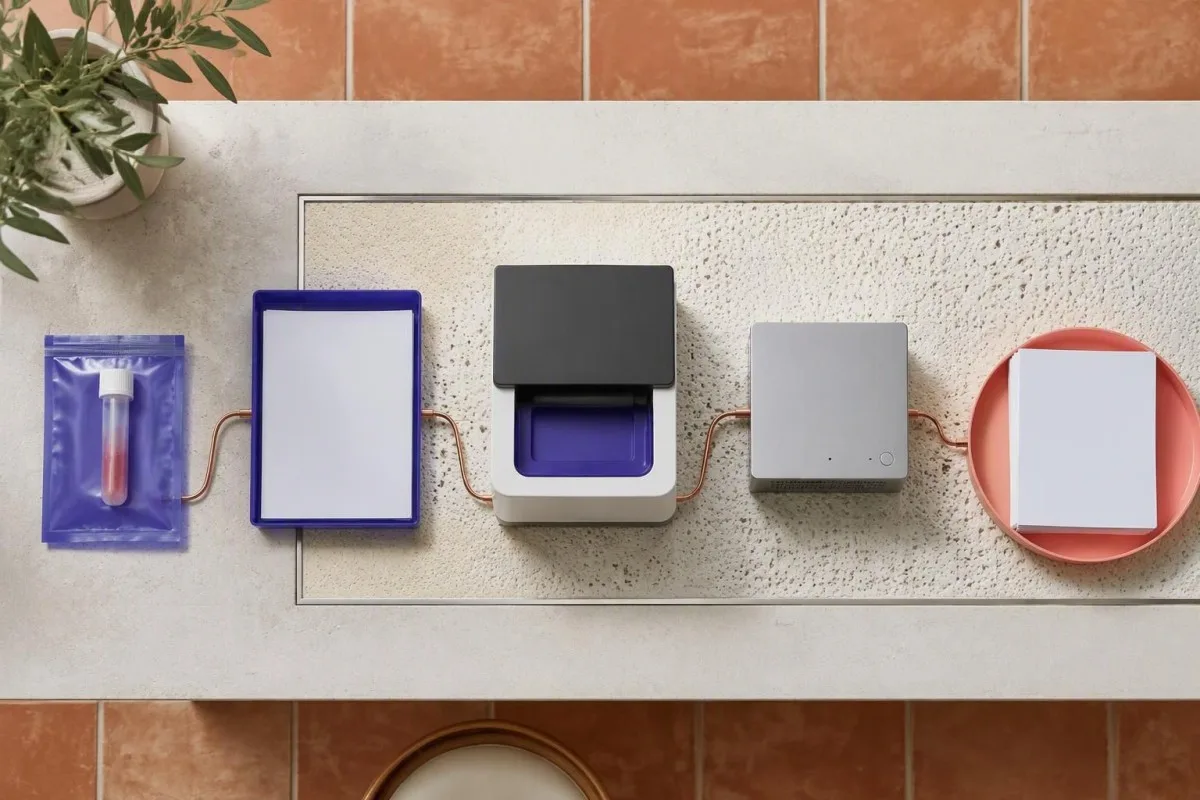
Działające połączenie API nie jest zwalidowaną integracją kliniczną. Nasze API B2B wymaga kontroli specyficznych dla wdrożenia w zakresie mapowania, uwierzytelniania, obsługi odpowiedzi i zachowania poszczególnych wersji; zgodność z systemami EHR lub LIS należy wykazać dla rzeczywistego interfejsu. Przetestuj co najmniej 3 klasy błędów — brak jednostek, niezgodne identyfikatory pacjenta i opóźnione zduplikowane odpowiedzi — zamiast uznawać jedną udaną demonstracyjną próbę za wystarczającą.
Wartości pochodne wymagają jawnego podania danych wejściowych i pochodzenia wzoru. Na przykład stężenie sodu po korekcie zależy od zmierzonego stężenia sodu, glukozy i zastosowanej metody korekty; różne opublikowane współczynniki mogą dawać różne szacunki. Nasz przewodnik po korekcie stężenia sodu związanej z glukozą zawiera kliniczny przypadek testowy, ale kupujący powinni sprawdzić, czy glukoza podana w mg/dL nigdy nie jest traktowana jako wartość w mmol/L oraz czy przy każdym obliczeniu podano założenia.
Zgodność formatów powinna dotyczyć znaczenia, a nie tylko układu. W hipotetycznym teście eksportu 300 raportów JSON może zachować flagę krytycznego wyniku, podczas gdy szablon PDF ukryje ją poniżej podziału strony. Porównaj zalecenia kliniczne, niepewność, jednostki i znaczniki czasu we wszystkich obsługiwanych formatach wyjściowych; zapewnij możliwość prześledzenia wartości surowych do źródła i określ, czy brak pola powoduje bezpieczne odrzucenie danych, czy ich nieuzasadnioną interpretację.
Szybkie raporty i przyjazny interfejs nadal wymagają dowodów z badań nad czynnikami ludzkimi
Szybkość i łatwość obsługi to korzyści operacyjne, a nie bezpośredni dowód trafności diagnostycznej. Nasza funkcja interpretacji zazwyczaj generuje objaśnienie w około 60 sekund, ale wdrożenie kliniczne powinno obejmować pomiar opóźnienia od początku do końca, nieudanych żądań i obciążenia związanego z weryfikacją. Sam mediana czasu przetwarzania nie pozwala stwierdzić, czy pilne wyniki bezpiecznie trafiają do właściwej osoby.
Opóźnienie należy przedstawiać jako rozkład. Poproś o medianę, 95. percentyl i odsetek przekroczeń limitu czasu przy realistycznym równoczesnym użyciu, w tym przy dużych plikach i fotografiach niskiej jakości. Hipotetyczna mediana wynosząca 45 sekund przy 95. percentylu na poziomie 240 sekund opisuje zupełnie inną usługę niż ta, która konsekwentnie kończy działanie w około 60 sekund; żadna z tych wartości nie dowodzi, że leczenie rozpoczyna się wcześniej.
Sposób prezentacji pilnych wyników badań laboratoryjnych i ich eskalację należy przetestować. Wynik stężenia potasu wynoszący 6.5 mmol/L może wskazywać na nagły stan zagrożenia życia, choć jakość próbki i kontekst kliniczny wpływają na jego interpretację. Nasz przewodnik po pilnych wynikach elektrolitów pomaga opracować scenariusze; pacjenci, którzy otrzymali pilne powiadomienie o wyniku badania laboratoryjnego, powinni niezwłocznie skontaktować się z placówką prowadzącą, zamiast czekać na objaśnienie w aplikacji, zwłaszcza jeśli występują objawy.
Testy czynników ludzkich mierzą, jak użytkownicy postępują z raportem. W przypadku dostępu przez Internet, iOS, Android i rozszerzenia kupujący powinni ocenić co najmniej 3 zadania: odnalezienie pierwotnej wartości, rozpoznanie niepewności i wskazanie kolejnego właściwego działania. Rejestruj również nieprawidłowe działania, a nie tylko czas wykonania zadań, ponieważ dopracowany interfejs może zwiększać zaufanie do nieuzasadnionego zalecenia i utrudniać zauważenie błędu automatyzacji.
Dowody dotyczące bezpieczeństwa i prywatności należy uwzględnić obok walidacji klinicznej
Ocena prywatności weryfikuje sposób zbierania, przetwarzania, przechowywania, udostępniania i usuwania wrażliwych informacji laboratoryjnych. Obsługa zgodna z GDPR to deklarowane podejście, a nie zamiennik dowodów umownych i technicznych. W przypadku Kantesti Ltd, spółki zarejestrowanej w Wielkiej Brytanii pod numerem 17090423, kupujący powinni ustalić właściwą relację administratora–podmiotu przetwarzającego i podział odpowiedzialności, zanim prześlą choćby 1 raport umożliwiający identyfikację osoby.
Informacje o zdrowiu wymagają czegoś więcej niż usunięcia nazwiska. Raport może zawierać kod kreskowy, dokładną datę urodzenia, numer dostępu lub szczegóły opisu, które w połączeniu z innymi informacjami mogą umożliwić identyfikację danej osoby. Nasze środki ostrożności dotyczące prywatności podczas przesyłania plików wyjaśnić praktyczną minimalizację; kupujący powinien osobno ocenić co najmniej 3 warstwy: zawartość pliku, metadane konta i dzienniki operacyjne.
Twierdzenia dotyczące bezpieczeństwa wymagają określonego zakresu i daty potwierdzających je dowodów. Należy przeanalizować ustalenia dotyczące szyfrowania, kontrole dostępu, wykazy podwykonawców przetwarzania, warunki powiadamiania o incydentach i ustawienia retencji w dokumentacji dotyczącej prywatności danych. Jeśli dostawca powołuje się na audyt, należy zapytać, jakiej usługi i jakiego okresu kontroli dotyczy; raport obejmujący 1 komponent infrastruktury nie ocenia automatycznie dostępu do aplikacji klinicznej ani przetwarzania danych przez model.
Wdrożenie międzynarodowe wiąże się z dodatkowymi obowiązkami. Korzystanie w krajach 127+ nie oznacza, że jedna umowa lub podstawa prawna obejmuje każdą jurysdykcję, a zgodność z GDPR nie oznacza, że HIPAA ma zastosowanie ani że jej wymogi są spełnione. W przypadku funkcji rodzinnych należy przetestować granice uprawnień, używając 2 oddzielnych kont, w tym cofnięcie dostępu i odzyskiwanie konta; kwestia tego, czy usunięcie raportu powoduje również usunięcie kopii zapasowych i dzienników, wymaga jednoznacznej odpowiedzi.
Silnik AI: waliduj osobno przewidywania i zalecenia
Silnik AI wymaga walidacji dla konkretnych twierdzeń dotyczących interpretacji wzorców, przewidywania przyszłego ryzyka i spersonalizowanych zaleceń. Są to różne zadania, nawet jeśli są generowane w 1 raporcie. Architektura głębokiego uczenia i analiza wieloparametrowa opisują sposób działania systemu; nie dowodzą, że jego szacunki prawdopodobieństwa, sugestie diagnostyczne lub porady dietetyczne są wiarygodne klinicznie.
Interpretacja wieloparametrowa powinna uwzględniać konkurencyjne wyjaśnienia. W hipotetycznym raporcie z ferrytyną na poziomie 40 ng/mL i CRP na poziomie 20 mg/L sama ferrytyna nie pozwala rozstrzygnąć kwestii dostępności żelaza, ponieważ jej stężenie może wzrosnąć w odpowiedzi ostrej fazy. Kupujący oceniający sieć neuronową Kantesti powinni wykorzystywać takie przypadki zależne od kontekstu, podczas gdy wyjaśnienie technologii pozostaje odrębna od dowodów na to, że konkretny wniosek kliniczny jest prawidłowy.
Przewidywanie ryzyka wymaga określenia wyniku i horyzontu czasowego. Prawdopodobieństwo wynoszące 20% jest niemożliwe do zinterpretowania bez wskazania, co może się wydarzyć, u kogo i w jakim okresie — na przykład hospitalizacja w ciągu 30 dni, a nie początek choroby w ciągu 5 lat. TRIPOD+AI zaleca przejrzyste raportowanie badań modeli predykcyjnych (Collins i in., 2024); istotne są kalibracja i walidacja zewnętrzna, także w przypadku analizy trendów związanych z lekami.
Spersonalizowane porady wiążą się z odrębnym obowiązkiem zapewnienia bezpieczeństwa. Zalecenie żywieniowe może być niewłaściwe, gdy brakuje informacji o czynności nerek, przyjmowanych lekach lub ciąży; Family Health Risk wymaga również jasnego określenia sposobu postępowania z niepewnymi lub zgłoszonymi przez pacjenta informacjami z wywiadu. Nasz przewodnik po bezpieczeństwie żywieniowym dla nerek oferuje odpowiednie scenariusze testowe, ale zaakceptowanie 3-elementowego planu posiłków nie stanowi dowodu, że poprawia on wyniki ani że bezpiecznie zastępuje indywidualną ocenę dietetyczną.
Jak działa interpretacja wyników badań krwi przez AI: lista kontrolna walidacji dla kupującego
Kupujący powinien przetestować cały ciąg: pozyskiwanie danych źródłowych, normalizację, interpretację kontekstową, generowanie raportu i ocenę kliniczną. Przed testowaniem połączonego systemu należy osobno ocenić każdy etap. 5-etapowy plan akceptacji ułatwia ustalenie, czy źródłem niebezpiecznego wyniku była błędnie odczytana wartość, błędne założenie czy niewłaściwe zalecenie.
Należy zacząć od określenia zamierzonego zastosowania i zamrożenia ocenianej wersji. Krok 1 to pisemny wykaz twierdzeń i ryzyka; krok 2 to zablokowany, reprezentatywny zbiór danych z wcześniej określonymi kryteriami kwalifikacji i etykietami referencyjnymi. Następnie należy przetestować przechwytywanie danych z plików PDF lub zdjęć, stosując zmienione układy, konwencje zapisu dziesiętnego i nieczytelne pola; odmowy dokumentować, zamiast po cichu wykluczać je z końcowego mianownika.
Następnie należy przetestować założenia dotyczące kontekstu i przebiegu w czasie. Krok 3 sprawdza jednostki, zakresy referencyjne i metadane; krok 4 ocenia interpretacje i zalecenia według klinicznie istotnych kategorii nasilenia. Nasz przewodnik po zmiany między wizytami laboratoryjnymi pozwala podjąć przydatne wyzwanie: zmiana stężenia kreatyniny z 80 do 100 µmol/L wymaga uwzględnienia czasu, zmienności oznaczenia i stanu pacjenta, a nie automatycznego stwierdzenia pogorszenia.
Zakończ decyzją o wdrożeniu, a nie sloganem o dokładności. Krok 5 ocenia prospektywne zastosowanie w lokalnych warunkach i postępowanie w razie niepowodzenia na podstawie kryteriów uzgodnionych przed analizą wyników, w tym granic niepewności i zasad eskalacji. Poproś o dokumentację obejmującą przebieg kohorty, wersję modelu, pełną skalę ocen, tabele podgrup, przykłady nieprawidłowych wyników i zasady kontroli zmian; żaden uniwersalny odsetek nie zastąpi progów akceptacji dostosowanych do konsekwencji błędu.
Raporty przykładowe i opinie: oddziel ilustracje od dowodów
Przykładowy raport pokazuje sposób prezentacji i rozumowania, a opinia użytkownika opisuje indywidualne wrażenia. Żaden z nich nie potwierdza dokładności na poziomie pacjenta ani korzyści klinicznych. Rozważmy wyraźnie hipotetycznego 52-letniego dorosłego ze stężeniem kreatyniny 118 µmol/L, podanym eGFR wynoszącym 58 mL/min/1.73 m² i bez dostępnych wcześniejszych wyników: bezpieczne wyjaśnienie musi uwzględniać niepewność.
Pojedynczy obniżony eGFR nie potwierdza przewlekłej choroby nerek. KDIGO definiuje przewlekłą chorobę nerek jako nieprawidłowości struktury lub czynności nerek utrzymujące się przez co najmniej 3 miesiące; eGFR poniżej 60 mL/min/1.73 m² wymaga oceny przewlekłości i kontekstu (KDIGO CKD Work Group, 2024). W tym hipotetycznym przykładzie raport powinien sugerować ocenę przez lekarza i odpowiednią kontrolę, a nie rozpoznawać trwałe uszkodzenie nerek na podstawie jednego wyniku.
Szacunki oparte na stężeniu kreatyniny mogą być mniej miarodajne przy nietypowej budowie ciała. Jeśli hipotetyczna osoba jest bardzo umięśniona lub niedawno zmieniła przyjmowane suplementy, interpretacja powinna uwzględniać te czynniki, a nie bagatelizować wyniku. Nasze omówienie kreatyninie u umięśnionych dorosłych stanowi kontekst; KDIGO zaleca, jeśli jest dostępne, szacowanie GFR na podstawie kreatyniny i cystatyny C w celu właściwej oceny PChN u dorosłych, zamiast zakładać, że wstępny szacunek jest rozstrzygający.
Demonstracje powinny obejmować trudne dane wejściowe i niekorzystne wyniki. Dodaj odrębny hipotetyczny wynik potasu 6.0 mmol/L z oznaczeniem problemu z próbką, wykorzystując nasze ograniczenia wyników związane z hemolizą do wyjaśnienia, dlaczego należy rozważyć zarówno potwierdzenie wyniku, jak i pilność działania. W przypadku Kantesti przydatną metodą oceny jest zaślepione porównanie kompletnych raportów; profesjonalne opinie użytkowników, jeśli są przedstawiane za ich zgodą, pozostają informacją zwrotną opartą na doświadczeniach, a nie zamiennikiem takich testów.
Wykorzystanie przyszłości diagnostyki: wdrażanie oparte na dowodach
Wdrażaj interpretację AI wyłącznie w zastosowaniach popartych dowodami, z lokalnym nadzorem i udokumentowanym postępowaniem w przypadku błędów. Kantesti to narzędzie do analizy badań krwi oparte na AI; nasz zestaw funkcji należy oceniać według tych samych opisanych tu standardów zakupowych. Rozpoczęcie od 1 ograniczonego przypadku użycia jest bezpieczniejsze niż zakładanie, że dowody można przenieść na każdego pacjenta i każde zalecenie.
Etapowe wdrożenie powinno odróżniać wykonalność od skuteczności. Hipotetyczna ocena 100 raportów w trybie ukrytym może ujawnić błędy integracji i częste problemy z sformułowaniami bez narażania pacjentów na niezweryfikowane zalecenia, ale raczej nie pozwoli ustalić niskiego odsetka rzadkich, poważnych błędów. Szersza ocena prospektywna wymaga uzasadnienia liczebności próby i punktów końcowych dopasowanych do faktycznego deklarowanego zastosowania, z uwzględnieniem zarówno zbędnych kontroli, jak i przeoczonych niepokojących sygnałów.
Zmiany w oprogramowaniu mogą wpłynąć na wcześniej zmierzoną skuteczność. Nowy model, prompt, baza zakresów referencyjnych lub szablon raportu mogą zmienić wyniki, nawet jeśli nazwa produktu pozostaje taka sama; wszystkie 4 kategorie należy odnotowywać w historii wdrożenia. Monitoruj wagę błędów, wstrzymanie się od odpowiedzi, zmiany w podgrupach i ręczne korekty użytkowników, a także określ, kiedy zmiana wymaga ukierunkowanych testów regresji, ponownej lokalnej oceny lub zawieszenia danej funkcji.
Decyzja o wdrożeniu powinna opierać się na pisemnej analizie luk w dowodach. Określ, co zostało niezależnie potwierdzone, co poparto wyłącznie testami technicznymi, a co pozostaje niesprawdzone; następnie przypisz osobę odpowiedzialną za każde nierozwiązane ryzyko. Nasz kanał kontaktu dla nabywcy usług opieki zdrowotnej to właściwe miejsce, aby poprosić o dokumentację dotyczącą konkretnego zakresu — lepiej wybrać węższe, poparte dowodami twierdzenie niż nagłówek „99%” z niejasnym mianownikiem.
Publikacje naukowe: odróżniaj przewodniki edukacyjne od badań walidacyjnych
Poniższe 2 odnośniki DOI do repozytorium wskazują poradniki edukacyjne, a nie badania walidacji klinicznej oprogramowania do interpretacji AI. DOI zapewnia trwały identyfikator; nie potwierdza recenzji naukowej, rekrutacji pacjentów, niezależnej oceny ani skuteczności klinicznej. Nabywcy powinni klasyfikować każdą cytowaną publikację według pytania, na które faktycznie może odpowiedzieć.
Poradniki edukacyjne mogą pomóc w opracowaniu kryteriów walidacji, ale same nie walidują produktu. Nasz przewodnik po dopełniaczu i ANA może służyć jako źródło informacji w przypadkach, w których 2 pomiary dopełniacza i kontekst przeciwciał wymagają starannego objaśnienia. Zgodność z poradnikiem nie jest równoznaczna ze zgodnością z niezależnie ocenionymi wynikami pacjentów, zwłaszcza gdy poradnik i oceniane oprogramowanie pochodzą z tej samej organizacji.
Poradniki dotyczące czasu diagnostyki odnoszą się do innego, istotnego rodzaju błędów. Nasz przewodnik po diagnostyce Nipah omawia specjalistyczny kontekst diagnostyczny; nie należy wykorzystywać go do sugerowania, że rutynowa interpretacja laboratoryjna pozwala zidentyfikować konkretny wirus. Jeśli nabywca uwzględnia choćby 1 twierdzenie dotyczące patogenu o poważnych konsekwencjach w zamierzonym zastosowaniu, twierdzenie to wymaga własnych, adekwatnych dowodów diagnostycznych i odpowiednich granic eskalacji.
Standardy raportowania badań wspierają ocenę, a nie poświadczają skuteczności. STARD 2015 zawiera 30 pozycji dotyczących raportowania badań trafności diagnostycznej, a TRIPOD+AI odnosi się do raportowania modeli predykcyjnych; żadna z tych list kontrolnych nie stanowi klinicznej aprobaty oprogramowania. Poniższe pozycje bibliograficzne rozdzielają te źródła metodologiczne i wytyczne KDIGO z 2024 r. od 2 edukacyjnych pozycji DOI, aby czytelnicy mogli odróżnić zalecenia kliniczne, wytyczne dotyczące raportowania i dowody dotyczące konkretnego produktu.
Często zadawane pytania
Czym jest walidacja kliniczna oprogramowania AI do badań krwi?
Walidacja kliniczna ocenia, czy określona wersja oprogramowania AI do badań krwi generuje wystarczająco dokładne i bezpieczne wyniki dla docelowych pacjentów i decyzji. Powinna obejmować co najmniej 3 zadania: odczyt raportu źródłowego, interpretację znaczenia klinicznego i zalecenie działania. Dowody powinny opisywać standard referencyjny, wielkość próby na poziomie pacjentów, niezależne testowanie i sposób postępowania w przypadku niepowodzeń. Technicznie poprawne wyjaśnienie samo w sobie nie dowodzi poprawy wyników leczenia pacjentów.
Czy dokładność 99% jest wystarczająca, aby zaufać analizatorowi badań krwi opartemu na sztucznej inteligencji?
Twierdzenie o dokładności wynoszącej 99% nie pozwala stwierdzić bezpieczeństwa bez znajomości mianownika, definicji zadania i wagi błędów. W hipotetycznej grupie, w której tylko 1% osób ma daną chorobę, oprogramowanie oznaczające wszystkich jako zdrowych osiąga dokładność 99%, nie wykrywając żadnego z chorych pacjentów. Nabywcy powinni żądać informacji o czułości, swoistości, błędach w raportach dotyczących poszczególnych pacjentów oraz liczbie odrzuconych danych wejściowych. Rzadkie, lecz niebezpieczne zalecenia nie mogą ginąć w średniej zdominowanej przez łatwe przypadki.
Jaka jest różnica między syntetycznym benchmarkiem a walidacją kliniczną?
Syntetyczny test porównawczy ocenia oprogramowanie na skonstruowanych przypadkach, podczas gdy walidacja kliniczna wymaga dowodów odpowiednich dla docelowej populacji pacjentów i deklaracji klinicznej. Nawet 100 000 syntetycznych przypadków nie może ustalić rzeczywistej częstości występowania, korzyści klinicznych ani skuteczności w obliczu wszystkich problemów związanych z brakującymi danymi z wywiadu i jakością materiału. Testy syntetyczne mogą pomóc w identyfikacji awarii technicznych i wspierać kontrole regresji. Powinny uzupełniać, a nie zastępować reprezentatywną ocenę zewnętrzną i prospektywną.
Jak wiele niezależnych testów potrzebuje sztuczna inteligencja w ochronie zdrowia?
0 Healthcareczna AI wymaga niezależnych testów proporcjonalnych do konsekwencji błędnego wyniku, a nie uniwersalnej minimalnej liczby raportów. Zaobserwowanie 0 błędów w 100 niezależnych przypadkach pozostawia przybliżoną górną granicę wskaźnika błędów wynoszącą 3%, zgodnie z regułą trzech. Kupujący powinni zażądać zabezpieczonych danych testowych, zamrożonej wersji modelu i ujawnienia powiązań osób oceniających. Twierdzenia dotyczące rzadkich, poważnych błędów zwykle wymagają więcej dowodów, niż może dostarczyć niewielki pilotaż użyteczności lub wykonalności.
Czy obsługa 100 języków oznacza taką samą dokładność w każdym z nich?
Obsługa 100 języków nie dowodzi jednakowej dokładności klinicznej w każdym z nich. Ocena dla poszczególnych języków powinna obejmować ekstrakcję danych wejściowych, konwencje zapisu liczb dziesiętnych, jednostki, negację i znaczenie zaleceń. Na przykład glikemii zapisanej jako 5,6 mmol/L nie wolno interpretować jako 56 mmol/L. Kupujący powinni zażądać mianowników dla poszczególnych języków i ujawnić, które języki nie zostały poddane weryfikacji klinicznej.
Czy AI może zdiagnozować przewlekłą chorobę nerek na podstawie jednego niskiego wyniku eGFR?
Jeden wynik eGFR poniżej 60 mL/min/1.73 m² sam w sobie nie pozwala rozpoznać przewlekłej choroby nerek. Wytyczne KDIGO z 2024 r. definiują przewlekłą chorobę nerek jako nieprawidłowości dotyczące nerek utrzymujące się przez co najmniej 3 miesiące, przy czym należy ocenić przewlekły charakter zmian i kontekst kliniczny. Ostre zmiany, skład ciała i inne czynniki mogą wpływać na interpretację. Oprogramowanie oparte na AI powinno wyjaśniać niepewność i wspierać dalszą opiekę kliniczną, zamiast klasyfikować pojedynczy obniżony wynik jako trwałą chorobę.
Dowiedz się, jak czytać wyniki badań krwi
Prześlij wynik badania laboratoryjnego, a sztuczna inteligencja Kantesti w kilka sekund objaśni prostym językiem każdy biomarker. Z narzędzia korzysta ponad 2 miliony osób na całym świecie.
Odniesienia
- Klein, T., Mitchell, S., i Weber, H. (2025). Poradnik dotyczący badania krwi C3, C4 i miana ANA. Badania medyczne z wykorzystaniem sztucznej inteligencji Kantesti. DOI
- Klein, T., Mitchell, S., i Weber, H. (2025). Badanie krwi w kierunku wirusa Nipah: poradnik wczesnego wykrywania i diagnostyki, 2026. Badania medyczne z wykorzystaniem sztucznej inteligencji Kantesti. DOI
- Bossuyt PM i in. (2015). STARD 2015: zaktualizowana lista podstawowych pozycji dotyczących raportowania badań trafności diagnostycznej. BMJ. DOI PubMed
- Collins GS i in. (2024). Oświadczenie TRIPOD+AI: zaktualizowane wytyczne dotyczące raportowania klinicznych modeli predykcyjnych wykorzystujących regresję lub metody uczenia maszynowego. BMJ. DOI
- Grupa robocza KDIGO ds. PChN przy Kidney Disease: Improving Global Outcomes (2024). Wytyczne praktyki klinicznej KDIGO 2024 dotyczące oceny i leczenia przewlekłej choroby nerek. Kidney International. DOI
- 2 mln+Analizowane badania
- 127+Kraje
- 100+Języki
O zespole medycznym


Sygnały zaufania E-E-A-T
Doświadczenie
Kliniczna weryfikacja procesów interpretacji przez lekarza.
Ekspertyza
Medycyna laboratoryjna skupiona na tym, jak zachowują się biomarkery w kontekście klinicznym.
Autorytatywność
Recenzja medyczna: dr Thomas Klein, przy współpracy dr Sarah Mitchell i prof. dr. Hansa Webera.
Solidność
Interpretacja oparta na dowodach, z jasnymi ścieżkami dalszego postępowania, aby ograniczyć alarm.
Zastrzeżenie medyczne
Ten artykuł ma wyłącznie charakter edukacyjny i nie stanowi porady medycznej. Zawsze konsultuj decyzje dotyczące diagnozy i leczenia z wykwalifikowanym pracownikiem ochrony zdrowia.
Opublikowano · Zaktualizowano · Skontaktuj się z zespołem redakcyjnym
Opublikowano przez Kantesti Ltd, zarejestrowaną w Anglii i Walii, numer firmy. 17090423, Londyn, Wielka Brytania.
