
La validación clínica consiste en comprobar si el software produce interpretaciones suficientemente precisas y seguras para los pacientes a los que está destinado, no simplemente si genera informes convincentes.

Conclusiones clave
- Alcance de la validación debe identificar a los pacientes previstos, los datos de laboratorio y las decisiones clínicas; el éxito en una tarea no puede demostrar la seguridad en todos los usos.
- Denominadores de precisión deben distinguir entre pacientes, informes, biomarcadores y afirmaciones individuales; 10.000 afirmaciones pueden proceder de tan solo 200 informes.
- Sensibilidad mide los casos positivos según el estándar de referencia que se detectan; un resultado hipotético de 90/100 significa que se pasaron por alto 10 casos afectados.
- Valor predictivo depende de la prevalencia: con una prevalencia de 1%, una sensibilidad de 90% y una especificidad de 95% producen un valor predictivo positivo de aproximadamente 15.4%.
- Pruebas independientes requieren datos de prueba protegidos, una versión de software congelada y la divulgación de quién diseñó, financió y evaluó la prueba.
- Evidencia por subgrupos debe incluir tamaños de muestra e incertidumbre; observar 0 omisiones entre 20 casos positivos no demuestra una sensibilidad perfecta.
- Velocidad operativa de aproximadamente 60 segundos describe nuestra función de interpretación, no una reducción demostrada de los errores diagnósticos ni de las demoras en el tratamiento.
- Los criterios de adopción deben abarcar la seguridad a nivel del paciente, el rendimiento por idioma, los fallos de entrada y una respuesta documentada a los cambios del software.
El auge de la IA en el diagnóstico médico: qué significa la validación
Validación de análisis de sangre con IA requiere evidencia de que una versión específica del software produce interpretaciones precisas y seguras para los pacientes y las decisiones previstas. Los compradores deben examinar los denominadores a nivel del paciente, las pruebas independientes, los resultados por subgrupos y la gestión de fallos, no solo un porcentaje de precisión destacado. Kantesti es un analizador de análisis de sangre con IA cuyos resultados deben cumplir esos mismos requisitos de evidencia.
El software de interpretación no mide la muestra original. Un analizador de laboratorio genera valores como sodio a 138 mmol/L; después, el software de interpretación lee esos valores y explica su posible significado, lo que crea una segunda oportunidad de error incluso cuando la medición de laboratorio es correcta. Por tanto, los compradores necesitan evidencias independientes sobre la precisión de la extracción, el manejo de los intervalos de referencia y el razonamiento clínico.
La validez clínica y la utilidad clínica responden a preguntas diferentes. Una evaluación podría demostrar concordancia en 500 informes sin demostrar que los pacientes reciben una mejor atención, evitan investigaciones innecesarias o comprenden mejor la incertidumbre. Nuestra guía para explicar informes médicos explica por qué una redacción comprensible sigue requiriendo verificar las fuentes y establecer límites adecuados para la derivación.
Las estadísticas de adopción no pueden sustituir un estudio clínico. El alcance de la plataforma que informamos, de usuarios en 2M+ países, describe el uso, no una cohorte de validación representativa con resultados confirmados. El antecedentes de la empresa ayuda a establecer la rendición de cuentas de la organización; un expediente de evidencia independiente debe identificar el uso previsto exacto, la población elegible y las consecuencias de una interpretación errónea.
Afirmaciones de precisión: cuente por separado los pacientes, los informes y las decisiones
Una afirmación de precisión solo puede interpretarse cuando se divulgan su numerador, denominador y criterios de puntuación. Una cifra como 98.49% podría referirse a campos extraídos, afirmaciones aceptadas o casos clasificados: tareas muy diferentes. Aquí, esa cifra es un ejemplo de un titular que requiere escrutinio, no un resultado de rendimiento clínico verificado de forma independiente.
Las afirmaciones repetidas no equivalen a pacientes independientes. En una evaluación hipotética, 200 informes con 50 afirmaciones puntuadas cada uno producen 10.000 observaciones a nivel de afirmación, pero siguen siendo solo 200 informes. Una explicación correcta del sodio a 140 mmol/L no debe compensar una recomendación peligrosa en otra parte del mismo informe; exija tanto una puntuación a nivel de afirmación como la proporción de informes que contienen errores con consecuencias clínicas.
Las entradas excluidas pueden inflar la fiabilidad aparente. Supongamos que se envían 1.000 informes, se rechazan 100 y 882 de los 900 restantes cumplen la rúbrica: la precisión entre los informes completados es 98%, mientras que la proporción de resultados aceptables y satisfactorios entre los informes enviados es 88.2%. Ninguno de los dos denominadores es intrínsecamente deshonesto, pero los compradores necesitan ambos, además de los motivos del rechazo y de saber si los casos rechazados presentan con mayor frecuencia anomalías urgentes.
La metodología publicada debe definir qué se consideró correcto antes de iniciar la puntuación. La declaración de información STARD 2015 pide a los estudios de exactitud diagnóstica describir la selección de participantes, el estándar de referencia y el flujo de participantes (Bossuyt et al., 2015). Nuestro página de metodología de validación es un punto de partida para las preguntas sobre Kantesti; no debe considerarse una prueba del rendimiento independiente a nivel del paciente sin los materiales subyacentes del estudio.
La sensibilidad, la especificidad y el valor predictivo responden a preguntas diferentes
La sensibilidad mide la detección entre los casos positivos según el estándar de referencia; la especificidad mide los negativos correctos entre los casos negativos según el estándar de referencia. El valor predictivo positivo mide con qué frecuencia un resultado positivo es correcto en el entorno evaluado. Para una herramienta hipotética con una sensibilidad de 90% y una especificidad de 95% con una prevalencia de 1%, el valor predictivo positivo es de aproximadamente 15.4%.
Una matriz de confusión hace visible el equilibrio entre ambos. Entre 10,000 pacientes hipotéticos con una prevalencia de 1%, 100 tienen la afección objetivo: se detecta a 90 y se pasan por alto 10. De los 9,900 que no la tienen, 495 reciben resultados falsos positivos; por consiguiente, solo 90 de los 585 resultados positivos son correctos, aunque la exactitud general sea de 94.95%.
La precisión no es un sinónimo universal de exactitud. En la clasificación, precisión suele significar valor predictivo positivo, mientras que la rúbrica de puntuación narrativa de un proveedor puede usar la palabra de otra manera. Nuestra exposición sobre la confirmación de anticuerpos con resultados débilmente positivos ilustra el principio clínico: la interpretación depende de la probabilidad previa a la prueba y de la confirmación, no solo de que un resultado inicial supere un umbral.
La elección del umbral modifica el equilibrio entre los casos que no se detectan y las falsas alarmas. Solicite la matriz de confusión con el umbral de implementación propuesto, no solo una curva de rendimiento que abarque muchos umbrales. En un estudio hipotético de alertas, bajar el umbral de 0.7 a 0.4 podría mejorar la sensibilidad y duplicar las falsas alertas; los compradores deben decidir si ese equilibrio es compatible con las consecuencias clínicas y la capacidad de revisión.
Las pruebas independientes requieren un conjunto de datos protegido y un estándar de referencia fiable
Las pruebas independientes evalúan un modelo congelado con datos que no estaban disponibles durante el desarrollo, con las relaciones del evaluador divulgadas y un estándar de referencia clínicamente justificable. Los datos externos por sí solos no garantizan una evaluación independiente. Un estudio en el que participan 3 hospitales aún puede tener etiquetas sesgadas, flujos de datos compartidos o casos de prueba que hayan influido en el ajuste del modelo.
La separación a nivel del paciente evita una forma común de fuga de datos. Si el informe de enero de un paciente entra en el conjunto de entrenamiento y su informe de febrero entra en el conjunto de prueba, el modelo puede beneficiarse de patrones o identificadores recurrentes. Los compradores deben preguntar cómo se identificaron los pacientes duplicados, los ingresos repetidos y los informes procedentes de 2 sistemas de laboratorio conectados, y si el conjunto de prueba final permaneció intacto después de seleccionar el modelo y las indicaciones.
El estándar de referencia debe corresponderse con la afirmación. El acuerdo entre expertos sobre 300 interpretaciones puede evaluar la calidad de los informes, pero no confirma automáticamente la presencia de una enfermedad ni los desenlaces futuros. La distinción resulta familiar en la exactitud y el momento de realización de los ensayos: la prueba evaluada, el comparador y el momento de la confirmación pueden cambiar cada uno el rendimiento aparente.
Los bancos de pruebas sintéticos evalúan casos construidos, no la prevalencia de enfermedades ni la utilidad clínica en el mundo real. Ni siquiera 100,000 escenarios sintéticos pueden reproducir todos los antecedentes faltantes, los artefactos de las muestras o las presentaciones inesperadas. En el caso de afirmaciones relacionadas con los límites de la interpretación de la troponina, un estudio necesita la información clínica y el seguimiento diagnóstico pertinentes para la afirmación; una frase correcta sobre un umbral de laboratorio no constituye un diagnóstico confirmado.
El rendimiento por subgrupos puede revelar riesgos ocultos por el promedio
Las pruebas de validación por subgrupos determinan si el rendimiento cambia entre grupos de pacientes y condiciones de entrada clínicamente pertinentes. Los compradores deben solicitar denominadores, gravedad de los errores e intervalos de confianza para niños, adultos mayores, embarazo, insuficiencia renal y otras poblaciones previstas. Observar 0 omisiones en 20 casos positivos según la referencia deja una incertidumbre considerable sobre la verdadera tasa de omisiones.
Los intervalos de referencia específicos por edad no son intercambiables. Una interpretación pediátrica no puede heredar de manera segura todos los umbrales de adultos, aunque el analito y la unidad subyacentes sean idénticos. Nuestra guía sobre Interpretación de IA para niños explica el límite de seguridad; los compradores deben solicitar recuentos reales por grupo de edad en lugar de aceptar una afirmación general que abarque a pacientes de 1 a 18 años.
El contexto biológico importa más que las generalizaciones demográficas. Un recuento absoluto de neutrófilos de 1.2 × 10^9/L puede requerir un razonamiento distinto en una persona estable con un recuento asociado a la ausencia del antígeno Duffy que en alguien que presenta una disminución reciente durante el tratamiento. La explicación de los neutrófilos Duffy-null respalda un caso de prueba específico; no debe usarse la ascendencia por sí sola para suponer un genotipo o seguridad clínica.
Las muestras pequeñas pueden ocultar tasas de fallos clínicamente significativas. La regla de tres aproximada indica que 0 eventos observados en 20 observaciones independientes corresponde a un límite superior de 95% cercano a 15%, no a 0%. Las comparaciones entre subgrupos también requieren un análisis que agrupe por paciente cuando hay informes repetidos; un estudio debe revelar los grupos no evaluados en lugar de tratar una diferencia no significativa como prueba de que el rendimiento es equivalente.
La compatibilidad multilingüe requiere pruebas de seguridad específicas para cada idioma
La validación multilingüe comprueba si el significado clínico se conserva en la traducción, el formato numérico y la explicación dirigida al paciente en cada idioma previsto. Kantesti es una plataforma de interpretación análisis de sangre mediante IA con compatibilidad para 100+ idiomas; esa capacidad no demuestra por sí misma un rendimiento clínico equivalente en esos idiomas. Cada idioma requiere una estrategia de evaluación adecuada y una cobertura comunicada.
Las convenciones decimales pueden cambiar el valor interpretado. Un resultado de glucosa escrito como 5,6 mmol/L en una región no debe convertirse en 56 mmol/L tras la extracción, y una conversión de unidades debe preservar el significado clínico, no limitarse a sustituir la puntuación. Evalúe por separado las entradas en el idioma original y las salidas traducidas; probar únicamente informes de laboratorio en inglés traducidos a 10 idiomas no detecta los errores en las entradas.
La negación y el tipo de resultado merecen casos de prueba específicos. Expresiones como no detectado, por debajo del límite de cuantificación y no se puede descartar comunican distintos grados de certeza. Nuestro guía cualitativa versus cuantitativa explica la distinción; una rúbrica de revisión bilingüe debe poner a prueba estos significados, incluidos los símbolos de desigualdad, como menor que 0.1, en lugar de premiar únicamente una redacción fluida.
La legibilidad no garantiza la comprensión. Una evaluación lingüística útil podría pedir a los participantes que identifiquen la acción requerida y la incertidumbre tras leer 3 informes breves, y registrar si la traducción cambia la urgencia o las recomendaciones sobre medicamentos. Estas son tareas de evaluación propuestas, no un umbral universal validado; los idiomas con menos recursos pueden requerir una revisión adicional porque la terminología clínica disponible y la cobertura de entrenamiento difieren.
La integración de API y los formatos de los informes deben preservar el significado clínico
La validación de la integración comprueba si la identidad del paciente, los valores, las unidades, las fechas y las advertencias se mantienen correctos entre los límites de los sistemas. Las salidas HTML, JSON y PDF deben comunicar el mismo contenido clínico cuando se admiten esos formatos. El significado de un resultado de sodio de 128 mmol/L no debe cambiar porque una salida omita una advertencia o porque otra trunque un campo.
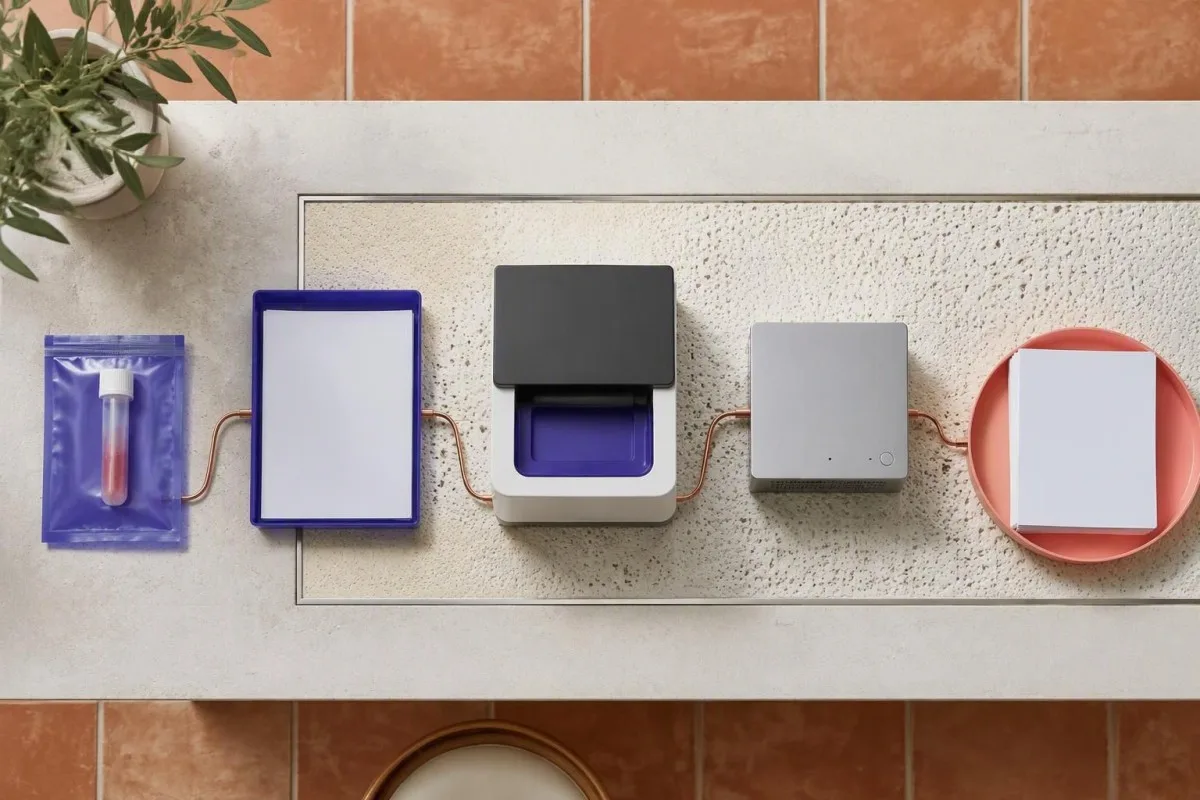
Una conexión API operativa no es una integración clínica validada. Nuestra API B2B requiere comprobaciones específicas del despliegue para la asignación de datos, la autenticación, el manejo de respuestas y el comportamiento de las versiones; la compatibilidad con EHR o LIS debe demostrarse para la interfaz concreta. Pruebe al menos 3 clases de fallos —unidades ausentes, identificadores de paciente que no coinciden y respuestas duplicadas con retraso— en lugar de aceptar una única solicitud de demostración exitosa.
Los valores derivados requieren datos de entrada explícitos y trazabilidad de la fórmula. El sodio corregido, por ejemplo, depende del sodio medido, la glucosa y el método de corrección; distintos coeficientes publicados pueden producir estimaciones diferentes. Nuestro guía de corrección del sodio relacionada con la glucosa proporciona un caso de prueba clínico, pero los compradores deben verificar que la glucosa en mg/dL nunca se trate como mmol/L y que todo cálculo explicite sus supuestos.
La concordancia del formato debe incluir el significado, no solo el diseño. En una prueba hipotética de exportación de 300 informes, JSON puede conservar una alerta crítica mientras una plantilla PDF la oculta bajo un salto de página. Compare las recomendaciones clínicas, la incertidumbre, las unidades y las marcas de tiempo en todos los formatos compatibles; mantenga la trazabilidad de los valores sin procesar hasta la fuente y especifique si un campo ausente provoca un rechazo seguro o una interpretación no respaldada.
Los informes rápidos y una interfaz intuitiva también requieren evidencia sobre factores humanos
La rapidez y la facilidad de uso son ventajas operativas, no pruebas directas de precisión diagnóstica. Nuestra función de interpretación suele generar una explicación en aproximadamente 60 segundos, pero el despliegue clínico debe medir el retraso de extremo a extremo, las solicitudes fallidas y la carga de revisión. El tiempo de procesamiento mediano por sí solo no permite saber si los resultados urgentes llegan de forma segura a la persona adecuada.
La latencia debe notificarse como una distribución. Solicite la mediana, el percentil 95 y la tasa de tiempo de espera agotado con un uso simultáneo realista, incluidos archivos grandes y fotografías de baja calidad. Una mediana hipotética de 45 segundos con un percentil 95 de 240 segundos describe un servicio muy distinto de otro que completa sistemáticamente cerca de los 60 segundos; ninguna de las dos cifras demuestra que el tratamiento se inicie antes.
Los patrones de laboratorio urgentes requieren una presentación y un escalamiento probados. Un resultado de potasio de 6.5 mmol/L puede indicar una emergencia médica, aunque la calidad de la muestra y el contexto clínico afectan a la interpretación. Nuestra guía de urgencias de electrolitos sirve de apoyo para diseñar escenarios; los pacientes con una alerta de laboratorio urgente deben ponerse en contacto cuanto antes con el servicio tratante, en lugar de esperar una explicación de la aplicación, especialmente si presentan síntomas.
Las pruebas de factores humanos miden lo que los usuarios hacen con el informe. En el acceso por web, iOS, Android y extensiones, los compradores deben examinar al menos 3 tareas: encontrar el valor original, reconocer la incertidumbre e identificar la siguiente medida adecuada. Registre también las acciones incorrectas, además del tiempo de finalización, porque una interfaz pulida puede aumentar la confianza en una recomendación no respaldada y dificultar la detección del sesgo de automatización.
La evidencia sobre seguridad y privacidad debe acompañar a la validación clínica
La evaluación de la privacidad verifica cómo se recopila, procesa, conserva, comparte y elimina la información sensible de laboratorio. El manejo conforme al GDPR es un enfoque declarado, no un sustituto de las pruebas contractuales y técnicas. Para Kantesti Ltd, sociedad registrada en el Reino Unido con número 17090423, los compradores deben establecer la relación aplicable entre responsable y encargado del tratamiento y sus respectivas responsabilidades antes de enviar incluso 1 informe identificable.
La información sanitaria requiere algo más que eliminar un nombre. Un informe puede incluir un código de barras, una fecha de nacimiento exacta, un número de acceso o detalles narrativos que permitan identificar a alguien al combinarlos con otra información. Nuestra precauciones de privacidad al cargar archivos explicar la minimización práctica; un comprador debe evaluar por separado al menos 3 capas: contenido de los archivos, metadatos de la cuenta y registros operativos.
Las afirmaciones de seguridad necesitan un alcance definido y una fecha de la evidencia. Revise los acuerdos de cifrado, los controles de acceso, las listas de subencargados del tratamiento, las condiciones de notificación de incidentes y los ajustes de conservación en la documentación sobre privacidad de los datos. Si un proveedor cita una auditoría, pregunte qué servicio y período de control abarca; un informe que cubre 1 componente de infraestructura no evalúa automáticamente el acceso a la aplicación clínica ni el manejo de los datos del modelo.
El despliegue internacional genera obligaciones adicionales. El uso en países 127+ no significa que un solo contrato o fundamento jurídico cubra todas las jurisdicciones, y la alineación con GDPR no implica la aplicabilidad de HIPAA ni el cumplimiento de sus requisitos. En las funciones familiares, pruebe los límites de los permisos con 2 cuentas separadas, incluida la revocación del acceso y la recuperación de la cuenta; debe haber una respuesta explícita sobre si eliminar un informe también elimina las copias de seguridad y los registros.
El motor de IA: valide por separado las predicciones y las recomendaciones
Un motor de IA necesita validación específica para cada afirmación sobre la interpretación de patrones, la predicción de riesgos futuros y las recomendaciones personalizadas. Son tareas diferentes, incluso cuando se generan en 1 informe. La arquitectura de aprendizaje profundo y el análisis multiparamétrico describen cómo funciona un sistema; no demuestran que sus estimaciones de probabilidad, sugerencias diagnósticas o recomendaciones alimentarias sean clínicamente fiables.
La interpretación multiparamétrica debe conservar las explicaciones contrapuestas. En un informe hipotético con ferritina de 40 ng/mL y CRP de 20 mg/L, la ferritina por sí sola no puede resolver la cuestión de la disponibilidad de hierro, ya que puede elevarse en respuesta a una fase aguda. Los compradores que evalúen la red neuronal de Kantesti deberían usar casos de este tipo, sensibles al contexto, mientras que el explicación de la tecnología sigue siendo distinto de la evidencia de que una conclusión clínica específica sea correcta.
La predicción de riesgos requiere un resultado y un horizonte temporal definidos. Una probabilidad de 20% es ininterpretable sin indicar qué puede ocurrir, a quién y durante qué período; por ejemplo, hospitalización en un plazo de 30 días, en lugar de aparición de una enfermedad en un plazo de 5 años. TRIPOD+AI recomienda informar de manera transparente los estudios de modelos predictivos (Collins et al., 2024); la calibración y la validación externa son importantes, incluso para el análisis de tendencias relacionadas con la medicación.
El asesoramiento personalizado genera una obligación de seguridad independiente. Una recomendación nutricional puede ser inadecuada si se desconocen la función renal, los medicamentos o el contexto del embarazo; Family Health Risk también requiere un manejo claro de los antecedentes inciertos o autodeclarados. Nuestro guía de seguridad nutricional para el riñón ofrece escenarios de prueba pertinentes, pero aceptar un plan de comidas de 3 elementos no demuestra que mejore los resultados ni que sustituya de forma segura una evaluación dietética individualizada.
Cómo funciona la interpretación análisis de sangre con IA: lista de verificación de validación para compradores
Un comprador debe probar la secuencia completa: captura de la fuente, normalización, interpretación contextual, generación del informe y revisión clínica. Evalúe cada etapa por separado antes de probar el sistema combinado. Un plan de aceptación de 5 etapas facilita identificar si un resultado inseguro comenzó con un valor mal leído, una suposición equivocada o una recomendación inadecuada.
Empiece por definir el uso previsto y congelar la versión evaluada. El paso 1 consiste en un inventario escrito de afirmaciones y riesgos; el paso 2, en un conjunto de datos representativo y bloqueado, con criterios de elegibilidad y etiquetas de referencia predefinidos. A continuación, debe probarse la captura de archivos PDF o fotos con diseños modificados, convenciones decimales y campos ilegibles; documente los rechazos en lugar de excluirlos discretamente del denominador final.
A continuación, pruebe el contexto y las suposiciones longitudinales. El paso 3 verifica las unidades, los intervalos de referencia y los metadatos; el paso 4 puntúa las interpretaciones y recomendaciones usando categorías de gravedad clínicamente significativas. Nuestra guía sobre cambios entre visitas al laboratorio respalda un reto útil: un cambio de creatinina de 80 a 100 µmol/L exige tener en cuenta el momento, la variación del ensayo y al paciente, no declarar automáticamente un deterioro.
Termine con una decisión de implementación, no con un eslogan sobre la precisión. El paso 5 evalúa el uso local prospectivo y la gestión de fallos conforme a criterios acordados antes de examinar los resultados, incluidos los límites de incertidumbre y la conducta de escalamiento. Solicite un expediente que incluya el flujo de la cohorte, la versión del modelo, la rúbrica de puntuación completa, tablas de subgrupos, ejemplos de resultados adversos y reglas de control de cambios; ningún porcentaje universal puede sustituir los umbrales de aceptación ajustados a las consecuencias de los errores.
Informes de muestra y testimonios: distinga las ilustraciones de la evidencia
Un informe de muestra demuestra la presentación y el razonamiento, mientras que un testimonio describe una impresión individual. Ninguno de los dos establece la precisión a nivel de paciente ni el beneficio clínico. Considere el caso claramente hipotético de un adulto de 52 años con creatinina de 118 µmol/L, eGFR informado de 58 mL/min/1.73 m² y sin resultados previos disponibles: la explicación segura debe preservar la incertidumbre.
Un único eGFR reducido no establece un diagnóstico de enfermedad renal crónica. KDIGO define la enfermedad renal crónica como anomalías de la estructura o la función renal presentes durante al menos 3 meses; un eGFR inferior a 60 mL/min/1.73 m² requiere evaluar la cronicidad y el contexto (KDIGO CKD Work Group, 2024). En este ejemplo hipotético, el informe debe sugerir una evaluación clínica y un seguimiento adecuado, no diagnosticar daño renal permanente a partir de un único resultado.
Las estimaciones basadas en creatinina pueden ser menos informativas en casos de composición corporal inusual. Si la persona hipotética tiene una musculatura muy desarrollada o ha cambiado recientemente de suplementos, la interpretación debe tener en cuenta esos factores en lugar de desestimar el resultado. Nuestra explicación sobre creatinina en adultos musculosos aporta contexto; KDIGO respalda el cálculo de eGFR mediante creatinina y cistatina C cuando esté disponible para la evaluación adecuada de la enfermedad renal crónica en adultos, en lugar de asumir que la estimación inicial es definitiva.
Las demostraciones deben incluir datos difíciles y resultados desfavorables. Añada un resultado hipotético de potasio de 6.0 mmol/L con un problema de la muestra marcado, utilizando nuestras limitaciones de los resultados relacionadas con la hemólisis para explicar por qué deben considerarse tanto la confirmación como la urgencia. Para Kantesti, una evaluación útil consiste en comparar a ciegas informes completos; los testimonios de profesionales, si se presentan con consentimiento, siguen siendo opiniones basadas en la experiencia y no sustituyen estas pruebas.
Abrazar el futuro del diagnóstico: adopción basada en la evidencia
Adopte la interpretación mediante IA únicamente para los usos respaldados por la evidencia, con supervisión local y una respuesta documentada ante los errores. Kantesti es una herramienta de análisis de análisis de sangre impulsada por IA; nuestro conjunto de funciones debe evaluarse según los mismos estándares de adquisición descritos aquí. Comenzar con un caso de uso limitado es más seguro que suponer que la evidencia es aplicable a todos los pacientes y recomendaciones.
Una introducción por etapas debe distinguir la viabilidad de la eficacia. Una evaluación hipotética en modo silencioso de 100 informes puede revelar fallos de integración y problemas frecuentes de redacción sin exponer a los pacientes a recomendaciones que no hayan sido revisadas, pero es poco probable que permita establecer una tasa baja de errores graves poco frecuentes. Una evaluación prospectiva más amplia necesita una justificación del tamaño de la muestra y resultados acordes con la afirmación concreta, incluido el seguimiento innecesario, así como los problemas no detectados.
Los cambios de software pueden alterar el rendimiento medido anteriormente. Un modelo nuevo, una instrucción, una base de datos de intervalos de referencia o una plantilla de informe pueden cambiar los resultados aunque el nombre del producto siga siendo el mismo; registre las 4 categorías en el historial de implementación. Supervise la gravedad de los errores, las abstenciones, las desviaciones entre subgrupos y las anulaciones por parte de los usuarios, y defina cuándo un cambio activa pruebas de regresión específicas, una nueva evaluación local o la suspensión de una función concreta.
La decisión de adopción debe basarse en un análisis escrito de las brechas de evidencia. Determine qué se ha establecido de forma independiente, qué cuenta solo con respaldo de pruebas técnicas y qué sigue sin haberse evaluado; luego asigne un responsable a cada riesgo sin resolver. Nuestra canal de contacto para compradores de atención médica es el lugar adecuado para solicitar documentación específica sobre el alcance; prefiera una afirmación más acotada y fundamentada en lugar de un titular de 99% con un denominador poco claro.
Publicaciones de investigación: distinga las guías educativas de los estudios de validación
Las 2 referencias DOI del repositorio que aparecen a continuación identifican guías educativas, no estudios de validación clínica de software de interpretación de IA. Un DOI proporciona un identificador persistente; no establece revisión por pares, reclutamiento de pacientes, evaluación independiente ni eficacia clínica. Los compradores deben clasificar cada publicación citada según la pregunta que realmente puede responder.
Las guías educativas pueden ayudar a elaborar una rúbrica de validación sin validar por sí mismas el producto. Nuestro guía de complemento y ANA puede aportar información sobre casos en los que 2 mediciones de complemento y el contexto de anticuerpos requieren una explicación cuidadosa. La concordancia con una guía no equivale a la concordancia con resultados de pacientes adjudicados de forma independiente, especialmente cuando la guía y el software evaluado comparten una misma fuente organizativa.
Las guías sobre el momento del diagnóstico abordan otro modo de fallo útil. Nuestro guía de pruebas diagnósticas de Nipah analiza un contexto diagnóstico especializado; no debe usarse para dar a entender que la interpretación rutinaria de laboratorio identifica un virus específico. Si un comprador incluye siquiera 1 afirmación sobre un patógeno de consecuencias graves en el uso previsto, esa afirmación necesita pruebas diagnósticas pertinentes propias y límites de escalamiento adecuados.
Los estándares de presentación de estudios respaldan la evaluación crítica, no certifican el rendimiento. STARD 2015 contiene 30 elementos de presentación de informes para la investigación sobre exactitud diagnóstica, mientras que TRIPOD+AI aborda la presentación de modelos de predicción; ninguna de las dos listas de verificación otorga al software una aprobación clínica. Las referencias que aparecen a continuación separan esas fuentes metodológicas y la guía KDIGO de 2024 de las 2 entradas de DOI educativas, para que los lectores puedan distinguir entre recomendaciones clínicas, directrices de presentación de informes y pruebas específicas del producto.
Preguntas frecuentes
¿Qué es la validación clínica del software de análisis de sangre con IA?
La validación clínica evalúa si una versión especificada del software de análisis de sangre con IA produce resultados suficientemente precisos y seguros para los pacientes y las decisiones previstos. Debe distinguir al menos 3 tareas: leer el informe de origen, interpretar el significado clínico y recomendar una acción. La evidencia debe describir el estándar de referencia, el tamaño de la muestra a nivel de paciente, las pruebas independientes y el manejo de fallos. Una explicación técnicamente correcta no demuestra por sí sola una mejora en los resultados de los pacientes.
¿Es suficiente la precisión de 99% para confiar en un analizador de análisis de sangre con IA?
Una afirmación de precisión del 99 % no puede establecer la seguridad sin conocer su denominador, la definición de la tarea y la gravedad de los errores. En un grupo hipotético en el que solo el 1 % tiene una afección objetivo, un software que clasifica a todos como negativos logra una precisión del 99 % sin detectar a ninguno de los pacientes afectados. Los compradores deben solicitar sensibilidad, especificidad, errores en los informes a nivel de paciente y el número de entradas rechazadas. Las recomendaciones poco frecuentes pero peligrosas no deben quedar ocultas en un promedio dominado por afirmaciones sencillas.
¿Cuál es la diferencia entre un benchmark sintético y una validación clínica?
Un benchmark sintético evalúa el software en casos construidos, mientras que la validación clínica requiere evidencia adecuada para la población de pacientes prevista y la afirmación clínica. Ni siquiera 100 000 casos sintéticos pueden establecer la prevalencia en el mundo real, el beneficio clínico o el rendimiento ante todos los problemas de antecedentes incompletos y calidad de las muestras. Las pruebas sintéticas pueden ayudar a identificar fallos técnicos y respaldar las comprobaciones de regresión. Deben complementar, no sustituir, la evaluación externa y prospectiva representativa.
¿Cuántas pruebas independientes necesita la IA sanitaria?
La IA para la atención médica necesita pruebas independientes proporcionales a las consecuencias de un resultado incorrecto, no un número mínimo universal de informes. Observar 0 fallos en 100 casos independientes deja un límite superior aproximado de la tasa de fallos de 95%, cercano a 3%, según la regla de tres. Los compradores deben solicitar datos de prueba protegidos, una versión congelada del modelo y la divulgación de las relaciones de los evaluadores. Las afirmaciones sobre errores graves poco frecuentes suelen requerir más pruebas de las que puede aportar un pequeño estudio piloto de usabilidad o viabilidad.
¿El soporte para 100 idiomas significa la misma precisión en todos los idiomas?
La compatibilidad con 100 idiomas no demuestra una precisión clínica equivalente en todos ellos. La evaluación específica de cada idioma debería comprobar la extracción de datos de entrada, las convenciones decimales, las unidades, la negación y el significado de las recomendaciones. Por ejemplo, la glucosa escrita como 5,6 mmol/L no debe interpretarse como 56 mmol/L. Los compradores deberían solicitar denominadores específicos por idioma e indicar qué idiomas no han sido sometidos a revisión clínica.
¿Puede la IA diagnosticar enfermedad renal crónica a partir de un único resultado bajo de eGFR?
Un solo resultado de eGFR inferior a 60 mL/min/1.73 m² no establece, por sí mismo, una enfermedad renal crónica. La guía KDIGO de 2024 define la enfermedad renal crónica por la presencia de anomalías renales durante al menos 3 meses, teniendo en cuenta la cronicidad y el contexto clínico. Los cambios agudos, la composición corporal y otros factores pueden afectar la interpretación. El software de IA debe explicar la incertidumbre y facilitar el seguimiento clínico, en lugar de etiquetar una sola estimación reducida como enfermedad permanente.
Obtenga una explicación de los resultados análisis de sangre
Cargue su informe de laboratorio y la IA de Kantesti explica cada biomarcador en lenguaje sencillo en cuestión de segundos. Más de 2 millones de personas en todo el mundo la han utilizado.
Referencias
- Klein, T., Mitchell, S. y Weber, H. (2025). Guía de análisis de sangre de C3 y C4 del complemento y título de ANA. Investigación médica de Kantesti AI. DOI
- Klein, T., Mitchell, S. y Weber, H. (2025). Análisis de sangre para el virus Nipah: guía de detección temprana y diagnóstico 2026. Investigación médica de Kantesti AI. DOI
- Bossuyt PM et al. (2015). STARD 2015: lista actualizada de elementos esenciales para informar estudios de exactitud diagnóstica. BMJ. DOI PubMed
- Collins GS et al. (2024). Declaración TRIPOD+AI: directrices actualizadas para informar modelos de predicción clínica que utilizan métodos de regresión o aprendizaje automático. BMJ. DOI
- Grupo de trabajo sobre ERC de Kidney Disease: Improving Global Outcomes (KDIGO) (2024). Guía de práctica clínica KDIGO 2024 para la evaluación y el manejo de la enfermedad renal crónica. Kidney International. DOI
- Más de 2 millonesPruebas analizadas
- 127+Países
- 100+Idiomas
Acerca del equipo médico


Señales de confianza E-E-A-T
Experiencia
Revisión clínica dirigida por un médico de los flujos de interpretación de análisis.
Pericia
Enfoque en medicina de laboratorio sobre cómo se comportan los biomarcadores en el contexto clínico.
Autoridad
Revisado médicamente por el Dr. Thomas Klein, con contribuciones de la Dra. Sarah Mitchell y el Prof. Dr. Hans Weber.
Integridad
Interpretación basada en la evidencia con vías de seguimiento claras para reducir la alarma.
Aviso médico
Este artículo es solo con fines educativos y no constituye asesoramiento médico. Consulta siempre a un profesional sanitario cualificado para decisiones de diagnóstico y tratamiento.
Publicado · Actualizado · Contacta con el equipo editorial
Publicado por Kantesti Ltd, registrado en Inglaterra y Gales, número de empresa. 17090423, Londres, Reino Unido.
