
اعتبارسنجی بالینی یعنی آزمودن اینکه نرمافزار برای بیمارانِ موردنظر خود تفسیرهایی بهاندازه کافی دقیق و ایمن ارائه میدهد یا نه—نه اینکه صرفاً گزارشهایی قانعکننده تولید میکند.

نکات کلیدی
- دامنهٔ اعتبارسنجی باید بیماران موردنظر، دادههای ورودی آزمایشگاهی و تصمیمهای بالینی را مشخص کند؛ موفقیت در یک وظیفه نمیتواند ایمنی را در همهٔ کاربردها ثابت کند.
- مخرجهای دقت باید بیماران، گزارشها، نشانگرهای زیستی و گزارههای منفرد را از هم متمایز کنند؛ ۱۰٬۰۰۰ گزاره ممکن است فقط از ۲۰۰ گزارش آمده باشند.
- حساسیت مواردِ مثبتِ مرجعِ شناساییشده را اندازه میگیرد؛ نتیجهٔ فرضی ۹۰/۱۰۰ یعنی ۱۰ موردِ مبتلا از دست رفتهاند.
- ارزش پیشبینیکنندگی به شیوع بستگی دارد: در شیوع 1%، حساسیت 90% و ویژگی 95% ارزش اخباری مثبتِ حدود 15.4% ایجاد میکنند.
- آزمون مستقل به دادههای آزمون حفاظتشده، نسخهٔ ثابت نرمافزار و افشای هویت طراحان، تأمینکنندگان مالی و داوران ارزیابی نیاز دارد.
- شواهد زیرگروهها باید شامل حجم نمونه و عدمقطعیت باشد؛ مشاهده صفر مورد از قلمافتاده در میان ۲۰ مورد مثبت، حساسیت کامل را اثبات نمیکند.
- سرعت عملیاتی حدود ۶۰ ثانیه، توصیفی از قابلیت تفسیر ماست، نه کاهش اثباتشده در خطاهای تشخیصی یا تأخیرهای درمانی.
- معیارهای پذیرش باید ایمنی در سطح بیمار، عملکرد مختص هر زبان، خطاهای ورودی و پاسخ مستند به تغییرات نرمافزار را پوشش دهند.
ظهور هوش مصنوعی در تشخیص پزشکی: اعتبارسنجی به چه معناست
اعتبارسنجی آزمایش خون هوش مصنوعی مستلزم شواهدی است که نشان دهد یک نسخه نرمافزاری مشخص، تفسیرهای دقیق و ایمنی را برای بیماران و تصمیمهای موردنظر ارائه میکند. خریداران باید مخرجهای محاسبه در سطح بیمار، آزمون مستقل، نتایج زیرگروهها و نحوه رسیدگی به خطاها را بررسی کنند، نه اینکه فقط به یک درصد دقتِ تیترپسند بسنده کنند. Kantesti یک تحلیلگر آزمایش خون مبتنی بر هوش مصنوعی است و خروجیهای آن نیز باید مشمول همین الزامات شواهد باشند.
نرمافزار تفسیر، نمونه اولیه را اندازهگیری نمیکند. یک تحلیلگر آزمایشگاهی مقادیری مانند سدیم ۱۳۸ mmol/L تولید میکند؛ سپس نرمافزار تفسیر این مقادیر را میخواند و اهمیت احتمالی آنها را توضیح میدهد. این فرایند فرصت دومی برای خطا ایجاد میکند، حتی اگر اندازهگیری آزمایشگاهی درست باشد. بنابراین، خریداران به شواهد جداگانه برای دقت استخراج، نحوه برخورد با محدودههای مرجع و استدلال بالینی نیاز دارند.
اعتبار بالینی و سودمندی بالینی به پرسشهای متفاوتی پاسخ میدهند. ممکن است یک ارزیابی، توافق در ۵۰۰ گزارش را نشان دهد، بیآنکه ثابت کند بیماران مراقبت بهتری دریافت میکنند، از بررسیهای غیرضروری پرهیز میکنند یا عدمقطعیت را دقیقتر درک میکنند. راهنمای توضیح گزارش پزشکی ما توضیح میدهد که حتی عبارتپردازی قابلفهم نیز همچنان به بررسی منبع و مرزهای مناسب برای ارجاع نیاز دارد.
آمار پذیرش نمیتواند جایگزین یک مطالعه بالینی شود. گستره گزارششده پلتفرم ما، یعنی 2M+ کاربر در 127+ کشور، میزان استفاده را توصیف میکند، نه یک گروه اعتبارسنجی نماینده با پیامدهای تأییدشده. این پیشینه شرکت به ایجاد پاسخگویی سازمانی کمک میکند؛ اما یک پرونده شواهد جداگانه باید کاربرد موردنظر دقیق، جمعیت واجد شرایط و پیامدهای یک تفسیر نادرست را مشخص کند.
ادعاهای دقت: بیماران، گزارشها و تصمیمها را جداگانه بشمارید
ادعای دقت تنها زمانی قابلتفسیر است که صورت، مخرج و قواعد امتیازدهی آن افشا شوند. رقمی مانند 98.49% میتواند به فیلدهای استخراجشده، گزارههای پذیرفتهشده یا موارد طبقهبندیشده اشاره داشته باشد؛ اینها وظایف بسیار متفاوتی هستند. در اینجا، آن عدد نمونهای از یک رقم تیترپسند است که باید با دقت بررسی شود، نه نتیجه عملکرد بالینیِ تأییدشده بهطور مستقل.
گزارههای تکراری معادل بیماران مستقل نیستند. در یک ارزیابی فرضی، ۲۰۰ گزارش که هرکدام ۵۰ گزاره امتیازدهیشده دارند، ۱۰٬۰۰۰ مشاهده در سطح گزاره به دست میدهند، اما همچنان فقط ۲۰۰ گزارش هستند. توضیح درست درباره سدیم ۱۴۰ mmol/L نباید توصیه خطرناک دیگری را در همان گزارش خنثی کند؛ امتیازدهی در سطح گزاره و نیز سهم گزارشهای دارای خطاهای دارای پیامد بالینی را مطالبه کنید.
ورودیهای حذفشده میتوانند قابلیت اتکای ظاهری را افزایش دهند. فرض کنید ۱٬۰۰۰ گزارش ارسال شده، ۱۰۰ مورد رد شدهاند و از ۹۰۰ مورد باقیمانده، ۸۸۲ مورد با معیارهای ارزیابی مطابقت داشتهاند: دقت در میان گزارشهای تکمیلشده 98% است، درحالیکه خروجی موفق و قابلقبول در میان کل گزارشهای ارسالی 88.2% است. هیچیک از این دو مخرج ذاتاً گمراهکننده نیست، اما خریداران به هر دو نیاز دارند، بهعلاوه دلایل رد گزارشها و اینکه آیا موارد ردشده بهطور نامتناسب شامل ناهنجاریهای فوری میشوند یا نه.
روششناسی منتشرشده باید پیش از آغاز امتیازدهی مشخص کند که چه چیزی درست محسوب میشود. بیانیه گزارشدهی STARD 2015 از مطالعات دقت تشخیصی میخواهد که نحوه انتخاب شرکتکنندگان، استاندارد مرجع و جریان شرکتکنندگان را شرح دهند (Bossuyt et al., 2015). ما صفحه روششناسی اعتبارسنجی نقطه شروعی برای پرسشهایی درباره Kantesti است؛ بدون مستندات اصلی مطالعه، نباید آن را مدرکی برای عملکرد مستقل در سطح بیمار تلقی کرد.
حساسیت، ویژگی و ارزش اخباری به پرسشهای متفاوتی پاسخ میدهند
حساسیت، تشخیص موارد مثبت بر اساس استاندارد مرجع را میسنجد؛ ویژگی، منفیهای درست را در میان موارد منفی بر اساس استاندارد مرجع میسنجد. ارزش اخباری مثبت میسنجد که در محیط آزمونشده، خروجی مثبت با چه فراوانی درست است. برای ابزاری فرضی با حساسیت 90% و ویژگی 95% در شیوع 1%، ارزش اخباری مثبت تقریباً 15.4% است.
ماتریس درهمریختگی این موازنه را آشکار میکند. از میان 10,000 بیمار فرضی با شیوع 1%، 100 نفر بیماری هدف را دارند: 90 نفر شناسایی میشوند و 10 نفر از دست میروند. از 9,900 نفری که به آن مبتلا نیستند، 495 نفر خروجی مثبت کاذب دریافت میکنند؛ در نتیجه، تنها 90 مورد از 585 خروجی مثبت درست هستند، با اینکه دقت کلی 94.95% است.
پرسیژن مترادفی همگانی برای دقت نیست. در طبقهبندی، پرسیژن معمولاً به معنای ارزش اخباری مثبت است، در حالی که ممکن است در روبریک امتیازدهی رواییِ فروشنده، این واژه معنای دیگری داشته باشد. بحث ما درباره تأیید نتیجه مثبت ضعیف پادتن این اصل بالینی را نشان میدهد: تفسیر به احتمال پیشآزمون و تأیید بستگی دارد، نه صرفاً به اینکه نتیجه اولیه از آستانه فراتر رود.
انتخاب آستانه، موازنه میان موارد ازدسترفته و هشدارهای کاذب را تغییر میدهد. ماتریس درهمریختگی را در آستانه استقرار پیشنهادی درخواست کنید، نه فقط منحنی عملکردی را که آستانههای بسیاری را در بر میگیرد. در یک مطالعه فرضی هشداردهی، پایین آوردن آستانه از 0.7 به 0.4 ممکن است حساسیت را بهبود دهد و همزمان هشدارهای کاذب را دو برابر کند؛ خریداران باید تصمیم بگیرند که آیا این موازنه با پیامدهای بالینی و ظرفیت بررسی تناسب دارد یا خیر.
آزمون مستقل به مجموعهدادهای حفاظتشده و معیار مرجع معتبر نیاز دارد
آزمون مستقل، یک مدل منجمدشده را روی دادههایی ارزیابی میکند که در دسترس نبودهاند در طول توسعه؛ همچنین روابط ارزیاب و استاندارد مرجعِ قابل دفاع از نظر بالینی را افشا میکند. دادههای بیرونی بهتنهایی ارزیابی مستقل را تضمین نمیکنند. مطالعهای با مشارکت 3 بیمارستان نیز ممکن است برچسبهای سوگیرانه، خطوط لوله داده مشترک یا موارد آزمونی داشته باشد که بر تنظیم مدل اثر گذاشتهاند.
جداسازی در سطح بیمار از نوع رایجی از نشت داده جلوگیری میکند. اگر گزارش ژانویه یک بیمار وارد دادههای آموزشی شود و گزارش فوریه همان بیمار وارد دادههای آزمون شود، مدل ممکن است از الگوها یا شناسههای تکرارشونده بهره ببرد. خریداران باید بپرسند بیماران تکراری، بستریهای مجدد و گزارشهای دو سامانه آزمایشگاهی مرتبط چگونه شناسایی شدهاند و آیا مجموعه آزمون نهایی پس از انتخاب مدل و پرامپت دستنخورده باقی مانده است یا خیر.
استاندارد مرجع باید با ادعا مطابقت داشته باشد. توافق کارشناسان درباره 300 تفسیر میتواند کیفیت گزارش را ارزیابی کند، اما بهطور خودکار وجود بیماری یا پیامدهای آینده را تأیید نمیکند. این تمایز از دقت آزمون و زمانبندیآشناست: آزمونِ مورد ارزیابی، مقایسهگر و زمان تأیید، هر یک میتوانند عملکرد ظاهری را تغییر دهند.
بنچمارکهای مصنوعی، موارد ساختهشده را میآزمایند، نه شیوع بیماری در دنیای واقعی یا فایده بالینی را. حتی 100,000 سناریوی مصنوعی نیز نمیتوانند همه سوابق پزشکیِ موجودنبوده، آرتیفکتهای نمونه یا تظاهرات غیرمنتظره را بازآفرینی کنند. برای ادعاهای مربوط به محدودیتهای تفسیر تروپونین, ، یک مطالعه به اطلاعات بالینی و پیگیری تشخیصی مرتبط با ادعا نیاز دارد؛ جملهای درست درباره یک آستانه آزمایشگاهی، تشخیص تأییدشده نیست.
عملکرد در زیرگروهها میتواند خطرهای پنهانشده در میانگین را آشکار کند
آزمونهای اعتبارسنجی زیرگروه بررسی میکنند که آیا عملکرد در گروههای بیمار و شرایط ورودیِ مرتبط از نظر بالینی تغییر میکند یا خیر. خریداران باید مخرجها، شدت خطا و فاصلههای اطمینان را برای کودکان، سالمندان، بارداری، اختلال کلیوی و سایر جمعیتهای موردنظر درخواست کنند. مشاهده صفر موردِ ازدسترفته در ۲۰ موردِ مرجعِ مثبت، عدمقطعیت چشمگیری درباره نرخ واقعی موارد ازدسترفته باقی میگذارد.
بازههای مرجع اختصاصی سن را نمیتوان بهجای یکدیگر به کار برد. تفسیر کودکان را نمیتوان با ایمنی از هر آستانه بزرگسالان پیروی داد، حتی وقتی آنالیت و واحدِ زیربنایی یکسان باشند. راهنمای ما درباره تفسیر هوش مصنوعی برای کودکان مرز ایمنی را توضیح میدهد؛ خریداران باید تعداد واقعی افراد در هر گروه سنی را درخواست کنند، نه اینکه ادعای کلیِ پوشش بیماران ۱ تا ۱۸ ساله را بپذیرند.
زمینه زیستی مهمتر از میانبُرهای جمعیتشناختی است. شمارش مطلق نوتروفیل 1.2 × 10^9/L ممکن است در فردی پایدار با شمارش مرتبط با فنوتیپ Duffy-null، در مقایسه با فردی که هنگام درمان دچار افت تازهای شده است، به استدلال متفاوتی نیاز داشته باشد. توضیح نوتروفیلهای فاقد دافی ما از یک مورد آزمون هدفمند پشتیبانی میکند؛ نباید صرفاً بر اساس تبار، ژنوتیپ یا ایمنی بالینی را فرض کرد.
نمونههای کوچک میتوانند نرخهای شکستِ بالینیِ معنادار را پنهان کنند. قاعده تقریبی سه میگوید صفر رویدادِ مشاهدهشده در ۲۰ مشاهده مستقل، با کران بالای 95% نزدیک به 15% مطابقت دارد، نه 0%. مقایسههای زیرگروهی در صورت تکرار گزارشها به تحلیل خوشهبندیشده بر اساس بیمار نیز نیاز دارند؛ مطالعه باید گروههای آزموننشده را افشا کند، نه اینکه تفاوتِ معنادارنبودن را اثبات همارزی عملکرد تلقی کند.
پشتیبانی چندزبانه به آزمون ایمنی مختص هر زبان نیاز دارد
اعتبارسنجی چندزبانه بررسی میکند که آیا معنای بالینی در هر زبانِ موردنظر، با ترجمه، قالببندی عددی و توضیحات ارائهشده به بیمار حفظ میشود یا خیر. Kantesti یک پلتفرم مبتنی بر هوش مصنوعی برای تفسیر آزمایش خون است که از زبانهای 100+ پشتیبانی میکند؛ این قابلیت بهتنهایی همارزی عملکرد بالینی را در این زبانها اثبات نمیکند. هر زبان به راهبرد ارزیابی مناسب و پوششِ اعلامشده نیاز دارد.
قراردادهای اعشاری میتوانند مقدار تفسیرشده را تغییر دهند. نتیجه گلوکز که در یک منطقه با 5,6 mmol/L نوشته شده، نباید پس از استخراج به 56 mmol/L تبدیل شود؛ تبدیل واحد نیز باید معنای بالینی را حفظ کند، نه اینکه صرفاً نشانهگذاری را جایگزین کند. ورودیهای زبان اصلی و خروجیهای ترجمهشده را جداگانه ارزیابی کنید؛ آزمودن صرفِ گزارشهای آزمایشگاهی انگلیسیِ ترجمهشده به ۱۰ زبان، خطاهای سمت ورودی را نادیده میگیرد.
نفی و نوع نتیجه، موارد آزمون اختصاصی لازم دارند. عبارتهایی مانند «یافت نشد»، «کمتر از حد کمّیسازی» و «نمیتوان رد کرد» درجات متفاوتی از قطعیت را منتقل میکنند. راهنمای ما راهنمای کیفی در مقابل کمی این تمایز را توضیح میدهد؛ یک معیار ارزیابی دوزبانه باید این معانی، از جمله نمادهای نامساوی مانند کمتر از 0.1، را بیازماید، نه اینکه فقط روانی بیان را پاداش دهد.
خوانایی، درک را تضمین نمیکند. یک ارزیابی زبانی مفید میتواند از شرکتکنندگان بخواهد پس از خواندن ۳ گزارش کوتاه، اقدام لازم و عدمقطعیت را مشخص کنند و همزمان ثبت کند که آیا ترجمه فوریت یا توصیه دارویی را تغییر میدهد یا نه. اینها تکالیف ارزیابی پیشنهادیاند، نه آستانهای جهانی و اعتبارسنجیشده؛ زبانهایی با منابع کمتر ممکن است به بازبینی بیشتری نیاز داشته باشند، زیرا اصطلاحات بالینیِ در دسترس و پوشش آموزشی متفاوت است.
یکپارچهسازی API و قالبهای گزارشدهی باید معنای بالینی را حفظ کنند
اعتبارسنجی یکپارچهسازی بررسی میکند که آیا هویت بیمار، مقادیر، واحدها، تاریخها و هشدارها در مرزهای سامانه درست باقی میمانند یا خیر. خروجیهای HTML، JSON و PDF باید در صورت پشتیبانی از این قالبها، محتوای بالینی یکسانی را منتقل کنند. نتیجه سدیم 128 mmol/L نباید بهدلیل حذف هشدار در یک خروجی یا کوتاهشدن یک فیلد در خروجی دیگر، معنایش تغییر کند.
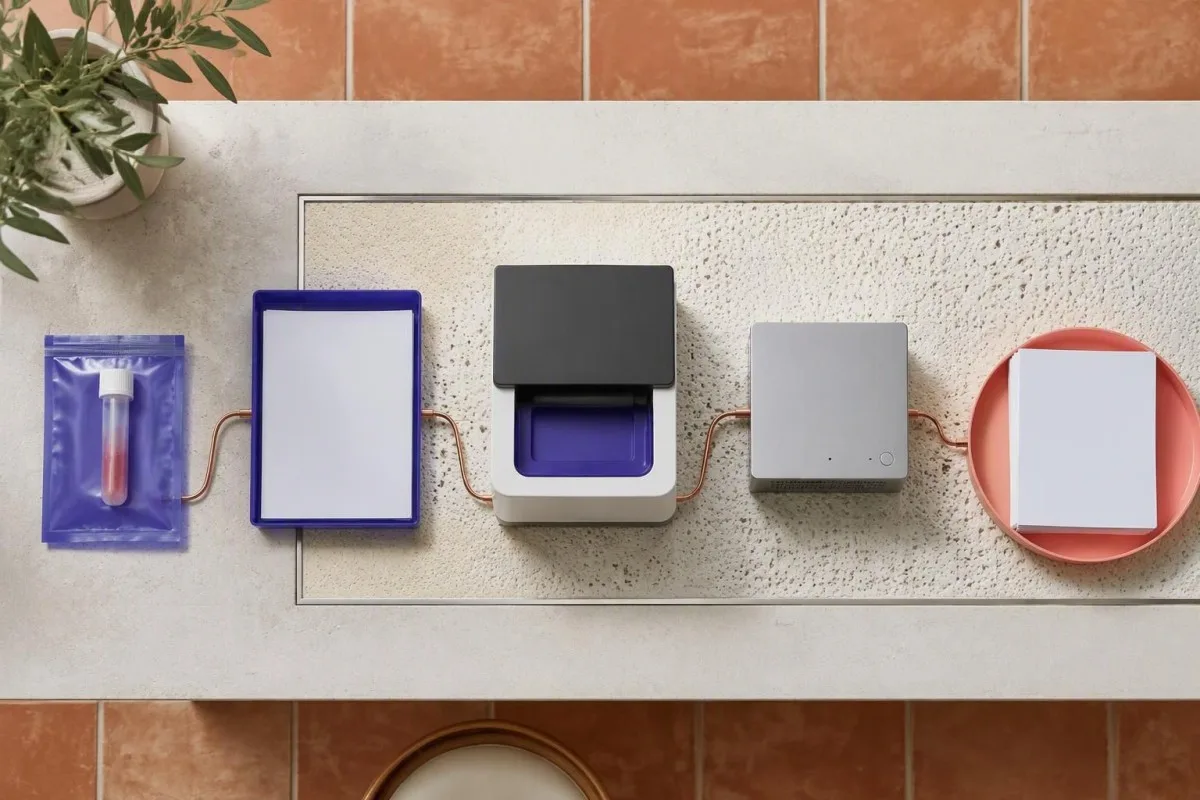
اتصال API فعال، به معنای یکپارچهسازی بالینیِ اعتبارسنجیشده نیست. API B2B ما به بررسیهای اختصاصی هر استقرار درباره نگاشت، احراز هویت، مدیریت پاسخ و رفتار نسخه نیاز دارد؛ سازگاری با EHR یا LIS باید برای رابط واقعی اثبات شود. دستکم ۳ دسته خطا—واحدهای مفقود، شناسههای بیمارِ ناهماهنگ و پاسخهای تکراریِ با تأخیر—را آزمایش کنید، نه اینکه به پذیرش یک درخواست نمایشیِ موفق بسنده کنید.
مقادیر مشتقشده به ورودیهای صریح و منشأ فرمول نیاز دارند. برای مثال، سدیم تصحیحشده به سدیم اندازهگیریشده، گلوکز و روش تصحیح بستگی دارد؛ ضرایب متفاوتِ منتشرشده میتوانند برآوردهای متفاوتی به دست دهند. ما راهنمای تصحیح سدیم مرتبط با گلوکز یک مورد آزمون بالینی ارائه میکند، اما خریداران باید بررسی کنند که گلوکز برحسب mg/dL هرگز بهجای mmol/L در نظر گرفته نشود و هر محاسبهای مفروضات خود را بیان کند.
توافق درباره قالب باید معنا را هم در بر بگیرد، نه فقط چیدمان را. در یک آزمون فرضیِ خروجیگیری از ۳۰۰ گزارش، ممکن است JSON یک پرچم مهم را حفظ کند، در حالی که قالب PDF آن را زیر شکست صفحه پنهان میکند. توصیههای بالینی، عدم قطعیت، واحدها و مُهرهای زمانی را در خروجیهای پشتیبانیشده مقایسه کنید؛ مقادیر خام را تا منبع قابلردیابی نگه دارید و مشخص کنید که آیا نبودن یک فیلد به رد ایمن منجر میشود یا به تفسیری پشتیبانینشده.
گزارشهای سریع و رابط کاربری دوستانه همچنان به شواهد عوامل انسانی نیاز دارند
سرعت و سهولت استفاده، مزایای عملیاتیاند، نه شواهد مستقیمِ دقت تشخیصی. قابلیت تفسیر ما معمولاً در حدود ۶۰ ثانیه توضیحی تولید میکند، اما استقرار بالینی باید تأخیر سرتاسری، درخواستهای ناموفق و بار بازبینی را اندازهگیری کند. زمان پردازش میانه بهتنهایی نشان نمیدهد که آیا نتایج فوری با ایمنی به فرد مناسب میرسند یا نه.
تأخیر باید بهصورت یک توزیع گزارش شود. میانه، صدک ۹۵ و نرخ پایان مهلت را در شرایط استفاده همزمانِ واقعبینانه، از جمله فایلهای بزرگ و عکسهای بیکیفیت، درخواست کنید. میانه فرضیِ ۴۵ ثانیه با صدک ۹۵ِ ۲۴۰ ثانیه، سرویسی بسیار متفاوت از سرویسی را توصیف میکند که همواره در حدود ۶۰ ثانیه کار را کامل میکند؛ هیچیک از این ارقام ثابت نمیکند که درمان زودتر آغاز میشود.
الگوهای آزمایشگاهی فوری به ارائه و ارجاعِ آزمودهشده نیاز دارند. نتیجه پتاسیمِ ۶.۵ mmol/L میتواند نشاندهنده یک فوریت پزشکی باشد، هرچند کیفیت نمونه و زمینه بالینی بر تفسیر اثر میگذارند. راهنمای فوریت الکترولیتها ما از طراحی سناریو پشتیبانی میکند؛ بیمارانی که هشدار آزمایشگاهیِ فوری دریافت میکنند باید بیدرنگ با مرکز درمانی خود تماس بگیرند، نه اینکه منتظر توضیح یک اپلیکیشن بمانند، بهویژه اگر علائمی دارند.
آزمون عوامل انسانی میسنجد که کاربران با گزارش چه میکنند. در دسترسی از طریق وب، iOS، Android و افزونه، خریداران باید دستکم ۳ کار را بررسی کنند: یافتن مقدار اصلی، تشخیص عدم قطعیت و شناسایی اقدام مناسب بعدی. اقدامات نادرست را نیز در کنار زمان تکمیل ثبت کنید، زیرا یک رابط کاربری صیقلی میتواند اعتماد به توصیهای پشتیبانینشده را افزایش دهد و تشخیص سوگیری خودکارسازی را دشوارتر کند.
شواهد امنیت و حریم خصوصی در کنار اعتبارسنجی بالینی جای دارند
ارزیابی حریم خصوصی بررسی میکند که اطلاعات حساس آزمایشگاهی چگونه گردآوری، پردازش، نگهداری، بهاشتراکگذاری و حذف میشوند. همسویی با GDPR رویکردی اعلامشده است، نه جایگزینی برای شواهد قراردادی و فنی. درباره Kantesti Ltd، شرکت بریتانیایی با شماره ثبت 17090423، خریداران باید پیش از ارسال حتی ۱ گزارشِ قابلشناسایی، رابطه و مسئولیتهای قابلاعمالِ کنترلگر و پردازشگر را مشخص کنند.
اطلاعات سلامت به چیزی بیش از حذف نام نیاز دارد. یک گزارش ممکن است حاوی بارکد، تاریخ دقیق تولد، شماره پذیرش یا جزئیات روایی باشد که در ترکیب با اطلاعات دیگر میتواند هویت فردی را آشکار کند. ما اقدامات احتیاطی برای حفظ حریم خصوصی هنگام بارگذاری حداقلسازی عملی را توضیح دهید؛ خریدار باید دستکم ۳ لایه را جداگانه ارزیابی کند: محتوای فایل، فرادادههای حساب و گزارشهای عملیاتی.
ادعاهای امنیتی به دامنهای مشخص و تاریخ شواهد نیاز دارند. ترتیبات رمزگذاری، کنترلهای دسترسی، فهرستهای پردازشگر فرعی، مفاد مربوط به اطلاعرسانی رخدادها و تنظیمات نگهداری را در مستندات حریم خصوصی دادهها. بررسی کنید. اگر تأمینکننده به ممیزیای استناد میکند، بپرسید کدام خدمت و دوره کنترل را پوشش میدهد؛ گزارشی که ۱ مؤلفه زیرساختی را پوشش میدهد، لزوماً دسترسی به برنامه بالینی یا نحوه پردازش دادههای مدل را ارزیابی نمیکند.
استقرار بینالمللی تعهدات بیشتری ایجاد میکند. استفاده در کشورهای 127+ به این معنا نیست که یک قرارداد یا مبنای قانونی همه حوزههای قضایی را پوشش میدهد و انطباق با GDPR به معنای شمول HIPAA یا برآوردهکردن الزامات آن نیست. برای قابلیتهای خانوادگی، مرزهای مجوز را با استفاده از ۲ حساب جداگانه آزمایش کنید؛ از جمله لغو دسترسی و بازیابی حساب. اینکه حذف یک گزارش، نسخههای پشتیبان و گزارشها را هم حذف میکند یا نه، باید صریحاً پاسخ داده شود.
موتور هوش مصنوعی: پیشبینیها و توصیهها را جداگانه اعتبارسنجی کنید
یک موتور هوش مصنوعی برای تفسیر الگوها، پیشبینی خطرهای آینده و توصیههای شخصیسازیشده به اعتبارسنجی اختصاصی هر ادعا نیاز دارد. اینها وظایف متفاوتی هستند، حتی اگر در ۱ گزارش تولید شوند. معماری یادگیری عمیق و تحلیل چندپارامتری نحوه عملکرد یک سامانه را توصیف میکنند؛ اما ثابت نمیکنند که برآوردهای احتمالی، پیشنهادهای تشخیصی یا توصیههای تغذیهای آن از نظر بالینی قابلاعتماد هستند.
تفسیر چندپارامتری باید توضیحات رقیب را حفظ کند. در گزارشی فرضی با فریتین 40 ng/mL و CRP معادل 20 mg/L، فریتین بهتنهایی نمیتواند مسئله دسترسپذیری آهن را حل کند، زیرا فریتین ممکن است در واکنش فاز حاد افزایش یابد. خریدارانی که شبکه عصبی Kantesti را ارزیابی میکنند باید از چنین موارد وابسته به بافتار استفاده کنند، در حالی که توضیح فناوری از شواهدی مبنی بر درستبودن یک نتیجهگیری بالینی مشخص متمایز است.
پیشبینی خطر به پیامد و بازه زمانی مشخصی نیاز دارد. احتمال 20% بدون بیان اینکه چه اتفاقی ممکن است برای چه کسی و در چه بازهای رخ دهد، قابل تفسیر نیست؛ برای مثال، بستریشدن در بیمارستان طی 30 روز، نه شروع بیماری طی 5 سال. TRIPOD+AI گزارشدهی شفاف مطالعات مدلهای پیشبینی را توصیه میکند (Collins و همکاران، 2024)؛ کالیبراسیون و اعتبارسنجی خارجی اهمیت دارند، از جمله برای تحلیل روندهای مرتبط با دارو.
توصیههای شخصیسازیشده، تعهدی جداگانه در زمینه ایمنی ایجاد میکنند. در صورت نبود اطلاعات مربوط به عملکرد کلیه، داروها یا وضعیت بارداری، توصیه تغذیهای ممکن است نامناسب باشد؛ قابلیت Family Health Risk نیز به نحوه برخورد روشن با سابقه نامطمئن یا خوداظهاریشده نیاز دارد. ارزیابی ما ایمنی تغذیه کلیه ما سناریوهای آزمون مرتبطی ارائه میدهد، اما پذیرفتن یک برنامه غذایی ۳ موردی، شاهدی بر بهبود پیامدها یا جایگزینی ایمن برای ارزیابی تغذیهای فردمحور نیست.
نحوهٔ کار تفسیر آزمایش خون با هوش مصنوعی: فهرست بررسی اعتبارسنجی برای خریداران
خریدار باید کل توالی را بیازماید: ثبت منبع، نرمالسازی، تفسیر بافتاری، تولید گزارش و بازبینی بالینی. پیش از آزمودن سامانه ترکیبی، هر مرحله را جداگانه ارزیابی کنید. یک برنامه پذیرش ۵ مرحلهای شناسایی این موضوع را آسانتر میکند که آیا خروجی ناایمن از خوانش نادرست یک مقدار، فرضی نادرست یا توصیهای نامناسب ناشی شده است.
با تعریف کاربرد موردنظر و تثبیت نسخه مورد ارزیابی شروع کنید. مرحله ۱، تهیه فهرستی مکتوب از ادعاها و خطرهاست؛ مرحله ۲، مجموعهدادهای قفلشده و نماینده، با معیارهای واجد شرایط بودن و برچسبهای مرجع ازپیشتعریفشده است. سپس باید ثبت فایلهای PDF یا عکس را با طرحبندیهای تغییریافته، شیوههای نوشتن اعشار و فیلدهای ناخوانا آزمایش کرد؛ موارد ردشده را مستند کنید و بیسروصدا از مخرج نهایی کنار نگذارید.
در ادامه، فرضهای بافتاری و طولی را بیازمایید. مرحله ۳ واحدها، بازههای مرجع و فرادادهها را بررسی میکند؛ مرحله ۴ تفسیرها و توصیهها را با استفاده از دستههای شدتِ دارای معنای بالینی امتیازدهی میکند. راهنمای ما درباره تغییرات بین ویزیتهای آزمایشگاهی چالشی مفید را مطرح میکند: تغییر کراتینین از ۸۰ به ۱۰۰ میکرومول بر لیتر مستلزم درنظرگرفتن زمانبندی، تغییرپذیری سنجش و وضعیت بیمار است، نه اعلام خودکار وخامت.
کار را با تصمیمی درباره استقرار تمام کنید، نه شعاری درباره دقت. مرحله ۵ استفاده آیندهنگر محلی و نحوه رسیدگی به خطاها را بر اساس معیارهایی ارزیابی میکند که پیش از بررسی نتایج مورد توافق قرار گرفتهاند؛ از جمله حدود عدمقطعیت و نحوه ارجاع. پروندهای شامل روند عبور گروهها، نسخه مدل، روبریک کامل امتیازدهی، جدولهای زیرگروهها، نمونههای خروجی نامطلوب و قواعد کنترل تغییرات درخواست کنید؛ هیچ درصدی نمیتواند جایگزین آستانههای پذیرشی شود که با پیامدهای خطا متناسباند.
گزارشهای نمونه و توصیفنامهها: نمونهسازی را از شواهد جدا کنید
یک گزارش نمونه، نحوه ارائه و استدلال را نشان میدهد، درحالیکه یک گواهینامه، برداشت فردی را توصیف میکند. هیچیک دقت در سطح بیمار یا فایده بالینی را اثبات نمیکند. یک بزرگسال ۵۲ساله را بهطور کاملاً فرضی در نظر بگیرید که کراتینین او ۱۱۸ میکرومول بر لیتر، eGFR گزارششده ۵۸ میلیلیتر در دقیقه بهازای ۱٫۷۳ مترمربع است و هیچ نتیجه قبلی در دسترس نیست: توضیح ایمن باید عدمقطعیت را حفظ کند.
یک eGFR پایین بهتنهایی بیماری مزمن کلیه را اثبات نمیکند. KDIGO بیماری مزمن کلیه را با ناهنجاریهای ساختار یا عملکرد کلیه تعریف میکند که دستکم بهمدت ۳ ماه وجود داشته باشند؛ eGFR کمتر از ۶۰ میلیلیتر در دقیقه بهازای ۱٫۷۳ مترمربع، مستلزم ارزیابی مزمنبودن و زمینه بالینی است (گروه کاری KDIGO CKD، ۲۰۲۴). در این مثال فرضی، گزارش باید ارزیابی پزشک و پیگیری مناسب را پیشنهاد کند، نه اینکه بر اساس یک نتیجه، آسیب دائمی کلیه را تشخیص دهد.
برآوردهای مبتنی بر کراتینین ممکن است در افراد با ترکیب بدنی نامتعارف، اطلاعات کمتری ارائه دهند. اگر فرد فرضی بسیار عضلانی باشد یا اخیراً مصرف مکملهایش را تغییر داده باشد، تفسیر باید به این عوامل اذعان کند، نه اینکه نتیجه را نادیده بگیرد. بحث ما درباره کراتینین در بزرگسالان عضلانی زمینه لازم را فراهم میکند؛ KDIGO برای ارزیابی مناسب CKD در بزرگسالان، در صورت دسترسبودن، استفاده از برآورد کراتینین–سیستاتین C را تأیید میکند، نه اینکه برآورد اولیه را قطعی فرض کنیم.
نمایشها باید ورودیهای دشوار و خروجیهای نامطلوب را نیز شامل شوند. یک نتیجه پتاسیم فرضیِ جداگانه، برابر با ۶٫۰ میلیمول بر لیتر و همراه با علامتگذاری مشکل نمونه، اضافه کنید و از محدودیتهای نتیجه مرتبط با همولیز ما برای توضیح این نکته استفاده کنید که چرا هم تأیید نتیجه و هم فوریت آن باید در نظر گرفته شوند. برای Kantesti، یک ارزیابی مفید، مقایسه کورِ گزارشهای کامل است؛ گواهینامههای متخصصان، در صورت ارائه با رضایت آنان، همچنان بازخوردی مبتنی بر تجربهاند و جایگزین چنین آزمونی نمیشوند.
استقبال از آیندهٔ تشخیص: پذیرش مبتنی بر شواهد
تفسیر هوش مصنوعی را فقط در چارچوب کاربردهایی بپذیرید که شواهد از آنها پشتیبانی میکنند، همراه با نظارت محلی و رویهای مستند برای رسیدگی به خطاها. Kantesti ابزاری مبتنی بر هوش مصنوعی برای تحلیل آزمایش خون است؛ مجموعه قابلیتهای ما باید با همان استانداردهای خریدی ارزیابی شود که در اینجا شرح داده شدهاند. شروع با ۱ مورد استفاده محدود، ایمنتر از این فرض است که شواهد را میتوان به همه بیماران و توصیهها تعمیم داد.
معرفی مرحلهای باید امکانپذیری را از اثربخشی متمایز کند. ارزیابی سایهای فرضی شامل ۱۰۰ گزارش میتواند بدون قرار دادن بیماران در معرض توصیههای بازبینینشده، کاستیهای یکپارچهسازی و مشکلات رایج در عبارتپردازی را آشکار کند؛ اما بعید است نرخ پایین خطاهای نادر و جدی را اثبات کند. ارزیابی آیندهنگر گستردهتر به توجیهی برای حجم نمونه و پیامدهایی متناسب با ادعای واقعی نیاز دارد؛ از جمله پیگیریهای غیرضروری و نیز موارد نگرانکنندهای که از قلم افتادهاند.
تغییرات نرمافزار میتوانند عملکردی را که پیشتر اندازهگیری شده است دگرگون کنند. یک مدل جدید، دستورالعمل، پایگاه داده بازههای مرجع یا قالب گزارش ممکن است خروجیها را تغییر دهد، حتی اگر نام محصول ثابت بماند؛ هر ۴ دسته را در سابقه استقرار ثبت کنید. شدت خطا، خودداری از پاسخ، تغییرات عملکرد در زیرگروهها و نادیدهگرفتن توصیهها از سوی کاربران را پایش کنید و مشخص کنید چه زمانی یک تغییر، آزمون رگرسیون هدفمند، ارزیابی محلیِ مجدد یا تعلیق یک قابلیت خاص را ایجاب میکند.
تصمیم برای پذیرش باید بر تحلیل مکتوب شکاف شواهد استوار باشد. مشخص کنید چه مواردی مستقلاً اثبات شدهاند، چه مواردی فقط با آزمون فنی پشتیبانی میشوند و چه مواردی هنوز آزموده نشدهاند؛ سپس برای هر خطر حلنشده، مسئول تعیین کنید. ما کانال تماس خریداران خدمات سلامت محل مناسبی برای درخواست مستندات ویژه دامنه است—ادعایی محدودتر و مستند را به تیتر 99% با مخرج نامشخص ترجیح دهید.
انتشارات پژوهشی: راهنماهای آموزشی را از مطالعات اعتبارسنجی متمایز کنید
۲ ارجاع DOI به مخزن که در زیر آمدهاند، راهنماهای آموزشی را مشخص میکنند، نه مطالعات اعتبارسنجی بالینی نرمافزار تفسیر هوش مصنوعی. DOI شناسهای پایدار فراهم میکند؛ اما داوری همتا، جذب بیمار، ارزیابی مستقل یا اثربخشی بالینی را اثبات نمیکند. خریداران باید هر نشریه ارجاعشده را بر اساس پرسشی که واقعاً میتواند به آن پاسخ دهد، طبقهبندی کنند.
راهنماهای آموزشی میتوانند به تدوین معیارهای اعتبارسنجی کمک کنند، بیآنکه خود محصول را اعتبارسنجی کنند. ما راهنمای کمپلمان و ANA میتواند در مواردی راهگشا باشد که به ۲ اندازهگیری کمپلمان و توضیح دقیق زمینه آنتیبادی نیاز است. توافق با یک راهنما معادل توافق با پیامدهای بیمارانی که بهطور مستقل داوری شدهاند نیست، بهویژه هنگامی که راهنما و نرمافزار ارزیابیشده از یک منبع سازمانی مشترک باشند.
راهنماهای زمانبندی تشخیصی به حالت شکست مفید دیگری میپردازند. ما راهنمای آزمایش تشخیصی نیپا به یک زمینه تشخیصی تخصصی میپردازد؛ نباید از آن چنین برداشت کرد که تفسیر معمول آزمایشگاه، ویروس خاصی را شناسایی میکند. اگر خریدار حتی ۱ ادعای مربوط به پاتوژن با پیامدهای جدی را در کاربرد موردنظر بگنجاند، آن ادعا به شواهد تشخیصی مرتبط و مرزهای مناسب برای ارجاع نیاز دارد.
استانداردهای گزارشدهی مطالعات به ارزیابی کمک میکنند، نه به تأیید عملکرد. STARD 2015 شامل ۳۰ مورد گزارشدهی برای پژوهش دقت تشخیصی است، درحالیکه TRIPOD+AI به گزارشدهی مدلهای پیشبینی میپردازد؛ هیچیک از این چکلیستها مهر تأیید بالینی به نرمافزار نمیدهند. ارجاعات زیر این منابع روششناختی و راهنمای KDIGO سال ۲۰۲۴ را از ۲ مدخل آموزشی DOI جدا میکنند تا خوانندگان بتوانند توصیههای بالینی، راهنمای گزارشدهی و شواهد ویژه محصول را از هم تشخیص دهند.
سوالات متداول
اعتبارسنجی بالینی نرمافزار هوش مصنوعیِ آزمایش خون چیست؟
اعتبارسنجی بالینی ارزیابی میکند که آیا نسخه مشخصی از نرمافزار هوش مصنوعی آزمایش خون، برای بیماران و تصمیمهای موردنظر، خروجیهایی بهاندازه کافی دقیق و ایمن تولید میکند یا خیر. این ارزیابی باید دستکم ۳ وظیفه را از هم تفکیک کند: خواندن گزارش منبع، تفسیر معنای بالینی و توصیه به اقدام. شواهد باید استاندارد مرجع، حجم نمونه در سطح بیمار، آزمون مستقل و نحوه رسیدگی به خطاها را توصیف کنند. توضیحی که از نظر فنی درست است، بهتنهایی بهبود پیامدهای بیمار را ثابت نمیکند.
آیا دقت 99% برای اعتماد به یک تحلیلگر هوش مصنوعی آزمایش خون کافی است؟
ادعای دقت 99% بدون ذکر مخرج، تعریف وظیفه و شدت خطا نمیتواند ایمنی را اثبات کند. در گروهی فرضی که فقط 1% از افراد دچار یک عارضهٔ هدف هستند، نرمافزاری که برچسب منفی به همه میدهد، به دقت 99% دست مییابد، درحالیکه هیچیک از بیماران مبتلا را شناسایی نمیکند. خریداران باید حساسیت، ویژگی، خطاهای گزارش در سطح بیمار و تعداد ورودیهای ردشده را درخواست کنند. توصیههای نادری که خطرناکاند نباید در میانگینی که اظهارات ساده بر آن غالباند، ناپدید شوند.
تفاوت بین یک بنچمارک مصنوعی و اعتبارسنجی بالینی چیست؟
یک بنچمارک مصنوعی، نرمافزار را روی موارد ساختهشده ارزیابی میکند، درحالیکه اعتبارسنجی بالینی مستلزم شواهد متناسب با جمعیت بیمار و ادعای بالینی موردنظر است. حتی ۱۰۰٬۰۰۰ مورد مصنوعی نیز نمیتواند شیوع در دنیای واقعی، سودمندی بالینی یا عملکرد در برابر همه مشکلات مربوط به سوابق ناقص و کیفیت نمونه را اثبات کند. آزمون مصنوعی میتواند به شناسایی نقصهای فنی و پشتیبانی از بررسیهای رگرسیون کمک کند. این آزمون باید مکمل ارزیابیهای خارجی و آیندهنگرِ نماینده باشد، نه جایگزین آنها.
هوش مصنوعی در حوزه مراقبتهای سلامت به چه میزان آزمایش مستقل نیاز دارد؟
هوش مصنوعی در حوزه سلامت به آزمون مستقل متناسب با پیامدهای خروجی نادرست نیاز دارد، نه حداقل تعداد گزارشِ یکسان برای همه. مشاهدهٔ ۰ مورد خطا در ۱۰۰ مورد مستقل، بر اساس قاعدهٔ سه، حد بالای تقریبی نرخ خطا را نزدیک به ۳٪ باقی میگذارد. خریداران باید دادههای آزمونِ محافظتشده، نسخهٔ ثابتشدهٔ مدل و روابط افشاشدهٔ ارزیابان را مطالبه کنند. ادعاها دربارهٔ خطاهای جدیِ نادر معمولاً به شواهد بیشتری از آنچه یک مطالعهٔ مقدماتی کوچکِ کاربردپذیری یا امکانسنجی میتواند فراهم کند، نیاز دارند.
آیا پشتیبانی از ۱۰۰ زبان به معنای دقت یکسان در همهٔ زبانهاست؟
0 پشتیبانی از ۱۰۰ زبان، دقت بالینی یکسان را در همهٔ این زبانها ثابت نمیکند. ارزیابی مختص هر زبان باید استخراج ورودی، شیوهٔ نگارش اعشار، واحدها، نفی و معنای توصیهها را بیازماید. برای مثال، نباید مقدار گلوکزِ نوشتهشده بهصورت 5,6 mmol/L را 56 mmol/L تفسیر کرد. خریداران باید مخرجهای مختص هر زبان را درخواست کنند و مشخص سازند که کدام زبانها هنوز بررسی بالینی نشدهاند.
آیا هوش مصنوعی میتواند بیماری مزمن کلیه را بر اساس یک نتیجه پایین eGFR تشخیص دهد؟
یک نتیجه eGFR کمتر از 60 mL/min/1.73 m² بهتنهایی نشاندهنده بیماری مزمن کلیه نیست. دستورالعمل KDIGO سال 2024، بیماری مزمن کلیه را بر اساس وجود ناهنجاریهای کلیوی به مدت دستکم 3 ماه تعریف میکند و ارزیابی مزمنبودن و زمینه بالینی را لازم میداند. تغییرات حاد، ترکیب بدن و عوامل دیگر میتوانند بر تفسیر اثر بگذارند. نرمافزار هوش مصنوعی باید عدمقطعیت را توضیح دهد و از پیگیری پزشک پشتیبانی کند، نه اینکه یک برآورد منفردِ کاهشیافته را بهعنوان بیماری دائمی برچسبگذاری کند.
چگونه نتایج آزمایش خون را بخوانیم
گزارش آزمایشگاهی خود را بارگذاری کنید تا هوش مصنوعی Kantesti ظرف چند ثانیه هر زیستنشانگر را به زبان ساده توضیح دهد. بیش از 2 میلیون نفر در سراسر جهان از آن استفاده کردهاند.
منابع
- Klein, T., Mitchell, S., & Weber, H. (2025). راهنمای آزمایش خون C3 و C4 کمپلمان و تیتر ANA. پژوهش پزشکی هوش مصنوعی Kantesti. DOI
- Klein, T., Mitchell, S., & Weber, H. (2025). آزمایش خون ویروس نیپا: راهنمای تشخیص و شناسایی زودهنگام ۲۰۲۶. پژوهش پزشکی هوش مصنوعی Kantesti. DOI
- Bossuyt PM et al. (2015). STARD 2015: فهرست بهروزشده موارد ضروری برای گزارش مطالعات دقت تشخیصی. BMJ. DOI پابمد
- Collins GS et al. (2024). بیانیه TRIPOD+AI: راهنمای بهروزشده برای گزارش مدلهای پیشبینی بالینی که از روشهای رگرسیون یا یادگیری ماشین استفاده میکنند. BMJ. DOI
- گروه کاری بیماری مزمن کلیه سازمان Kidney Disease: Improving Global Outcomes (KDIGO) (2024). راهنمای بالینی KDIGO 2024 برای ارزیابی و مدیریت بیماری مزمن کلیه. Kidney International. DOI
- ۲ میلیون+آزمایشهای تجزیهوتحلیلشده
- 127+کشورها
- 100+زبانها
درباره تیم پزشکی


سیگنالهای اعتماد E-E-A-T
تجربه
بازبینی بالینی مبتنی بر نظر پزشک از فرایندهای تفسیر آزمایشگاه.
تخصص
تمرکز بر پزشکی آزمایشگاهی و اینکه نشانگرهای زیستی در زمینه بالینی چگونه رفتار میکنند.
اقتدارگرایی
با بازبینی پزشکی دکتر توماس کلاین، با مشارکت دکتر سارا میچل و پروفسور دکتر هانس وبر.
قابل اعتماد بودن
تفسیر مبتنی بر شواهد با مسیرهای پیگیری روشن برای کاهش هشدارها.
سلب مسئولیت پزشکی
این مقاله فقط برای اهداف آموزشی است و توصیه پزشکی محسوب نمیشود. برای تصمیمهای مربوط به تشخیص و درمان، همیشه با یک ارائهدهنده مراقبتهای بهداشتی واجد شرایط مشورت کنید.
منتشر شد · بهروزرسانیشده · با تیم تحریریه تماس بگیرید
منتشرشده توسط Kantesti Ltd، ثبتشده در انگلستان و ولز، شماره شرکت. 17090423, ، لندن، بریتانیا.
