
Klinisk validering betyder at teste, om software leverer tilstrækkeligt nøjagtige og sikre fortolkninger for de tiltænkte patienter – ikke blot om den genererer overbevisende rapporter.

Vigtigste pointer
- Valideringens omfang skal identificere de tiltænkte patienter, laboratorieinput og kliniske beslutninger; succes med 1 opgave kan ikke fastslå sikkerhed på tværs af alle anvendelser.
- Nævnere for nøjagtighed bør skelne mellem patienter, rapporter, biomarkører og enkeltstående udsagn; 10.000 udsagn kan stamme fra blot 200 rapporter.
- Følsomhed måler detekterede reference-positive tilfælde; et hypotetisk resultat på 90/100 betyder, at 10 berørte tilfælde blev overset.
- Prædiktiv værdi afhænger af prævalensen: Ved en prævalens på 1% giver en sensitivitet på 90% og en specificitet på 95% en positiv prædiktiv værdi på cirka 15.4%.
- Uafhængig testning kræver beskyttede testdata, en fastfrosset softwareversion og oplysning om, hvem der udformede, finansierede og bedømte evalueringen.
- Dokumentation for undergrupper skal omfatte stikprøvestørrelser og usikkerhed; 0 oversete fund blandt 20 positive tilfælde dokumenterer ikke perfekt sensitivitet.
- Operationel hastighed på cirka 60 sekunder beskriver vores fortolkningsfunktion, ikke en påvist reduktion i diagnostiske fejl eller behandlingsforsinkelser.
- Kriterier for ibrugtagning bør omfatte patientsikkerhed på individniveau, sprogspecifik ydeevne, fejl i input og en dokumenteret håndtering af softwareændringer.
AI's fremmarch inden for medicinsk diagnostik: Hvad validering betyder
Validering af AI-blodprøver kræver dokumentation for, at en bestemt softwareversion leverer nøjagtige og sikre fortolkninger for de tiltænkte patienter og beslutninger. Købere bør undersøge nævnere på patientniveau, uafhængig testning, resultater for undergrupper og fejlhåndtering – ikke kun en fremhævet nøjagtighedsprocent. Kantesti er en AI-blodprøveanalysator, hvis resultater bør underlægges de samme dokumentationskrav.
Fortolkningssoftware måler ikke den oprindelige prøve. En laboratorieanalysator genererer værdier som natrium på 138 mmol/L; fortolkningssoftware aflæser derefter disse værdier og forklarer deres mulige betydning, hvilket giver endnu en mulighed for fejl, selv når laboratoriemålingen er korrekt. Købere har derfor brug for særskilt dokumentation for ekstraktionsnøjagtighed, håndtering af referenceintervaller og klinisk ræsonnering.
Klinisk validitet og klinisk nytte besvarer forskellige spørgsmål. En evaluering kan vise overensstemmelse på tværs af 500 rapporter uden at vise, at patienterne får bedre behandling, undgår unødvendige undersøgelser eller forstår usikkerhed mere præcist. Vores guide til forklaring af lægerapporter forklarer, hvorfor forståelig formulering stadig kræver kontrol af kilden og passende grænser for eskalering.
Adoptionsstatistik kan ikke træde i stedet for et klinisk studie. Vores platformsrapporterede rækkevidde på 2M+ brugere i 127+ lande beskriver brug, ikke en repræsentativ valideringskohorte med bekræftede resultater. Den virksomhedsbaggrund bidrager til at fastlægge organisatorisk ansvarlighed; et særskilt dokumentationsmateriale skal identificere den præcise tilsigtede anvendelse, den egnede patientgruppe og konsekvenserne af en forkert fortolkning.
Påstande om nøjagtighed: Opgør patienter, rapporter og beslutninger hver for sig
En påstand om nøjagtighed kan kun fortolkes, når tæller, nævner og scoringsregler er oplyst. Et tal som 98.49% kunne beskrive ekstraherede felter, godkendte udsagn eller klassificerede tilfælde – meget forskellige opgaver. Her er tallet et eksempel på en fremhævet påstand, der kræver nærmere granskning, ikke et uafhængigt verificeret resultat af klinisk ydeevne.
Gentagne udsagn er ikke uafhængige patienter. I en hypotetisk evaluering giver 200 rapporter med 50 scorede udsagn hver 10.000 observationer på udsagnsniveau, men stadig kun 200 rapporter. En korrekt forklaring af natrium på 140 mmol/L bør ikke opveje en farlig anbefaling et andet sted i samme rapport; kræv både scoring på udsagnsniveau og andelen af rapporter med klinisk betydningsfulde fejl.
Udelukkede input kan få pålideligheden til at se større ud, end den er. Antag, at 1.000 rapporter indsendes, 100 afvises, og 882 af de resterende 900 består vurderingskriterierne: nøjagtigheden blandt færdigbehandlede rapporter er 98%, mens andelen af indsendelser med et vellykket og acceptabelt resultat er 88.2%. Ingen af nævnerne er i sig selv vildledende, men købere har brug for begge samt årsagerne til afvisning, og om afviste tilfælde i uforholdsmæssig grad omfatter akutte abnormiteter.
Den offentliggjorte metode bør definere, hvad der blev regnet som korrekt, før scoringen begyndte. STARD 2015-rapporteringsstandarden beder studier af diagnostisk nøjagtighed om at beskrive deltagerudvælgelse, referencestandarden og deltagerflowet (Bossuyt et al., 2015). Vores side med valideringsmetoder er et udgangspunkt for spørgsmål om Kantesti; det bør ikke betragtes som dokumentation for uafhængig ydeevne på patientniveau uden det underliggende studiemateriale.
Sensitivitet, specificitet og prædiktiv værdi besvarer forskellige spørgsmål
Sensitivitet måler påvisning blandt referencepositive tilfælde; specificitet måler korrekte negative resultater blandt referencenegative tilfælde. Positiv prædiktiv værdi måler, hvor ofte et positivt output er korrekt i den testede kontekst. For et hypotetisk værktøj med en sensitivitet på 90% og en specificitet på 95% ved en prævalens på 1% er den positive prædiktive værdi cirka 15.4%.
En forvekslingsmatrix gør afvejningen synlig. Blandt 10.000 hypotetiske patienter ved en prævalens på 1% har 100 den pågældende tilstand: 90 påvises, og 10 overses. Af de 9.900, der ikke har den, får 495 falsk positive output; følgelig er kun 90 af 585 positive output korrekte, selv om den samlede nøjagtighed er 94.95%.
Præcision er ikke et universelt synonym for nøjagtighed. Inden for klassifikation betyder præcision almindeligvis positiv prædiktiv værdi, mens en leverandørs rubric til vurdering af fortællende tekst kan bruge ordet anderledes. Vores drøftelse af bekræftelse af lavt positivt antistofresultat illustrerer det kliniske princip: Fortolkningen afhænger af prætestsandsynlighed og bekræftelse, ikke blot af, om et indledende resultat overskrider en tærskel.
Valget af tærskel ændrer balancen mellem oversete tilfælde og falske alarmer. Bed om forvekslingsmatricen ved den foreslåede implementeringstærskel, ikke kun en ydeevnekurve, der spænder over mange tærskler. I et hypotetisk studie af et alarmsystem kan en sænkning af tærsklen fra 0.7 til 0.4 forbedre sensitiviteten og samtidig fordoble antallet af falske alarmer; købere må afgøre, om denne afvejning passer til de kliniske konsekvenser og kapaciteten til gennemgang.
Uafhængig testning kræver et beskyttet datasæt og en troværdig referencestandard
Uafhængig testning evaluerer en fastlåst model på data, der ikke var tilgængelige under udviklingen, med oplyste relationer til evaluatorerne og en klinisk forsvarlig referencestandard. Eksterne data alene garanterer ikke en uafhængig evaluering. Et studie med 3 hospitaler kan stadig have skævt mærkede data, delte datapipelines eller testtilfælde, der har påvirket modeltilpasningen.
Adskillelse på patientniveau forebygger en almindelig form for datalækage. Hvis en patients januarrapport indgår i træningsdata, og patientens februarrapport indgår i testdata, kan modellen drage fordel af tilbagevendende mønstre eller identifikatorer. Købere bør spørge, hvordan dublerede patienter, gentagne indlæggelser og rapporter fra 2 sammenkoblede laboratoriesystemer blev identificeret, og om det endelige testsæt forblev uberørt efter valg af model og prompt.
Referencestandarden skal stemme overens med påstanden. Ekspertkonsensus om 300 fortolkninger kan vurdere rapportkvaliteten, men bekræfter ikke automatisk sygdomsforekomst eller fremtidige udfald. Forskellen kendes fra assayets nøjagtighed og tidspunktet: den test, der evalueres, sammenligningsgrundlaget og tidspunktet for bekræftelse kan hver især ændre den tilsyneladende ydeevne.
Syntetiske benchmarks tester konstruerede tilfælde, ikke sygdomsprævalens eller klinisk nytte i den virkelige verden. Selv 100.000 syntetiske scenarier kan ikke genskabe alle manglende sygehistorier, prøverelaterede artefakter eller uventede præsentationer. For påstande om grænser for fortolkning af troponin, kræver et studie de kliniske oplysninger og den diagnostiske opfølgning, der er relevante for påstanden; en korrekt sætning om en laboratorietærskel er ikke en bekræftet diagnose.
Resultater for undergrupper kan afsløre risici, der skjules af gennemsnittet
Validering af undergrupper undersøger, om ydeevnen ændrer sig på tværs af klinisk relevante patientgrupper og inputbetingelser. Købere bør anmode om nævnere, fejlens alvorlighed og konfidensintervaller for børn, ældre voksne, gravide, personer med nedsat nyrefunktion og andre tilsigtede populationer. Hvis der observeres 0 oversete tilfælde blandt 20 referencepositive tilfælde, er der stadig betydelig usikkerhed om den reelle andel af oversete tilfælde.
Aldersspecifikke referenceintervaller kan ikke erstatte hinanden. En pædiatrisk fortolkning kan ikke uden videre arve alle voksentærskler, selv når den underliggende analyttype og enhed er identiske. Vores vejledning om AI-fortolkning for børn forklarer sikkerhedsgrænsen; købere bør anmode om faktiske antal i aldersgrupper i stedet for at acceptere en bred påstand, der omfatter patienter fra 1 til 18 år.
Biologisk kontekst betyder mere end demografiske genveje. Et absolut neutrofiltal på 1.2 × 10^9/L kan kræve en anden ræsonnering hos en stabil person med et Duffy-null-associeret neutrofiltal end hos en person med et nyt fald under behandling. Den forklaring af Duffy-null-neutrofiler understøtter et målrettet testtilfælde; etnicitet alene må ikke bruges til at antage genotype eller klinisk sikkerhed.
Små stikprøver kan skjule klinisk betydningsfulde fejlprocenter. Den omtrentlige tre-regel betyder, at 0 observerede hændelser i 20 uafhængige observationer svarer til en øvre 95%-grænse på omkring 15%, ikke 0%. Sammenligninger mellem undergrupper kræver også patientklyngeanalyse, når rapporter gentages; et studie bør oplyse, hvilke grupper der ikke er testet, frem for at betragte en ikke-signifikant forskel som bevis på, at ydeevnen er tilsvarende.
Flersproget understøttelse kræver sikkerhedstestning for hvert sprog
Flersproget validering undersøger, om den kliniske betydning bevares gennem oversættelse, talformatering og patientrettet forklaring på hvert tilsigtet sprog. Kantesti er en AI-platform til fortolkning af blodprøve med understøttelse af 100+ sprog; denne funktion dokumenterer ikke i sig selv tilsvarende klinisk ydeevne på tværs af disse sprog. Hvert sprog kræver en passende evalueringsstrategi og oplyst dækningsgrad.
Decimalkonventioner kan ændre den fortolkede værdi. Et glukoseresultat skrevet som 5,6 mmol/L i ét lokalformat må ikke blive til 56 mmol/L efter udtræk, og en enhedskonvertering skal bevare den kliniske betydning frem for blot at erstatte tegnsætning. Evaluer input på originalsproget og oversatte outputs separat; test af kun engelske laboratorierapporter oversat til 10 sprog overser fejl på inputsiden.
Negation og resultattypen fortjener særskilte testtilfælde. Udsagn som ikke påvist, under kvantificeringsgrænsen og kan ikke udelukkes formidler forskellige grader af sikkerhed. Vores kvalitativ versus kvantitativ vejledning forklarer forskellen; en tosproget vurderingsrubrik bør teste disse betydninger, herunder ulighedssymboler som mindre end 0.1, i stedet for kun at belønne flydende formuleringer.
Læsbarhed garanterer ikke forståelse. En nyttig sprogevaluering kunne bede deltagere om at identificere den nødvendige handling og usikkerheden efter at have læst 3 korte rapporter, samtidig med at det registreres, om oversættelsen ændrer hastende karakter eller medicinråd. Dette er foreslåede evalueringsopgaver, ikke en valideret universel tærskel; sprog med færre ressourcer kan kræve yderligere gennemgang, fordi tilgængelig klinisk terminologi og uddannelsesdækning varierer.
API-integration og rapportformater skal bevare den kliniske betydning
Integrationsvalidering undersøger, om patientidentitet, værdier, enheder, datoer og advarsler forbliver korrekte på tværs af systemgrænser. HTML-, JSON- og PDF-outputs bør formidle det samme kliniske indhold, når disse formater understøttes. Et natriumresultat på 128 mmol/L må ikke ændre betydning, fordi et output udelader en advarsel, eller et andet afkorter et felt.
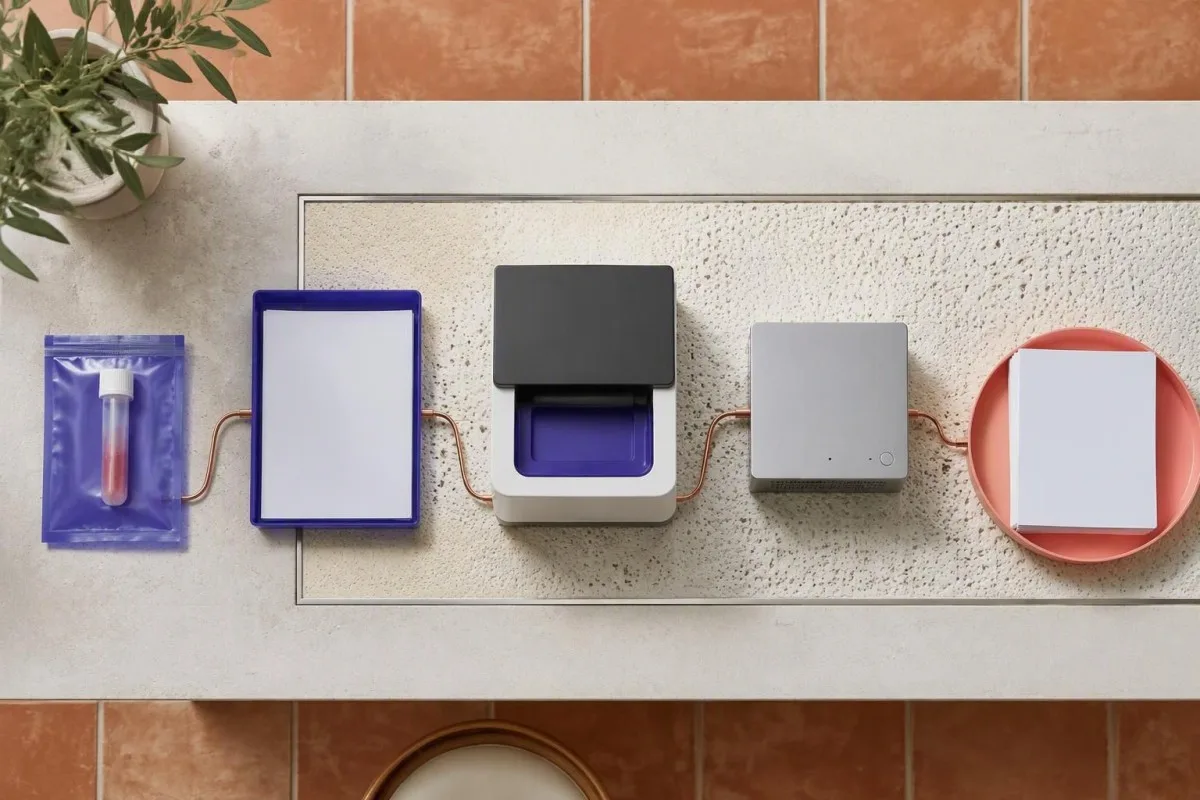
En fungerende API-forbindelse er ikke en valideret klinisk integration. Vores B2B-API kræver implementeringsspecifik kontrol af mapping, autentificering, håndtering af svar og versionsadfærd; kompatibilitet med EHR eller LIS bør påvises for den faktiske grænseflade. Test mindst 3 fejlkategorier — manglende enheder, uoverensstemmende patientidentifikatorer og forsinkede duplikerede svar — i stedet for at acceptere én vellykket demonstrationsanmodning.
Afledte værdier kræver eksplicitte input og dokumentation af formlens oprindelse. Korrigeret natrium afhænger for eksempel af målt natrium, glukose og korrektionsmetoden; forskellige publicerede koefficienter kan give forskellige estimater. Vores vejledning til korrektion af natrium relateret til glukose giver et klinisk testtilfælde, men købere bør kontrollere, at glukose i mg/dL aldrig behandles som mmol/L, og at enhver beregning angiver sine antagelser.
Aftaler om format bør også omfatte betydning, ikke kun layout. I en hypotetisk eksporttest med 300 rapporter kan JSON bevare en kritisk markering, mens en PDF-skabelon skjuler den under et sideskift. Sammenlign kliniske anbefalinger, usikkerhed, enheder og tidsstempler på tværs af understøttede outputformater; sørg for, at råværdier kan spores til kilden, og angiv, om et manglende felt medfører en sikker afvisning eller en ikke-understøttet fortolkning.
Hurtige rapporter og en brugervenlig grænseflade kræver stadig dokumentation for menneskelige faktorer
Hurtighed og brugervenlighed er driftsmæssige fordele, ikke direkte dokumentation for diagnostisk nøjagtighed. Vores fortolkningsfunktion genererer typisk en forklaring på cirka 60 sekunder, men klinisk implementering bør måle forsinkelse fra start til slut, mislykkede anmodninger og arbejdsbyrden ved gennemgang. En medianbehandlingstid alene kan ikke vise, om hastesvar når frem til den rette person på sikker vis.
Ventetid bør rapporteres som en fordeling. Bed om medianen, 95-percentilen og timeout-raten ved realistisk samtidig brug, herunder store filer og fotos af dårlig kvalitet. En hypotetisk median på 45 sekunder med en 95-percentil på 240 sekunder beskriver en helt anden tjeneste end én, der konsekvent afsluttes tæt på 60 sekunder; ingen af tallene dokumenterer, at behandlingen påbegyndes hurtigere.
Hastekrævende laboratoriemønstre kræver afprøvet præsentation og eskalering. Et kaliumresultat på 6.5 mmol/L kan være tegn på en medicinsk nødsituation, selvom prøvens kvalitet og den kliniske kontekst påvirker fortolkningen. Vores vejledning om hastende elektrolytværdier understøtter udformningen af scenarier; patienter med en hastekrævende laboratoriealarm bør straks kontakte det behandlende sted i stedet for at vente på en forklaring fra en app, især hvis der er symptomer.
Test af menneskelige faktorer måler, hvad brugerne gør med rapporten. På tværs af web, iOS, Android og adgang via udvidelser bør købere undersøge mindst 3 opgaver: at finde den oprindelige værdi, genkende usikkerhed og identificere den næste passende handling. Registrer også forkerte handlinger samt gennemførelsestid, fordi en poleret grænseflade kan øge tilliden til en ikke-understøttet anbefaling og gøre automatiseringsbias sværere at opdage.
Dokumentation for sikkerhed og privatliv hører sammen med klinisk validering
Vurdering af privatliv kontrollerer, hvordan følsomme laboratorieoplysninger indsamles, behandles, opbevares, deles og slettes. Håndtering i overensstemmelse med GDPR er en erklæret tilgang, ikke en erstatning for kontraktmæssig og teknisk dokumentation. For Kantesti Ltd, britisk virksomhedsnummer 17090423, bør købere fastslå, hvilke dataansvarsroller og hvilket ansvar der gælder, før de sender blot 1 identificerbar rapport.
Sundhedsoplysninger kræver mere end blot at fjerne et navn. En rapport kan indeholde en stregkode, præcis fødselsdato, prøvenummer eller beskrivende oplysninger, som kan identificere nogen, når de kombineres med andre oplysninger. Vores forholdsregler ved upload for at beskytte privatlivets fred forklarer praktisk minimering; en køber bør evaluere mindst 3 lag separat: filindhold, kontometadata og driftslogs.
Sikkerhedspåstande kræver et defineret omfang og en evidensdato. Gennemgå krypteringsordninger, adgangskontroller, lister over underdatabehandlere, vilkår for hændelsesmeddelelser og indstillinger for opbevaring i dokumentationen om databeskyttelse. Hvis en leverandør henviser til en revision, så spørg, hvilken tjeneste og kontrolperiode den dækker; en rapport, der dækker 1 infrastrukturkomponent, vurderer ikke automatisk adgang til kliniske applikationer eller håndtering af modeldata.
International implementering medfører yderligere forpligtelser. Brug på tværs af 127+ lande betyder ikke, at én kontrakt eller ét retsgrundlag dækker alle jurisdiktioner, og overensstemmelse med GDPR indebærer ikke, at HIPAA finder anvendelse eller at kravene heri er opfyldt. For familiefunktioner skal tilladelsesgrænser testes ved hjælp af 2 separate konti, herunder tilbagetrækning af adgang og kontogendannelse; om sletning af en rapport også fjerner sikkerhedskopier og logs kræver et udtrykkeligt svar.
AI-motoren: Valider forudsigelser og anbefalinger hver for sig
En AI-motor kræver validering, der er specifik for påstanden, ved mønstertolkning, forudsigelse af fremtidig risiko og personlige anbefalinger. Det er forskellige opgaver, selv når de genereres i 1 rapport. Deep learning-arkitektur og analyse af flere parametre beskriver, hvordan et system fungerer; de beviser ikke, at dets sandsynlighedsestimater, diagnostiske forslag eller kostråd er klinisk pålidelige.
Fortolkning af flere parametre bør bevare konkurrerende forklaringer. I en hypotetisk rapport med ferritin på 40 ng/mL og CRP på 20 mg/L kan ferritin alene ikke afgøre spørgsmålet om jerntilgængelighed, fordi ferritin kan stige som følge af en akut fasereaktion. Købere, der evaluerer Kantesti's neurale netværk, bør bruge sådanne kontekstfølsomme tilfælde, mens teknologisk forklaring forbliver adskilt fra evidens for, at en specifik klinisk konklusion er korrekt.
Risikoforudsigelse kræver et defineret udfald og en tidshorisont. En sandsynlighed på 20% er umulig at fortolke uden at angive, hvad der kan ske, for hvem og over hvilken periode – for eksempel hospitalsindlæggelse inden for 30 dage snarere end sygdomsdebut inden for 5 år. TRIPOD+AI anbefaler transparent rapportering af studier af prædiktionsmodeller (Collins et al., 2024); kalibrering og ekstern validering er vigtige, også for analyse af medicinrelaterede tendenser.
Personlige råd medfører en særskilt sikkerhedsforpligtelse. En ernæringsanbefaling kan være uhensigtsmæssig, hvis oplysninger om nyrefunktion, medicin eller graviditet mangler; Family Health Risk kræver ligeledes tydelig håndtering af usikker eller selvrapporteret sygehistorik. Vores nyreernæringsvejledning tilbyder relevante testscenarier, men det er ikke evidens for, at en madplan med 3 punkter forbedrer resultaterne eller sikkert erstatter en individuel diætetisk vurdering, at man accepterer den.
Sådan fungerer AI-fortolkning af blodprøver: En valideringstjekliste for købere
En køber bør teste hele forløbet: kildeindlæsning, normalisering, kontekstuel fortolkning, rapportgenerering og klinisk gennemgang. Evaluer hvert trin separat, før det samlede system testes. En acceptplan i 5 faser gør det lettere at identificere, om et usikkert output begyndte med en fejllæst værdi, en forkert antagelse eller en uhensigtsmæssig anbefaling.
Begynd med at definere den tilsigtede anvendelse og fastfryse den evaluerede version. Trin 1 er en skriftlig oversigt over påstande og risici; trin 2 er et låst, repræsentativt datasæt med på forhånd fastlagte kriterier for egnethed og referencemærkater. PDF- eller fotoregistrering bør derefter testes med ændrede layout, decimalkonventioner og ulæselige felter; dokumentér afvisninger i stedet for lydløst at udelukke dem fra den endelige nævner.
Test derefter kontekst og longitudinelle antagelser. Trin 3 kontrollerer enheder, referenceintervaller og metadata; trin 4 vurderer fortolkninger og anbefalinger ved hjælp af klinisk meningsfulde alvorlighedskategorier. Vores guide til ændringer mellem laboratoriebesøg understøtter en nyttig udfordring: En kreatininændring fra 80 til 100 µmol/L kræver, at man tager højde for tidspunkt, analysevariation og patienten, ikke automatisk erklærer en forværring.
Afslut med en beslutning om implementering, ikke et slogan om nøjagtighed. Trin 5 evaluerer prospektiv lokal anvendelse og håndtering af fejl i forhold til kriterier, der er aftalt, før resultaterne undersøges, herunder usikkerhedsgrænser og eskaleringsadfærd. Anmod om et dossier med kohorteflow, modelversion, komplet vurderingsrubrik, undergruppetabeller, eksempler på skadelige output og regler for ændringskontrol; ingen universel procent kan erstatte acceptgrænser, der er tilpasset konsekvenserne af fejl.
Eksempelrapporter og udtalelser: Skeln mellem illustration og dokumentation
En eksempelrapport demonstrerer præsentation og ræsonnement, mens en udtalelse beskriver et individuelt indtryk. Ingen af delene fastslår nøjagtighed på patientniveau eller klinisk fordel. Overvej en klart hypotetisk 52-årig voksen med kreatinin på 118 µmol/L, rapporteret eGFR på 58 mL/min/1,73 m² og ingen tilgængelige tidligere resultater: Den sikre forklaring skal bevare usikkerheden.
Én reduceret eGFR fastslår ikke kronisk nyresygdom. KDIGO definerer kronisk nyresygdom som abnormiteter i nyrernes struktur eller funktion, der har været til stede i mindst 3 måneder; en eGFR under 60 mL/min/1,73 m² kræver vurdering af kroniskhed og kontekst (KDIGO CKD Work Group, 2024). I dette hypotetiske eksempel bør en rapport foreslå en klinisk vurdering og relevant opfølgning, ikke diagnosticere permanent nyreskade ud fra ét resultat.
Kreatininbaserede estimater kan være mindre informative ved usædvanlig kropssammensætning. Hvis den hypotetiske person er meget muskuløs eller for nylig har ændret kosttilskud, bør fortolkningen anerkende disse faktorer frem for at afvise resultatet. Vores gennemgang af kreatinin hos muskuløse voksne giver kontekst; KDIGO anbefaler estimering baseret på kreatinin–cystatin C, hvor det er tilgængeligt, ved relevant vurdering af CKD hos voksne, frem for at antage, at det oprindelige estimat er endegyldigt.
Demonstrationer bør omfatte vanskelige input og ugunstige output. Tilføj et separat hypotetisk kaliumresultat på 6.0 mmol/L med et flaget prøveproblem, og brug vores begrænsninger for resultater relateret til hæmolyse til at forklare, hvorfor både bekræftelse og hastende indsats skal overvejes. For Kantesti er en nyttig evaluering en blindet sammenligning af komplette rapporter; professionelle udtalelser, hvis de fremlægges med samtykke, er fortsat erfaringsbaseret feedback og kan ikke erstatte sådan testning.
At tage diagnostikkens fremtid til sig: Evidensbaseret indførelse
Tag kun AI-fortolkning i brug til anvendelser, der er understøttet af evidens, med lokalt tilsyn og en dokumenteret reaktion på fejl. Kantesti er et AI-drevet værktøj til analyse af blodprøver; vores funktionssæt bør vurderes efter de samme indkøbsstandarder, som beskrives her. Det er sikrere at starte med 1 begrænset anvendelsesområde end at antage, at evidensen gælder for alle patienter og anbefalinger.
En trinvis introduktion bør skelne mellem gennemførlighed og effektivitet. En hypotetisk evaluering af 100 rapporter i skyggetilstand kan afdække integrationsfejl og almindelige problemer med formuleringer uden at udsætte patienter for ikke-gennemgåede anbefalinger, men den vil næppe fastslå en lav hyppighed af sjældne alvorlige fejl. En bredere prospektiv evaluering kræver en begrundelse for stikprøvestørrelsen og effektmål, der svarer til den faktiske påstand, herunder unødvendig opfølgning såvel som oversete problemer.
Softwareændringer kan ændre tidligere målt ydeevne. En ny model, prompt, database med referenceintervaller eller rapportskabelon kan ændre output, selv når produktnavnet forbliver det samme; registrer alle 4 kategorier i implementeringshistorikken. Overvåg fejlens alvorlighed, afståelser, undergruppedrift og brugerens tilsidesættelser, og fastlæg, hvornår en ændring udløser målrettet regressionstestning, fornyet lokal evaluering eller suspendering af en bestemt funktion.
Beslutningen om at indføre løsningen bør baseres på en skriftlig analyse af evidenshuller. Identificér, hvad der er uafhængigt fastslået, hvad der kun understøttes af teknisk testning, og hvad der stadig er uprøvet; udpeg derefter en ansvarlig for hver uløst risiko. Vores kontaktkanal for sundhedsindkøbere er det rette sted at anmode om dokumentation, der er specifik for anvendelsesområdet – foretræk en snævrere, underbygget påstand frem for en 99%-overskrift med en uklar nævner.
Forskningspublikationer: Skeln mellem vejledninger til undervisningsbrug og valideringsstudier
De 2 DOI-referencer til arkivet nedenfor identificerer vejledninger til undervisningsformål, ikke kliniske valideringsstudier af software til AI-fortolkning. En DOI angiver en vedvarende identifikator; den dokumenterer ikke fagfællebedømmelse, rekruttering af patienter, uafhængig evaluering eller klinisk effektivitet. Købere bør klassificere hver citeret publikation efter det spørgsmål, den faktisk kan besvare.
Vejledninger til undervisningsformål kan bidrage til at udarbejde et valideringskriteriesæt uden selv at validere produktet. Vores komplement- og ANA-guiden kan informere om tilfælde, hvor 2 komplementmålinger og antistofkontekst kræver en omhyggelig forklaring. Overensstemmelse med en vejledning er ikke det samme som overensstemmelse med uafhængigt bedømte patientresultater, især når vejledningen og den evaluerede software har samme organisatoriske ophav.
Vejledninger om diagnostisk timing omhandler en anden nyttig fejlkilde. Vores Nipah diagnostisk testguide omhandler en specialiseret diagnostisk kontekst; den bør ikke bruges til at antyde, at rutinemæssig laboratoriefortolkning identificerer en bestemt virus. Hvis en køber medtager blot 1 patogenpåstand med store konsekvenser i den tilsigtede anvendelse, kræver den påstand sit eget relevante diagnostiske evidensgrundlag og passende grænser for eskalering.
Standarder for rapportering af studier understøtter vurdering snarere end certificering af ydeevne. STARD 2015 indeholder 30 rapporteringspunkter for diagnostiske nøjagtighedsstudier, mens TRIPOD+AI omhandler rapportering af prædiktionsmodeller; ingen af tjeklisterne giver softwaren et klinisk godkendelsesstempel. Referencerne nedenfor adskiller disse metodologiske kilder og KDIGO-retningslinjen fra 2024 fra de 2 DOI-poster til undervisningsformål, så læserne kan skelne mellem kliniske anbefalinger, rapporteringsvejledning og produktspecifik evidens.
Ofte stillede spørgsmål
Hvad er klinisk validering af AI-software til blodprøver?
Klinisk validering vurderer, om en bestemt version af AI-software til blodprøver giver tilstrækkeligt nøjagtige og sikre resultater for de tiltænkte patienter og beslutninger. Den bør som minimum adskille 3 opgaver: aflæsning af kilderapporten, fortolkning af den kliniske betydning og anbefaling af en handling. Dokumentationen bør beskrive referencestandarden, stikprøvestørrelsen på patientniveau, uafhængig afprøvning og håndtering af fejl. En teknisk korrekt forklaring beviser ikke i sig selv, at patientresultaterne forbedres.
Er 99% nøjagtighed nok til at stole på en AI-blodprøveanalysator?
En påstand om 99% nøjagtighed kan ikke fastslå sikkerheden uden nævneren, opgavedefinitionen og fejlens alvorlighed. I en hypotetisk gruppe, hvor kun 1% har en målsygdom, opnår software, der klassificerer alle som negative, en nøjagtighed på 99%, samtidig med at ingen af de berørte patienter identificeres. Købere bør anmode om sensitivitet, specificitet, fejl i rapporter på patientniveau og antallet af afviste input. Sjældne, men farlige anbefalinger må ikke forsvinde i et gennemsnit, der domineres af lette udsagn.
Hvad er forskellen mellem et syntetisk benchmark og klinisk validering?
En syntetisk benchmark evaluerer software på konstruerede tilfælde, mens klinisk validering kræver evidens, der er passende for den tilsigtede patientpopulation og den kliniske påstand. Selv 100.000 syntetiske tilfælde kan ikke fastslå forekomsten i den virkelige verden, den kliniske nytte eller ydeevnen ved alle problemer med manglende sygehistorik og prøvekvalitet. Syntetisk testning kan hjælpe med at identificere tekniske fejl og understøtte regressionstjek. Den bør supplere, ikke erstatte, repræsentativ ekstern og prospektiv evaluering.
Hvor meget uafhængig testning har AI i sundhedsvæsenet brug for?
AI i sundhedsvæsenet kræver uafhængig afprøvning, der står mål med konsekvenserne af et forkert output, ikke et universelt minimumsantal rapporter. Hvis man observerer 0 fejl i 100 uafhængige tilfælde, er den omtrentlige øvre grænse for fejlprocenten ifølge 3-reglen tæt på 3%. Købere bør anmode om beskyttede testdata, en fastfrosset modelversion og oplysninger om evaluatorernes relationer. Påstande om sjældne alvorlige fejl kræver som regel mere dokumentation, end et lille pilotprojekt om brugervenlighed eller gennemførlighed kan levere.
Betyder understøttelse af 100 sprog lige høj nøjagtighed på alle sprog?
Understøttelse af 100 sprog dokumenterer ikke lige stor klinisk nøjagtighed på tværs af disse sprog. Sprogspecifik evaluering bør teste inputudtræk, decimalformater, enheder, negation og betydningen af anbefalinger. For eksempel må glukose angivet som 5,6 mmol/L ikke fortolkes som 56 mmol/L. Købere bør anmode om sprogspecifikke nævnere og oplyse, hvilke sprog der ikke er blevet klinisk gennemgået.
Kan AI diagnosticere kronisk nyresygdom ud fra én lav eGFR-værdi?
Ét eGFR-resultat under 60 mL/min/1.73 m² fastslår ikke i sig selv kronisk nyresygdom. KDIGO-retningslinjen fra 2024 definerer kronisk nyresygdom ud fra nyreabnormiteter, der er til stede i mindst 3 måneder, med vurdering af kroniskhed og klinisk sammenhæng. Akutte ændringer, kropssammensætning og andre faktorer kan påvirke fortolkningen. AI-software bør forklare usikkerheden og understøtte klinikerens opfølgning frem for at betegne et enkelt lavt estimat som permanent sygdom.
Få dine blodprøveresultater forklaret
Upload din laboratorierapport, så forklarer Kantesti's AI hver biomarkør i et letforståeligt sprog på få sekunder. Bruges af mere end 2 millioner mennesker verden over.
Referencer
- Klein, T., Mitchell, S. og Weber, H. (2025). Guide til C3-, C4- og ANA-titer-blodprøver. Kantesti AI Medicinsk forskning. DOI
- Klein, T., Mitchell, S. og Weber, H. (2025). Blodprøve for Nipah-virus: Guide til tidlig påvisning og diagnosticering 2026. Kantesti AI Medicinsk forskning. DOI
- Bossuyt PM et al. (2015). STARD 2015: en opdateret liste over væsentlige punkter ved rapportering af diagnostiske nøjagtighedsstudier. BMJ. DOI PubMed
- Collins GS et al. (2024). TRIPOD+AI-erklæring: opdateret vejledning til rapportering af kliniske prædiktionsmodeller, der bruger regressions- eller maskinlæringsmetoder. BMJ. DOI
- Kidney Disease: Improving Global Outcomes (KDIGO) CKD-arbejdsgruppe (2024). KDIGO 2024 klinisk praksisretningslinje for evaluering og håndtering af kronisk nyresygdom. Kidney International. DOI
- 2 mio.+Analyserede test
- 127+lande
- 100+Sprog
Om det medicinske team


E-E-A-T Trust Signals
Erfaring
Lægefagligt ledet klinisk gennemgang af arbejdsgange til laboratorietolkning.
Ekspertise
Fokus på laboratoriemedicin på, hvordan biomarkører opfører sig i klinisk kontekst.
Autoritet
Medicinsk gennemgået af Dr. Thomas Klein med bidrag fra Dr. Sarah Mitchell og Prof. Dr. Hans Weber.
Troværdighed
Evidensbaseret fortolkning med klare opfølgningsspor for at reducere alarm.
Medicinsk ansvarsfraskrivelse
Denne artikel er kun til undervisningsformål og udgør ikke lægelig rådgivning. Rådfør dig altid med en kvalificeret sundhedsprofessionel for beslutninger om diagnose og behandling.
Publiceret · Opdateret · Kontakt redaktionen
Udgivet af Kantesti Ltd, registreret i England og Wales, virksomhedsnummer. 17090423, London, Storbritannien.
