
La validació clínica consisteix a comprovar si el programari produeix interpretacions prou precises i segures per als pacients als quals va destinat, i no simplement si genera informes convincents.

Conclusions principals
- Abast de la validació ha d’identificar els pacients als quals va destinada, les dades d’entrada del laboratori i les decisions clíniques; l’èxit en una tasca no pot establir la seguretat en tots els usos.
- Denominadors de precisió han de distingir els pacients, els informes, els biomarcadors i les afirmacions individuals; 10.000 afirmacions poden provenir de només 200 informes.
- Sensibilitat mesura els casos de referència positius detectats; un resultat hipotètic de 90/100 vol dir que no es van detectar 10 casos afectats.
- Valor predictiu depèn de la prevalença: amb una prevalença de l’1%, una sensibilitat del 90% i una especificitat de l’95%, el valor predictiu positiu és d’aproximadament el 15,4%.
- Proves independents exigeixen dades de prova protegides, una versió del programari congelada i la divulgació de qui va dissenyar, finançar i avaluar l’estudi.
- Evidència sobre subgrups ha d’incloure les mides de la mostra i la incertesa; observar 0 errors en 20 casos positius no demostra una sensibilitat perfecta.
- Velocitat operativa d’aproximadament 60 segons descriu la nostra funció d’interpretació, no una reducció demostrada dels errors diagnòstics o dels retards en el tractament.
- Els criteris d’adopció haurien d’incloure la seguretat a escala individual del pacient, el rendiment específic per idioma, els errors d’entrada i una resposta documentada als canvis de programari.
L’auge de la IA en el diagnòstic mèdic: què significa la validació
Validació de les anàlisis de sang amb IA requereix proves que una versió de programari especificada produeix interpretacions precises i segures per als pacients i les decisions als quals està destinada. Els compradors haurien d’examinar els denominadors a escala individual del pacient, les proves independents, els resultats per subgrups i la gestió dels errors, no només un percentatge d’exactitud destacat. Kantesti és un analitzador d’anàlisis de sang amb IA i els seus resultats haurien de complir els mateixos requisits probatoris.
El programari d’interpretació no mesura la mostra original. Un analitzador de laboratori genera valors com ara el sodi a 138 mmol/L; després, el programari d’interpretació llegeix aquests valors i n’explica la possible significació, cosa que crea una segona oportunitat d’error, fins i tot quan la mesura de laboratori és correcta. Per tant, els compradors necessiten proves independents sobre la precisió de l’extracció, la gestió dels intervals de referència i el raonament clínic.
La validesa clínica i la utilitat clínica responen a preguntes diferents. Una avaluació podria demostrar concordança en 500 informes sense demostrar que els pacients reben una atenció millor, eviten exploracions innecessàries o entenen millor la incertesa. La nostra guia per a l’explicació d’informes mèdics explica per què una redacció comprensible continua requerint una comprovació de les fonts i uns límits adequats d’escalada.
Les estadístiques d’adopció no poden substituir un estudi clínic. L’abast de la nostra plataforma, de 2M+ usuaris en 127+ països, segons les dades de la plataforma, descriu l’ús, no una cohort de validació representativa amb resultats confirmats. El historial de l’empresa ajuda a establir la rendició de comptes de l’organització; un dossier de proves independent ha d’identificar l’ús previst exacte, la població elegible i les conseqüències d’una interpretació errònia.
Afirmacions sobre la precisió: comptar per separat els pacients, els informes i les decisions
Una afirmació d’exactitud només es pot interpretar si se’n divulguen el numerador, el denominador i les regles de puntuació. Una xifra com ara 98.49% podria referir-se a camps extrets, enunciats acceptats o casos classificats: tasques molt diferents. Aquí, aquesta xifra és un exemple d’una afirmació destacada que requereix escrutini, no un resultat de rendiment clínic verificat independentment.
Els enunciats repetits no són pacients independents. En una avaluació hipotètica, 200 informes amb 50 enunciats puntuats cadascun generen 10.000 observacions a escala d’enunciat, però continuen sent només 200 informes. Una explicació correcta del sodi a 140 mmol/L no hauria de compensar una recomanació perillosa en un altre punt del mateix informe; exigiu tant una puntuació a escala d’enunciat com la proporció d’informes que contenen errors amb conseqüències clíniques.
Les dades d’entrada excloses poden inflar la fiabilitat aparent. Suposem que s’envien 1.000 informes, se’n rebutgen 100 i 882 dels 900 restants superen la rúbrica: l’exactitud entre els informes completats és 98%, mentre que els resultats acceptables obtinguts correctament entre els informes enviats són del 88.2%. Cap dels dos denominadors és deshonest per si mateix, però els compradors necessiten tots dos, a més dels motius del rebuig i de saber si els casos rebutjats inclouen desproporcionadament anomalies urgents.
La metodologia publicada hauria de definir què es considerava correcte abans de començar la puntuació. La declaració de notificació STARD 2015 demana que els estudis de precisió diagnòstica descriguin la selecció dels participants, l’estàndard de referència i el flux dels participants (Bossuyt et al., 2015). El nostre pàgina de metodologia de validació és un punt de partida per a preguntes sobre Kantesti; no s’ha de considerar una prova del rendiment independent a escala de pacient sense els materials de l’estudi subjacents.
La sensibilitat, l’especificitat i el valor predictiu responen preguntes diferents
La sensibilitat mesura la detecció entre els casos positius segons l’estàndard de referència; l’especificitat mesura els negatius correctes entre els casos negatius segons l’estàndard de referència. El valor predictiu positiu mesura amb quina freqüència un resultat positiu és correcte en l’entorn estudiat. Per a una eina hipotètica amb una sensibilitat de 90% i una especificitat de 95%, amb una prevalença d’1%, el valor predictiu positiu és aproximadament del 15.4%.
Una matriu de confusió fa visible aquest compromís. Entre 10.000 pacients hipotètics amb una prevalença d’1%, 100 tenen l’afecció objectiu: se’n detecten 90 i se’n passen per alt 10. Dels 9.900 que no la tenen, 495 obtenen resultats falsos positius; per tant, només 90 dels 585 resultats positius són correctes, tot i que la precisió global és del 94.95%.
Precisió no és un sinònim universal d’exactitud. En classificació, precisió sol voler dir valor predictiu positiu, mentre que una rúbrica de puntuació narrativa d’un proveïdor pot fer servir el terme d’una altra manera. El nostre debat sobre la confirmació d’anticossos amb resultats positius baixos il·lustra el principi clínic: la interpretació depèn de la probabilitat preprova i de la confirmació, no només de si un resultat inicial supera un llindar.
L’elecció del llindar modifica l’equilibri entre els casos no detectats i les alertes falses. Demaneu la matriu de confusió al llindar d’implementació proposat, no només una corba de rendiment que abasti molts llindars. En un estudi hipotètic d’alertes, abaixar un llindar de 0.7 a 0.4 podria millorar la sensibilitat alhora que duplicaria les alertes falses; els compradors han de decidir si aquest compromís s’ajusta a les conseqüències clíniques i a la capacitat de revisió.
Les proves independents necessiten un conjunt de dades protegit i un estàndard de referència fiable
Les proves independents avaluen un model congelat amb dades que no estaven disponibles durant el desenvolupament, amb les relacions dels avaluadors declarades i un estàndard de referència clínicament defensable. Les dades externes per si soles no garanteixen una avaluació independent. Un estudi que inclogui 3 hospitals pot tenir igualment etiquetes esbiaixades, canalitzacions de dades compartides o casos de prova que hagin influït en l’ajust del model.
La separació a escala de pacient evita una forma habitual de filtració de dades. Si l’informe de gener d’un pacient s’inclou a l’entrenament i el seu informe de febrer s’inclou a les proves, el model pot beneficiar-se de patrons recurrents o d’identificadors. Els compradors haurien de preguntar com s’han identificat els pacients duplicats, els ingressos repetits i els informes de 2 sistemes de laboratori connectats, i si el conjunt de proves final ha romàs intacte després de seleccionar el model i les instruccions.
L’estàndard de referència ha de correspondre a l’afirmació. L’acord entre experts sobre 300 interpretacions pot avaluar la qualitat dels informes, però no confirma automàticament la presència de la malaltia ni els resultats futurs. La distinció és ben coneguda en l’exactitud i el moment de l’assaig: la prova avaluada, el comparador i el moment de la confirmació poden modificar cadascun el rendiment aparent.
Els bancs de proves sintètics avaluen casos construïts, no la prevalença de les malalties ni la utilitat clínica en el món real. Ni tan sols 100,000 escenaris sintètics poden reproduir tots els antecedents que falten, els artefactes de les mostres o les presentacions inesperades. Per a les afirmacions que impliquen els límits de la interpretació de la troponina, un estudi necessita la informació clínica i el seguiment diagnòstic pertinents per a l’al·legació; una afirmació correcta sobre un llindar de laboratori no és un diagnòstic confirmat.
El rendiment en subgrups pot revelar riscos que queden ocults en la mitjana
Les proves de validació de subgrups avaluen si el rendiment varia entre grups de pacients i condicions d’entrada clínicament pertinents. Els compradors haurien de demanar els denominadors, la gravetat dels errors i els intervals de confiança per a infants, adults grans, embaràs, insuficiència renal i altres poblacions previstes. Observar 0 errors en 20 casos positius segons el valor de referència deixa una incertesa considerable sobre la taxa real d’errors.
Els intervals de referència específics per edat no són intercanviables. Una interpretació pediàtrica no pot heretar amb seguretat tots els llindars per a adults, encara que l’analit i la unitat siguin idèntics. La nostra guia sobre Interpretació de la IA per a nens explica el límit de seguretat; els compradors haurien de demanar el nombre real de casos per franja d’edat, en lloc d’acceptar una afirmació general que inclogui pacients d’1 a 18 anys.
El context biològic és més important que les simplificacions demogràfiques. Un recompte absolut de neutròfils d’1,2 × 10^9/L pot requerir un raonament diferent en una persona estable amb un recompte associat a Duffy-null que en algú amb una disminució recent durant el tractament. El/la explicació dels neutròfils amb fenotip Duffy-null permet plantejar un cas de prova específic; no s’ha d’utilitzar l’ascendència per si sola per pressuposar el genotip o la seguretat clínica.
Les mostres petites poden ocultar taxes de fallada clínicament rellevants. La regla aproximada de tres vol dir que 0 esdeveniments observats en 20 observacions independents corresponen a un límit superior aproximat del 15%, no de l’1%. Les comparacions entre subgrups també requereixen una anàlisi agrupada per pacient quan els informes es repeteixen; un estudi hauria d’indicar els grups no avaluats en lloc de considerar que una diferència no significativa demostra un rendiment equivalent.
El suport multilingüe necessita proves de seguretat específiques per a cada idioma
La validació multilingüe comprova si el significat clínic es manté en la traducció, el format numèric i l’explicació adreçada al pacient en cada idioma previst. Kantesti és una plataforma d’interpretació anàlisi de sang amb suport per a 100+ idiomes; aquesta capacitat no demostra per si mateixa un rendiment clínic equivalent en tots aquests idiomes. Cada idioma necessita una estratègia d’avaluació adequada i una cobertura comunicada.
Les convencions decimals poden canviar el valor interpretat. Un resultat de glucosa escrit com a 5,6 mmol/L en una configuració regional no s’ha de convertir en 56 mmol/L després de l’extracció, i una conversió d’unitats ha de preservar el significat clínic, no limitar-se a substituir la puntuació. Avalueu per separat les entrades en l’idioma original i les sortides traduïdes; provar només informes de laboratori en anglès traduïts a 10 idiomes no detecta els errors en les entrades.
La negació i el tipus de resultat mereixen casos de prova específics. Expressions com ara no detectat, per sota del límit de quantificació i no es pot excloure comuniquen graus de certesa diferents. El nostre guia qualitativa versus quantitativa explica la diferència; una rúbrica de revisió bilingüe hauria de comprovar aquests significats, inclosos els símbols d’inequació com ara inferior a 0,1, en lloc de premiar únicament una redacció fluida.
La llegibilitat no garanteix la comprensió. Una avaluació lingüística útil podria demanar als participants que identifiquin l’acció necessària i la incertesa després de llegir 3 informes breus, i registrar si la traducció modifica la urgència o els consells sobre la medicació. Es tracta de tasques d’avaluació proposades, no d’un llindar universal validat; els idiomes amb menys recursos poden requerir una revisió addicional perquè la terminologia clínica disponible i la cobertura de formació són diferents.
La integració amb API i els formats d’informe han de preservar el significat clínic
La validació de la integració comprova si la identitat del pacient, els valors, les unitats, les dates i les advertències es mantenen correctes entre els límits dels sistemes. Les sortides en HTML, JSON i PDF haurien de comunicar el mateix contingut clínic quan s’admetin aquests formats. El significat d’un resultat de sodi de 128 mmol/L no ha de canviar perquè una sortida ometi una advertència o una altra trunqui un camp.
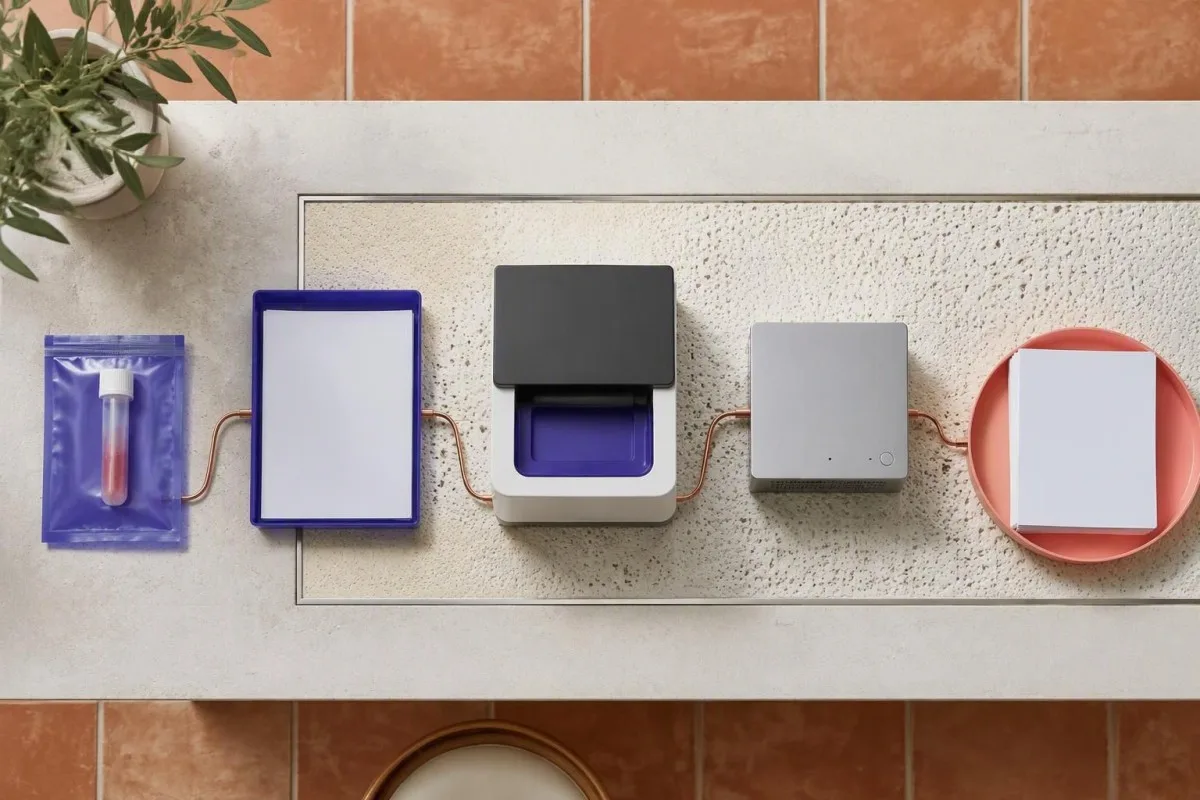
Una connexió API operativa no és una integració clínica validada. La nostra API B2B requereix comprovacions específiques del desplegament del mapatge, l'autenticació, la gestió de les respostes i el comportament de les versions; la compatibilitat amb l'EHR o el LIS s'hauria de demostrar per a la interfície concreta. Proveu almenys 3 classes d'errors —unitats absents, identificadors de pacient no coincidents i respostes duplicades amb retard— en lloc d'acceptar una única petició de demostració reeixida.
Els valors derivats requereixen entrades explícites i la traçabilitat de la fórmula. El sodi corregit, per exemple, depèn del sodi mesurat, la glucosa i el mètode de correcció; diferents coeficients publicats poden donar estimacions diferents. La nostra guia de correcció del sodi relacionada amb la glucosa proporciona un cas de prova clínic, però els compradors haurien de verificar que la glucosa en mg/dL no es tracti mai com si fos en mmol/L i que qualsevol càlcul indiqui les seves hipòtesis.
L'acord sobre el format hauria d'incloure el significat, no només la disposició. En una prova hipotètica d'exportació de 300 informes, el JSON pot conservar una alerta crítica mentre que una plantilla PDF l'amaga sota un salt de pàgina. Compareu les recomanacions clíniques, la incertesa, les unitats i les marques horàries en totes les sortides admeses; manteniu els valors originals traçables fins a la font i especifiqueu si un camp absent provoca un rebuig segur o una interpretació no admesa.
Els informes ràpids i una interfície intuïtiva també necessiten proves de factors humans
La velocitat i la usabilitat són avantatges operatius, no proves directes de precisió diagnòstica. La nostra funció d'interpretació sol generar una explicació en aproximadament 60 segons, però el desplegament clínic hauria de mesurar el retard d'extrem a extrem, les peticions fallides i la càrrega de revisió. Un temps de processament mitjà, per si sol, no pot demostrar si els resultats urgents arriben de manera segura a la persona adequada.
La latència s'hauria de presentar com una distribució. Demaneu la mediana, el percentil 95 i la taxa d'esgotament del temps d'espera en condicions realistes d'ús concurrent, inclosos els fitxers grans i les fotografies de mala qualitat. Una mediana hipotètica de 45 segons amb un percentil 95 de 240 segons descriu un servei molt diferent d'un que acaba sistemàticament en prop de 60 segons; cap de les dues xifres demostra que el tractament s'iniciï abans.
Els patrons de laboratori urgents requereixen una presentació i una escalada provades. Un resultat de potassi de 6.5 mmol/L pot indicar una emergència mèdica, tot i que la qualitat de la mostra i el context clínic afecten la interpretació. La nostra guia sobre la urgència dels electròlits serveix de base per dissenyar escenaris; els pacients que rebin una alerta de laboratori urgent haurien de contactar de seguida amb el servei tractant en lloc d'esperar una explicació de l'aplicació, especialment si presenten símptomes.
Les proves de factors humans mesuren què fan els usuaris amb l'informe. En l'accés web, iOS, Android i mitjançant extensions, els compradors haurien d'examinar almenys 3 tasques: trobar el valor original, reconèixer la incertesa i identificar la següent acció adequada. Registreu les accions incorrectes, a més del temps de compleció, perquè una interfície elegant pot augmentar la confiança en una recomanació no avalada i fer que el biaix d'automatització sigui més difícil de detectar.
Les proves de seguretat i privacitat han d’acompanyar la validació clínica
L'avaluació de la privadesa verifica com es recull, es tracta, es conserva, es comparteix i s'elimina la informació sensible de laboratori. El tractament alineat amb el GDPR és un enfocament declarat, no un substitut de les proves contractuals i tècniques. En el cas de Kantesti Ltd, societat registrada al Regne Unit amb el número 17090423, els compradors haurien d'establir la relació aplicable entre responsable i encarregat del tractament, així com les responsabilitats corresponents, abans d'enviar tan sols 1 informe identificable.
La informació sanitària necessita més que eliminar un nom. Un informe pot contenir un codi de barres, una data de naixement exacta, un número d'accés o un detall narratiu que permeti identificar algú en combinar-lo amb altra informació. La nostra precaucions de privadesa en pujar fitxers explicar la minimització pràctica; un comprador hauria d’avaluar per separat almenys 3 capes: el contingut dels fitxers, les metadades dels comptes i els registres operatius.
Les afirmacions de seguretat necessiten un abast definit i una data de les proves. Reviseu els acords de xifratge, els controls d’accés, les llistes de subprocessadors, les condicions de notificació d’incidents i els paràmetres de conservació a la documentació de privacitat de dades. Si un proveïdor esmenta una auditoria, pregunteu quins serveis i quin període de control cobreix; un informe que cobreixi 1 component d’infraestructura no avalua automàticament l’accés a les aplicacions clíniques ni el tractament de les dades dels models.
El desplegament internacional comporta obligacions addicionals. L’ús en països 127+ no vol dir que un sol contracte o fonament jurídic cobreixi totes les jurisdiccions, i l’alineació amb el GDPR no implica l’aplicabilitat de la HIPAA ni el compliment dels seus requisits. Per a les funcions familiars, proveu els límits dels permisos amb 2 comptes separats, incloent-hi la revocació de l’accés i la recuperació del compte; cal una resposta explícita sobre si l’eliminació d’un informe també suprimeix les còpies de seguretat i els registres.
El motor d’IA: validar per separat les prediccions i les recomanacions
Un motor d’IA necessita una validació específica per a cada afirmació relativa a la interpretació de patrons, la predicció de riscos futurs i les recomanacions personalitzades. Són tasques diferents, encara que es generin en 1 informe. L’arquitectura d’aprenentatge profund i l’anàlisi multiparamètrica descriuen el funcionament d’un sistema; no demostren que les seves estimacions de probabilitat, suggeriments diagnòstics o consells dietètics siguin clínicament fiables.
La interpretació multiparamètrica hauria de preservar les explicacions alternatives. En un informe hipotètic amb una ferritina de 40 ng/mL i una CRP de 20 mg/L, la ferritina sola no permet determinar la disponibilitat de ferro, perquè els nivells de ferritina poden augmentar amb una resposta de fase aguda. Els compradors que avaluïn la xarxa neuronal de Kantesti haurien d’utilitzar casos sensibles a aquest context, mentre que la explicació tecnològica continua sent diferent de les proves que confirmen que una conclusió clínica específica és correcta.
La predicció de riscos requereix un resultat i un horitzó temporal definits. Una probabilitat de 20% no és interpretable sense indicar què pot passar, a qui i durant quin període —per exemple, una hospitalització en un termini de 30 dies en lloc de l’aparició d’una malaltia en un termini de 5 anys. TRIPOD+AI recomana una presentació transparent dels estudis de models predictius (Collins et al., 2024); la calibració i la validació externa són importants, també per a l’anàlisi de tendències relacionades amb la medicació.
Els consells personalitzats comporten una obligació de seguretat independent. Una recomanació nutricional pot ser inadequada si no es coneixen la funció renal, la medicació o les circumstàncies de l’embaràs; el risc per a la salut familiar també requereix instruccions clares sobre com tractar els antecedents incerts o autodeclarats. La nostra guia de seguretat nutricional renal ofereix escenaris de prova pertinents, però acceptar un pla d’àpats de 3 elements no demostra que millori els resultats ni que substitueixi de manera segura una avaluació dietètica individualitzada.
Com funciona la interpretació anàlisi de sang amb IA: llista de verificació de validació per a compradors
Un comprador hauria de provar tota la seqüència: captura de la font, normalització, interpretació contextual, generació de l’informe i revisió clínica. Avalueu cada pas per separat abans de provar el sistema complet. Un pla d’acceptació en 5 etapes facilita identificar si un resultat insegur s’ha originat en una lectura errònia d’un valor, una suposició equivocada o una recomanació inadequada.
Comenceu definint l’ús previst i fixant la versió avaluada. El pas 1 consisteix en un inventari per escrit de les afirmacions i els riscos; el pas 2, en un conjunt de dades representatiu i bloquejat, amb criteris d’elegibilitat i etiquetes de referència predefinits. A continuació, cal provar la captura de PDF o de fotografies amb formats modificats, convencions decimals i camps il·legibles; documenteu els casos rebutjats en lloc d’excloure’ls discretament del denominador final.
A continuació, proveu les suposicions contextuals i longitudinals. El pas 3 comprova les unitats, els intervals de referència i les metadades; el pas 4 puntua les interpretacions i les recomanacions amb categories de gravetat clínicament significatives. La nostra guia de canvis entre visites al laboratori permet plantejar una qüestió útil: un canvi de creatinina de 80 a 100 µmol/L requereix tenir en compte el moment de la mesura, la variació de l’assaig i el pacient, no declarar automàticament un empitjorament.
Acabeu amb una decisió sobre el desplegament, no amb un eslògan sobre la precisió. El pas 5 avalua l’ús local prospectiu i la gestió de les fallades segons criteris acordats abans d’examinar els resultats, inclosos els marges d’incertesa i els procediments d’escalada. Demaneu un dossier que contingui el flux de participants de la cohort, la versió del model, la rúbrica completa de puntuació, les taules de subgrups, exemples de resultats adversos i les normes de control de canvis; cap percentatge universal no pot substituir uns llindars d’acceptació adequats a les conseqüències dels errors.
Informes de mostra i testimonis: distingir les il·lustracions de les proves
Un informe de mostra il·lustra la presentació i el raonament, mentre que un testimoni descriu una impressió individual. Cap dels dos estableix la precisió a escala de pacient ni el benefici clínic. Considereu un adult de 52 anys, clarament hipotètic, amb una creatinina de 118 µmol/L, un eGFR notificat de 58 mL/min/1,73 m² i sense resultats anteriors disponibles: l’explicació segura ha de mantenir la incertesa.
Un únic eGFR reduït no permet establir un diagnòstic de malaltia renal crònica. KDIGO defineix la malaltia renal crònica per anomalies de l’estructura o la funció renals presents durant almenys 3 mesos; un eGFR inferior a 60 mL/min/1,73 m² requereix avaluar-ne la cronicitat i el context (KDIGO CKD Work Group, 2024). En aquest exemple hipotètic, l’informe hauria de suggerir una valoració clínica i un seguiment adequat, no diagnosticar un dany renal permanent a partir d’un únic resultat.
Les estimacions basades en la creatinina poden ser menys informatives en casos de composició corporal atípica. Si la persona hipotètica té molta massa muscular o ha canviat recentment els suplements, la interpretació hauria de tenir en compte aquests factors en lloc de desestimar el resultat. La nostra explicació de creatinina en adults musculars aporta context; KDIGO recomana, quan està disponible, l’estimació basada en creatinina i cistatina C per avaluar adequadament la malaltia renal crònica en adults, en lloc de donar per fet que l’estimació inicial és definitiva.
Les demostracions haurien d’incloure dades d’entrada difícils i resultats desfavorables. Afegiu un resultat hipotètic separat de potassi de 6.0 mmol/L amb una incidència assenyalada a la mostra, fent servir les nostres limitacions dels resultats relacionades amb l’hemòlisi per explicar per què cal tenir en compte tant la confirmació com la urgència. Per a Kantesti, una avaluació útil consisteix a comparar a cegues informes complets; si es presenten amb consentiment, els testimonis de professionals continuen sent comentaris basats en l’experiència, no pas substituts d’aquestes proves.
Abraçar el futur del diagnòstic: adopció basada en l’evidència
Adopteu la interpretació amb IA només per als usos avalats per l’evidència, amb supervisió local i una resposta als errors documentada. Kantesti és una eina d’anàlisi d’analítiques de sang amb IA; el nostre conjunt de funcions s’hauria d’avaluar segons els mateixos estàndards d’adquisició descrits aquí. Començar amb 1 cas d’ús limitat és més segur que donar per fet que l’evidència és aplicable a tots els pacients i totes les recomanacions.
Una introducció esglaonada hauria de distingir la viabilitat de l’eficàcia. Una avaluació hipotètica en mode ombra de 100 informes pot revelar problemes d’integració i problemes freqüents de redacció sense exposar els pacients a recomanacions no revisades, però és poc probable que permeti establir una taxa baixa d’errors greus infreqüents. Una avaluació prospectiva més àmplia necessita una justificació de la mida de la mostra i resultats adequats a l’afirmació concreta, inclosos els seguiments innecessaris i les preocupacions no detectades.
Els canvis del programari poden modificar el rendiment mesurat anteriorment. Un model nou, una instrucció, una base de dades d’intervals de referència o una plantilla d’informe poden canviar els resultats encara que el nom del producte es mantingui igual; registreu les 4 categories a l’historial del desplegament. Superviseu la gravetat dels errors, les abstencions, les desviacions en els subgrups i les anul·lacions dels usuaris, i definiu en quins casos un canvi requereix proves de regressió específiques, una nova avaluació local o la suspensió d’una funció concreta.
La decisió d’adopció hauria de basar-se en una anàlisi escrita de les llacunes en l’evidència. Identifiqueu què s’ha establert de manera independent, què només està avalat per proves tècniques i què encara no s’ha avaluat; després, assigneu un responsable a cada risc no resolt. La nostra canal de contacte amb el comprador d'assistència sanitària és el lloc adequat per sol·licitar documentació específica sobre l'abast: és preferible una afirmació més acotada i fonamentada a un titular 99% amb un denominador poc clar.
Publicacions de recerca: distingir les guies educatives dels estudis de validació
Les 2 referències DOI de repositoris que figuren a continuació identifiquen guies educatives, no estudis de validació clínica de programari d'interpretació amb IA. Un DOI proporciona un identificador persistent; no acredita revisió per experts, reclutament de pacients, avaluació independent ni eficàcia clínica. Els compradors haurien de classificar cada publicació citada segons la pregunta que realment pot respondre.
Les guies educatives poden ajudar a elaborar una rúbrica de validació sense validar elles mateixes el producte. El nostre guia de complement i ANA pot aportar informació sobre casos en què cal explicar amb cura 2 mesures del complement i el context dels anticossos. La concordança amb una guia no equival a la concordança amb resultats de pacients avaluats de manera independent, especialment quan la guia i el programari avaluat comparteixen una mateixa font organitzativa.
Les guies sobre el moment del diagnòstic tracten un altre mode de fallada útil. El nostre guia de proves diagnòstiques de Nipah tracta un context diagnòstic especialitzat; no s'hauria d'utilitzar per donar a entendre que la interpretació rutinària de laboratori identifica un virus concret. Si un comprador inclou en l'ús previst encara que sigui 1 afirmació sobre un patogen d'alt impacte, aquesta afirmació necessita evidència diagnòstica pròpia i pertinent, així com límits d'escalada adequats.
Les normes de notificació d'estudis permeten valorar-los, però no certifiquen el rendiment. STARD 2015 conté 30 ítems de notificació per a estudis de precisió diagnòstica, mentre que TRIPOD+AI tracta la notificació de models predictius; cap de les dues llistes de verificació no atorga al programari un segell d'aprovació clínica. Les referències següents separen aquestes fonts metodològiques i la guia KDIGO de 2024 de les 2 entrades DOI educatives, perquè els lectors puguin distingir entre recomanacions clíniques, directrius de notificació i evidència específica del producte.
Preguntes freqüents
Què és la validació clínica del programari d’IA per a anàlisis de sang?
La validació clínica avalua si una versió especificada del programari d’anàlisi de sang amb IA produeix resultats prou precisos i segurs per als pacients i les decisions a què està destinada. Hauria de separar almenys 3 tasques: llegir l’informe d’origen, interpretar-ne el significat clínic i recomanar una acció. Les proves haurien de descriure l’estàndard de referència, la mida de la mostra a escala de pacient, les proves independents i la gestió de les fallades. Una explicació tècnicament correcta no demostra per si sola una millora dels resultats dels pacients.
És prou precisa l’accuracy de 99% per confiar en un analitzador d’anàlisis de sang amb IA?
Una afirmació d’exactitud del 99% no pot establir la seguretat sense el seu denominador, la definició de la tasca i la gravetat dels errors. En un grup hipotètic en què només l’1% presenta una afecció objectiu, un programari que classifica tothom com a negatiu assoleix una exactitud del 99% sense detectar cap dels pacients afectats. Els compradors haurien de demanar sensibilitat, especificitat, errors dels informes a escala de pacient i el nombre d’entrades rebutjades. Les recomanacions rares però perilloses no han de quedar ocultes dins d’una mitjana dominada per afirmacions fàcils.
Quina diferència hi ha entre un banc de proves sintètic i la validació clínica?
0 Una prova de referència sintètica avalua el programari en casos construïts, mentre que la validació clínica requereix proves adequades per a la població de pacients i l'afirmació clínica previstes. Ni tan sols 100.000 casos sintètics poden establir la prevalença en el món real, el benefici clínic o el rendiment davant de tots els problemes de manca d'historial i de qualitat de les mostres. Les proves sintètiques poden ajudar a identificar fallades tècniques i a donar suport a les comprovacions de regressió. Han de complementar, no substituir, l'avaluació externa i prospectiva representativa.
Quantes proves independents necessita la IA sanitària?
0 Healthcare AI necessita proves independents proporcionades a les conseqüències d’un resultat incorrecte, no d’un nombre mínim universal d’informes. Observar 0 errors en 100 casos independents deixa un límit superior aproximat de la taxa d’errors d’95%, proper al 3%, segons la regla de tres. Els compradors haurien de sol·licitar dades de prova protegides, una versió congelada del model i la divulgació de les relacions dels avaluadors. Les afirmacions sobre errors greus poc freqüents solen necessitar més proves de les que pot aportar un petit pilot d’usabilitat o viabilitat.
El fet que admeti 100 llengües vol dir que té la mateixa precisió en totes les llengües?
0 Suportar 100 llengües no demostra una precisió clínica equivalent en totes elles. L’avaluació específica per llengua hauria de provar l’extracció de dades d’entrada, les convencions decimals, les unitats, la negació i el significat de les recomanacions. Per exemple, una glucosa escrita com a 5,6 mmol/L no s’ha d’interpretar com a 56 mmol/L. Els compradors haurien de demanar denominadors específics per llengua i indicar quines llengües no han rebut una revisió clínica.
Pot la IA diagnosticar una malaltia renal crònica a partir d’un únic resultat baix de l’eGFR?
Un únic resultat d’eGFR inferior a 60 mL/min/1,73 m² no permet, per si sol, establir un diagnòstic de malaltia renal crònica. La guia KDIGO de 2024 defineix la malaltia renal crònica a partir d’anomalies renals presents durant almenys 3 mesos, tenint en compte la cronicitat i el context clínic. Els canvis aguts, la composició corporal i altres factors poden afectar-ne la interpretació. El programari d’IA hauria d’explicar la incertesa i facilitar el seguiment clínic, en lloc de classificar una única estimació reduïda com a malaltia permanent.
Fes que t’expliquin els resultats anàlisi de sang
Puja l’informe del laboratori i la IA de Kantesti t’explicarà cada biomarcador en llenguatge planer en qüestió de segons. Més de 2 milions de persones d’arreu del món ja l’han utilitzat.
Referències
- Klein, T., Mitchell, S. i Weber, H. (2025). Guia de les proves de sang C3 C4 del complement i del títol d'ANA. Recerca mèdica amb IA de Kantesti. DOI
- Klein, T., Mitchell, S. i Weber, H. (2025). Prova de sang per al virus Nipah: guia de detecció precoç i diagnòstic 2026. Recerca mèdica amb IA de Kantesti. DOI
- Bossuyt PM et al. (2015). STARD 2015: llista actualitzada dels ítems essencials per notificar estudis de precisió diagnòstica. BMJ. DOI PubMed
- Collins GS et al. (2024). Declaració TRIPOD+AI: directrius actualitzades per notificar models de predicció clínica que utilitzen mètodes de regressió o d'aprenentatge automàtic. BMJ. DOI
- Grup de treball sobre la malaltia renal crònica (MRC) de Kidney Disease: Improving Global Outcomes (KDIGO) (2024). Guia de pràctica clínica KDIGO 2024 per a l'avaluació i el tractament de la malaltia renal crònica. International Journal of Kidney Diseases. DOI
- Més de 2 milionsProves analitzades
- 127+Països
- 100+Idiomes
Sobre l’equip mèdic


Senyals de confiança E-E-A-T
Experiència
Revisió clínica liderada per metges dels fluxos de treball d’interpretació de laboratori.
Experiència
Enfocament en medicina de laboratori sobre com es comporten els biomarcadors en context clínic.
Autoritat
Revisat mèdicament pel Dr. Thomas Klein, amb aportacions de la Dra. Sarah Mitchell i el Prof. Dr. Hans Weber.
Fiabilitat
Interpretació basada en l’evidència amb vies de seguiment clares per reduir l’alarma.
Exempció de responsabilitat mèdica
Aquest article és només per a finalitats educatives i no constitueix assessorament mèdic. Consulteu sempre un professional sanitari qualificat per a decisions de diagnòstic i tractament.
Publicat · Actualitzat · Contacteu amb l’equip editorial
Publicat per Kantesti Ltd, registrat a Anglaterra i Gal·les, número de societat. 17090423, Londres, Regne Unit.
