
Клиничното валидиране означава да се провери дали софтуерът предоставя достатъчно точни и безопасни тълкувания за предвидените пациенти, а не просто дали генерира убедителни доклади.

Основни изводи
- Обхват на валидирането трябва да определя целевите пациенти, лабораторните данни и клиничните решения; успехът при 1 задача не може да докаже безопасност при всички употреби.
- Знаменатели за точността трябва да разграничават пациентите, докладите, биомаркерите и отделните твърдения; 10 000 твърдения може да произхождат само от 200 доклада.
- Чувствителност измерва откритите референтно положителни случаи; хипотетичен резултат 90/100 означава, че са пропуснати 10 засегнати случая.
- Предсказващата стойност зависи от разпространението: при разпространение 1%, чувствителност 90% и специфичност 95% положителната прогностична стойност е около 15.4%.
- Независимото тестване изисква защитени тестови данни, замразена версия на софтуера и разкриване на това кой е проектирал, финансирал и оценявал резултатите от проверката.
- Доказателства за подгрупите трябва да включва размера на извадката и несигурността; наблюдението на 0 пропуска сред 20 положителни случая не доказва перфектна чувствителност.
- Оперативна скорост от приблизително 60 секунди описва функцията ни за интерпретация, а не доказано намаление на диагностичните грешки или забавянията в лечението.
- Критерии за внедряване трябва да обхващат безопасността на ниво пациент, ефективността за конкретния език, грешките при въвеждане на данни и документираните действия при промени в софтуера.
Възходът на ИИ в медицинската диагностика: какво означава валидирането
Валидиране на AI кръвен тест изисква доказателства, че определена версия на софтуера предоставя точни и безопасни интерпретации за предвидените пациенти и решения. Купувачите трябва да разгледат знаменателите на ниво пациент, независимото тестване, резултатите за подгрупите и обработката на грешки — а не само водещ процент за точност. Kantesti е анализатор на кръвни тестове с AI, чиито резултати трябва да отговарят на същите изисквания за доказателства.
Софтуерът за интерпретация не измерва първоначалната проба. Лабораторният анализатор генерира стойности като натрий 138 mmol/L; след това софтуерът за интерпретация прочита тези стойности и обяснява възможното им значение, създавайки втора възможност за грешка дори когато лабораторното измерване е правилно. Затова купувачите се нуждаят от отделни доказателства за точността на извличане на данни, работата с референтните граници и клиничното разсъждение.
Клиничната валидност и клиничната полезност отговарят на различни въпроси. Една оценка може да покаже съответствие при 500 резултата, без да покаже, че пациентите получават по-добри грижи, избягват ненужни изследвания или разбират несигурността по-точно. Нашето ръководство за обяснение на медицински резултати обяснява защо разбираемият текст все пак изисква проверка спрямо източника и подходящи граници за ескалация.
Статистиката за внедряването не може да замести клинично проучване. Обхватът на платформата ни, според отчетените данни, от 2M+ потребители в 127+ държави описва употребата, а не представителна кохорта за валидиране с потвърдени резултати. Документът фирмен профил помага за установяване на организационната отчетност; в отделно досие с доказателства трябва да се посочат точното предназначение, допустимата популация и последиците от погрешна интерпретация.
Твърдения за точност: пациентите, докладите и решенията се броят поотделно
Твърдението за точност може да се тълкува само ако са обявени числителят, знаменателят и правилата за оценяване. Стойност като 98.49% може да се отнася за извлечени полета, приети твърдения или класифицирани случаи — съвсем различни задачи. Тук това число е пример за водещ показател, който трябва да се провери, а не независимо потвърден резултат за клинична ефективност.
Повтарящите се твърдения не са независими пациенти. При хипотетична оценка 200 резултата, съдържащи по 50 оценявани твърдения, дават 10 000 наблюдения на ниво твърдение, но все пак само 200 резултата. Правилното обяснение на натрий от 140 mmol/L не бива да компенсира опасна препоръка на друго място в същия резултат; изисквайте както оценяване на ниво твърдение, така и дела на резултатите с клинично значими грешки.
Изключените входни данни могат да завишат привидната надеждност. Да предположим, че са подадени 1 000 резултата, 100 са отхвърлени, а 882 от останалите 900 покриват критериите: точността сред обработените резултати е 98%, докато делът на успешно генерираните приемливи резултати сред всички подадени е 88.2%. Нито един от двата знаменателя не е поначало подвеждащ, но купувачите се нуждаят и от двата, както и от причините за отхвърляне и информация дали отхвърлените случаи включват непропорционално често спешни отклонения.
Публикуваната методология трябва да определя какво се е считало за правилно, преди да започне оценяването. Декларацията за докладване STARD 2015 изисква проучванията на диагностичната точност да описват подбора на участниците, референтния стандарт и потока на участниците (Bossuyt et al., 2015). Нашата страница с методология за валидиране е отправна точка за въпроси относно Kantesti; не бива да се приема като доказателство за независима ефективност на ниво пациент без материалите от основното проучване.
Чувствителността, специфичността и прогностичната стойност отговарят на различни въпроси
Чувствителността измерва откриването сред случаите с положителен референтен резултат; специфичността измерва правилното определяне на отрицателните резултати сред случаите с отрицателен референтен резултат. Положителната предсказваща стойност измерва колко често положителният резултат е правилен в изследваната среда. За хипотетичен инструмент с чувствителност 90% и специфичност 95% при разпространение 1% положителната предсказваща стойност е приблизително 15.4%.
Матрицата на объркванията прави компромиса видим. Сред 10 000 хипотетични пациенти при разпространение 1%, 100 имат целевото състояние: 90 са открити, а 10 са пропуснати. От 9 900 души без него 495 получават фалшиво положителни резултати; следователно само 90 от 585 положителни резултата са правилни, въпреки че общата точност е 94.95%.
Прецизността не е универсален синоним на точност. В класификацията прецизност обикновено означава положителна предсказваща стойност, докато в рубрика за оценяване на текст от доставчик думата може да се използва по друг начин. Нашето обсъждане на потвърждаването на нискоположителен резултат за антитела илюстрира клиничния принцип: интерпретацията зависи от предварителната вероятност и потвърждаването, а не само от това дали първоначалният резултат надвишава праг.
Изборът на праг променя баланса между пропуснатите случаи и фалшивите тревоги. Поискайте матрицата на объркванията при предложения праг за внедряване, а не само крива на ефективността, обхващаща множество прагове. В хипотетично проучване на система за предупреждения понижаването на прага от 0.7 на 0.4 може да подобри чувствителността, като същевременно удвои фалшивите предупреждения; купувачите трябва да преценят дали този компромис съответства на клиничните последствия и капацитета за преглед.
Независимото тестване изисква защитен набор от данни и достоверен референтен стандарт
Независимото тестване оценява замразен модел върху данни, които не са били достъпни по време на разработването, като отношенията на оценителя са разкрити и е използван клинично обоснован референтен стандарт. Само външните данни не гарантират независима оценка. Проучване с участието на 3 болници все така може да има предубедени етикети, споделени конвейери за данни или тестови случаи, повлияли върху настройването на модела.
Разделянето на ниво пациент предотвратява често срещана форма на изтичане на данни. Ако януарският доклад на пациент попадне в обучаващата извадка, а февруарският му доклад — в тестовата, моделът може да се възползва от повтарящи се модели или идентификатори. Купувачите трябва да попитат как са идентифицирани дублираните пациенти, повторните хоспитализации и докладите от 2 свързани лабораторни системи, както и дали окончателната тестова извадка е останала недокосната след избора на модела и подканите.
Референтният стандарт трябва да съответства на твърдението. Съгласието на експертите по 300 интерпретации може да оцени качеството на докладите, но автоматично не потвърждава наличието на заболяване или бъдещите резултати. Разграничението е познато от точността на анализа и времето: самият тест, който се оценява, сравнителният метод и моментът на потвърждаване могат поотделно да променят привидната ефективност.
Синтетичните бенчмаркове тестват конструирани случаи, а не разпространението на заболявания или клиничната полезност в реални условия. Дори 100,000 синтетични сценария не могат да възпроизведат всяка липсваща анамнеза, артефакт на пробата или неочаквана клинична картина. При твърдения, включващи ограниченията при интерпретацията на тропонин, едно проучване се нуждае от клиничната информация и диагностичното проследяване, свързани с твърдението; правилното изречение за лабораторен праг не е потвърдена диагноза.
Ефективността при отделните подгрупи може да разкрие рискове, скрити от средните стойности
Тестовете за валидиране на подгрупи проверяват дали ефективността се променя при клинично значими групи пациенти и условия на въвеждане на данните. Купувачите трябва да изискват знаменатели, тежест на грешките и доверителни интервали за деца, възрастни хора, бременност, бъбречно увреждане и други целеви популации. Наблюдението на 0 пропуска сред 20 референтно положителни случая оставя значителна несигурност относно истинската честота на пропуските.
Референтните интервали, специфични за възрастта, не са взаимозаменяеми. Педиатричното тълкуване не може безопасно да наследи всеки праг за възрастни, дори когато основният аналит и мерната единица са идентични. Нашето ръководство за AI интерпретация за деца обяснява границата на безопасност; купувачите трябва да изискват действителния брой пациенти във всяка възрастова група, вместо да приемат широко твърдение, обхващащо пациенти на възраст от 1 до 18 години.
Биологичният контекст има по-голямо значение от демографските опростявания. Абсолютният брой неутрофили от 1.2 × 10^9/L може да изисква различен подход при стабилен човек с брой, свързан с Duffy-null, отколкото при човек с нов спад по време на лечение. The обяснение за неутрофилите при Duffy-null подкрепя целеви тестов случай; произходът сам по себе си не бива да се използва за допускания относно генотипа или клиничната безопасност.
Малките извадки могат да прикрият клинично значими нива на неуспех. Приблизителното правило на трите означава, че 0 наблюдавани събития в 20 независими наблюдения съответстват на горна граница 95% близо до 15%, а не до 0%. Сравненията между подгрупи също изискват анализ с групиране по пациент, когато има повтарящи се отчети; едно проучване трябва да посочва неизследваните групи, вместо да третира статистически незначима разлика като доказателство за еквивалентна ефективност.
Поддръжката на множество езици изисква тестване на безопасността за всеки език
Многоезиковото валидиране проверява дали клиничният смисъл се запазва при превод, числово форматиране и обяснение за пациента на всеки целеви език. Kantesti е платформа с изкуствен интелект за тълкуване на кръвни изследвания с поддръжка на 100+ езика; тази възможност сама по себе си не доказва еквивалентна клинична ефективност на тези езици. Всеки език изисква подходяща стратегия за оценяване и ясно посочен обхват.
Десетичните разделители могат да променят тълкуваната стойност. Резултат за глюкоза, изписан като 5,6 mmol/L в една локализация, не бива да се превръща в 56 mmol/L при извличане, а преобразуването на мерна единица трябва да запазва клиничния смисъл, а не просто да заменя пунктуацията. Оценявайте отделно входните данни на оригиналния език и преведените резултати; тестването само на лабораторни отчети на английски, преведени на 10 езика, пропуска грешките при въвеждането.
Отрицанието и видът на резултата заслужават специални тестови случаи. Изрази като „не е открито“, „под границата на количествено определяне“ и „не може да се изключи“ изразяват различна степен на сигурност. Нашето качествен спрямо количествен наръчник обяснява разликата; двуезичната рубрика за оценяване трябва да проверява тези значения, включително символи за неравенство като „по-малко от 0.1“, вместо да оценява само гладкото звучене на текста.
Четимостта не гарантира разбиране. Полезна оценка на езиковите възможности може да помоли участниците да посочат необходимото действие и несигурността, след като прочетат 3 кратки отчета, като същевременно отчита дали преводът променя спешността или съветите за лекарства. Това са предложени задачи за оценяване, а не универсален валидиран праг; езиците с по-малко ресурси може да изискват допълнителен преглед, тъй като наличната клинична терминология и обхватът на обучението се различават.
Интеграцията с API и форматите на отчетите трябва да запазват клиничния смисъл
Валидирането на интеграцията проверява дали самоличността на пациента, стойностите, мерните единици, датите и предупрежденията остават коректни при преминаване между системите. Изходните данни в HTML, JSON и PDF трябва да предават едно и също клинично съдържание, когато тези формати се поддържат. Резултат за натрий от 128 mmol/L не бива да променя значението си, защото в един изход липсва предупреждение или друг съкращава поле.
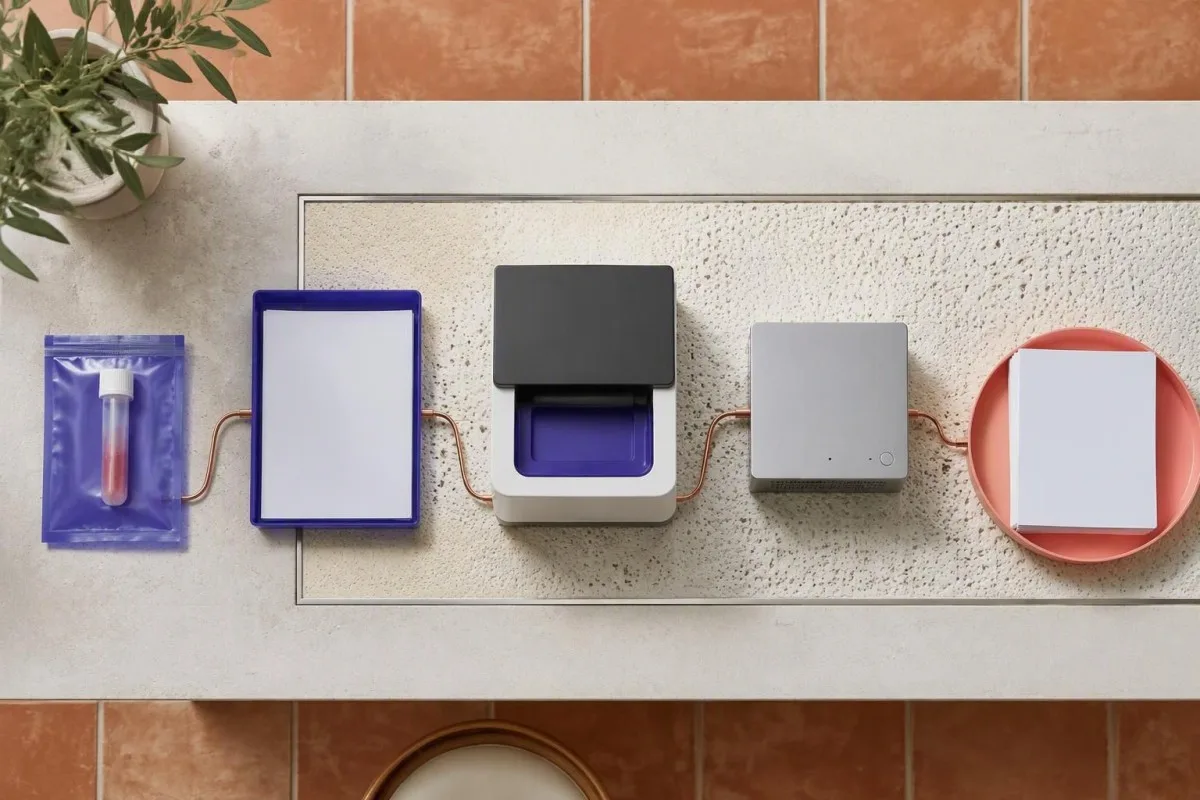
Работеща API връзка не е валидирана клинична интеграция. Нашият B2B API изисква проверки, специфични за внедряването, на съпоставянето, удостоверяването, обработката на отговорите и поведението при различни версии; съвместимостта с EHR или LIS трябва да бъде доказана за реалния интерфейс. Тествайте поне 3 класа откази — липсващи мерни единици, несъответстващи идентификатори на пациенти и забавени дублирани отговори — вместо да приемате една успешна демонстрационна заявка.
Производните стойности изискват изрично посочени входни данни и произход на формулата. Например коригираният натрий зависи от измерения натрий, глюкозата и използвания подход за корекция; различните публикувани коефициенти могат да дадат различни оценки. Нашето ръководство за корекция на натрия спрямо глюкозата предоставя клиничен тестов пример, но купувачите трябва да проверят дали глюкозата в mg/dL никога не се третира като mmol/L и дали при всяко изчисление се посочват допусканията.
Съгласуването на формата трябва да обхваща и значението, а не само оформлението. При хипотетичен тест за експортиране на 300 отчета JSON може да запази критичен флаг, докато PDF шаблонът го скрива под разделител на страница. Сравнете клиничните препоръки, несигурността, мерните единици и времевите отметки във всички поддържани изходни формати; запазете проследимостта на първичните стойности до източника и уточнете дали липсващо поле води до безопасно отхвърляне или до неподкрепено тълкуване.
Бързите отчети и удобният интерфейс все пак изискват доказателства от изследвания на човешките фактори
Скоростта и удобството за използване са оперативни предимства, а не пряко доказателство за диагностична точност. Нашата функция за интерпретация обикновено генерира обяснение за приблизително 60 секунди, но при клинично внедряване трябва да се измерват забавянето от край до край, неуспешните заявки и натоварването при прегледа. Само медианното време за обработка не показва дали спешните резултати достигат безопасно до правилния човек.
Закъснението трябва да се отчита като разпределение. Поискайте медианата, 95-ия персентил и процента на изтеклите заявки при реалистично едновременно използване, включително с големи файлове и снимки с лошо качество. Хипотетична медиана от 45 секунди с 95-и персентил от 240 секунди описва съвсем различна услуга от такава, която постоянно приключва за около 60 секунди; нито една от двете стойности не доказва, че лечението започва по-рано.
Представянето и ескалацията при спешни лабораторни показатели изискват тестване. Резултат за калий от 6.5 mmol/L може да означава спешен медицински случай, въпреки че качеството на пробата и клиничният контекст влияят върху интерпретацията. Нашето ръководство за спешност при електролити подпомага разработването на сценарии; пациентите със спешно лабораторно известие трябва незабавно да се свържат с лекуващия екип, вместо да чакат обяснение от приложение, особено при наличие на симптоми.
Тестването на човешкия фактор измерва какво правят потребителите с отчета. При достъп чрез уеб, iOS, Android и разширение купувачите трябва да проверят поне 3 задачи: намиране на първоначалната стойност, разпознаване на несигурността и определяне на следващото подходящо действие. Отчитайте и неправилните действия, а не само времето за изпълнение, защото добре изглеждащият интерфейс може да засили доверието в неподкрепена препоръка и да затрудни забелязването на автоматизационното пристрастие.
Доказателствата за сигурност и поверителност трябва да вървят редом с клиничното валидиране
Оценката на поверителността проверява как чувствителната лабораторна информация се събира, обработва, съхранява, споделя и изтрива. Съответстващото на GDPR обработване е заявен подход, а не заместител на договорни и технически доказателства. За Kantesti Ltd, UK Company No. 17090423, купувачите трябва да установят приложимите отношения и отговорности между администратора и обработващия лични данни, преди да изпратят дори 1 идентифицируем отчет.
За здравната информация не е достатъчно само да се премахне името. Отчетът може да съдържа баркод, точна дата на раждане, регистрационен номер или подробности в свободния текст, които при съчетаване с друга информация могат да идентифицират човек. Нашите предпазни мерки за поверителност при качване обяснява практическото свеждане до минимум; купувачът трябва да оцени отделно поне 3 слоя: съдържанието на файловете, метаданните на акаунта и оперативните регистрационни файлове.
Твърденията за сигурност трябва да имат определен обхват и дата на доказателствата. Прегледайте договореностите за криптиране, контролите на достъпа, списъците с подизпълнители, условията за уведомяване при инциденти и настройките за съхранение в документацията за поверителност на данните. Ако доставчикът се позовава на одит, попитайте за коя услуга и кой контролен период се отнася той; доклад, обхващащ 1 инфраструктурен компонент, не оценява автоматично достъпа до клиничното приложение или обработката на данни от модела.
Международното внедряване създава допълнителни задължения. Използването в държави от 127+ не означава, че един договор или правно основание обхваща всяка юрисдикция, а съответствието с GDPR не предполага приложимост на HIPAA или изпълнение на изискванията ѝ. За функциите за семейства тествайте границите на разрешенията с помощта на 2 отделни акаунта, включително оттегляне на достъпа и възстановяване на акаунта; дали изтриването на даден доклад премахва и резервните копия и регистрационните файлове, трябва да има изричен отговор.
Модулът с ИИ: валидирайте прогнозите и препоръките поотделно
Двигателят с ИИ се нуждае от валидиране, специфично за всяко твърдение, за интерпретация на модели, прогнозиране на бъдещ риск и персонализирани препоръки. Това са различни задачи, дори когато са генерирани в 1 доклад. Архитектурата за дълбоко обучение и анализът на множество параметри описват начина на работа на системата; те не доказват, че нейните оценки на вероятностите, диагностичните предложения или хранителните съвети са клинично надеждни.
Интерпретацията на множество параметри трябва да запазва конкуриращите се обяснения. В хипотетичен доклад с феритин 40 ng/mL и CRP 20 mg/L само феритинът не може да даде окончателен отговор за наличността на желязо, тъй като нивото на феритина може да се повиши при острофазова реакция. Купувачите, оценяващи невронната мрежа на Kantesti, трябва да използват такива контекстно чувствителни случаи, докато обяснение на технологията остава различно от доказателствата, че конкретно клинично заключение е правилно.
Прогнозирането на риска изисква дефиниран резултат и времеви хоризонт. Вероятност от 20% е неинтерпретируема, ако не е посочено какво може да се случи, на кого и за какъв период — например хоспитализация в рамките на 30 дни, а не начало на заболяване в рамките на 5 години. TRIPOD+AI препоръчва прозрачно отчитане на проучванията на прогнозни модели (Collins et al., 2024); калибрирането и външното валидиране са важни, включително за анализ на тенденциите, свързани с лекарствата.
Персонализираните съвети създават отделно задължение за безопасност. Препоръка за хранене може да е неподходяща, когато липсва информация за бъбречната функция, лекарствата или бременността; Family Health Risk също изисква ясно третиране на несигурната или самоотчетената анамнеза. Нашият наръчник за безопасност на бъбречното хранене предлага подходящи тестови сценарии, но приемането на план за хранене с 3 елемента не е доказателство, че той подобрява резултатите или безопасно замества индивидуалната диетологична оценка.
Как работи тълкуването на кръвни изследвания с ИИ: контролен списък за валидиране от купувача
Купувачът трябва да тества цялата последователност: заснемане на източника, нормализиране, контекстуална интерпретация, генериране на доклад и клиничен преглед. Оценете всяка стъпка поотделно, преди да тествате комбинираната система. План за приемане от 5 етапа улеснява установяването дали опасният резултат е започнал с погрешно разчетена стойност, неправилно предположение или неподходяща препоръка.
Започнете с определяне на предвидената употреба и фиксиране на оценяваната версия. Стъпка 1 е писмен опис на твърденията и рисковете; стъпка 2 е заключен представителен набор от данни с предварително определени критерии за допустимост и референтни етикети. След това заснемането на PDF или снимки трябва да се тества с променени оформления, десетични разделители и нечетливи полета; отказите трябва да се документират, а не тихомълком да се изключват от крайния знаменател.
След това тествайте контекста и предположенията за надлъжно проследяване. Стъпка 3 проверява мерните единици, референтните интервали и метаданните; стъпка 4 оценява интерпретациите и препоръките с помощта на клинично значими категории за тежест. Нашето ръководство за промени между лабораторните посещения подкрепя един полезен казус: промяна на креатинина от 80 на 100 µmol/L изисква да се вземат предвид времевият интервал, вариацията на метода и пациентът, а не автоматично да се обявява влошаване.
Завършете с решение за внедряване, а не с клише за точност. Стъпка 5 оценява бъдещото използване в местни условия и обработката на неизправности спрямо критерии, договорени преди прегледа на резултатите, включително граници на неопределеността и поведение при ескалация. Поискайте досие, съдържащо потока на кохортата, версията на модела, пълната рубрика за оценяване, таблици по подгрупи, примери за неблагоприятни резултати и правила за контрол на промените; не съществува универсален процент, който да замени праговете за приемане, съобразени с последствията от грешките.
Примерни отчети и отзиви: разграничете илюстрациите от доказателствата
Примерен доклад демонстрира представянето и логиката, докато препоръката описва индивидуално впечатление. Нито едното доказва точност за отделния пациент или клинична полза. Да разгледаме ясно хипотетичен възрастен на 52 години с креатинин 118 µmol/L, отчетен eGFR 58 mL/min/1.73 m² и без налични предишни резултати: безопасното обяснение трябва да запази неопределеността.
Еднократно понижен eGFR не установява хронично бъбречно заболяване. KDIGO определя хроничното бъбречно заболяване чрез нарушения в структурата или функцията на бъбреците, налични поне 3 месеца; eGFR под 60 mL/min/1.73 m² изисква оценка на хроничността и контекста (KDIGO CKD Work Group, 2024). В този хипотетичен пример докладът трябва да препоръчва лекарска оценка и подходящо проследяване, а не да поставя диагноза за трайно бъбречно увреждане въз основа на един резултат.
Оценките, базирани на креатинин, може да са по-малко информативни при необичайно телосложение. Ако хипотетичният човек е много мускулест или наскоро е променил приема на добавки, интерпретацията трябва да отчете тези фактори, вместо да отхвърля резултата. Нашето обсъждане на креатинин при мускулести възрастни дава контекст; KDIGO подкрепя оценяването на базата на креатинин и цистатин C, когато е налично, за подходяща оценка на ХБЗ при възрастни, вместо да се приема, че първоначалната оценка е окончателна.
Демонстрациите трябва да включват трудни входни данни и неблагоприятни резултати. Добавете отделен хипотетичен резултат за калий от 6.0 mmol/L с отбелязан проблем с пробата, като използвате нашите ограничения при интерпретацията на резултати, свързани с хемолиза, за да обясните защо трябва да се вземат предвид както потвърждението, така и спешността. За Kantesti полезна оценка представлява заслепено сравнение на пълни доклади; професионалните препоръки, ако са представени със съгласие, остават обратна връзка, основана на личен опит, а не заместител на подобно тестване.
Прегръщане на бъдещето на диагностиката: внедряване, основано на доказателства
Използвайте интерпретация с ИИ само в рамките на доказателствено подкрепените приложения, с местен надзор и документирани действия при грешки. Kantesti е инструмент за анализ на кръвни изследвания с ИИ; наборът ни от функции трябва да се оценява спрямо същите стандарти за възлагане на поръчки, описани тук. Започването с 1 ограничен сценарий на употреба е по-безопасно, отколкото да се приема, че доказателствата важат за всеки пациент и всяка препоръка.
Поетапното въвеждане трябва да разграничава осъществимостта от ефективността. Хипотетична оценка на 100 доклада в „сенчест“ режим може да разкрие проблеми с интеграцията и често срещани проблеми с формулировките, без пациентите да бъдат изложени на непроверени препоръки, но е малко вероятно да установи ниска честота на редки сериозни грешки. По-широката проспективна оценка изисква обосновка на размера на извадката и резултати, съобразени с конкретното твърдение, включително ненужно проследяване, както и пропуснати проблеми.
Промените в софтуера могат да повлияят на предварително измерената ефективност. Нов модел, подканващ текст, база данни с референтни интервали или шаблон на доклада може да промени резултатите дори когато името на продукта остава същото; записвайте всичките 4 категории в историята на внедряването. Следете тежестта на грешките, въздържанията от отговор, отклоненията между подгрупите и потребителските корекции, както и определете кога дадена промяна налага целево регресионно тестване, повторна местна оценка или спиране на конкретна функция.
Решението за внедряване трябва да се основава на писмен анализ на пропуските в доказателствената база. Посочете какво е независимо установено, какво се подкрепя само от технически изпитвания и какво остава непроверено; след това възложете отговорно лице за всеки нерешен риск. Нашето канал за контакт с купувачи в здравеопазването е подходящото място да поискате документация за конкретния обхват — предпочитайте по-тясно, подкрепено с доказателства твърдение пред заглавно твърдение 99% с неясен знаменател.
Научни публикации: разграничете образователните ръководства от проучванията за валидиране
Двете препратки към DOI в хранилището по-долу посочват образователни ръководства, а не проучвания за клинично валидиране на софтуер за интерпретация с ИИ. DOI предоставя постоянен идентификатор; той не доказва експертна оценка, набиране на пациенти, независима оценка или клинична ефективност. Купувачите трябва да класифицират всяка цитирана публикация според въпроса, на който тя действително може да отговори.
Образователните ръководства могат да помогнат за съставянето на рубрика за валидиране, без сами по себе си да валидират продукта. Нашите ориентирът за комплемент и ANA може да послужи за разясняване на случаи, в които 2 измервания на комплемента и контекстът на антителата изискват внимателно обяснение. Съответствието с ръководство не е равнозначно на съответствие с независимо оценени клинични резултати при пациенти, особено когато ръководството и оценяваният софтуер имат общ организационен източник.
Ръководствата за времето на диагностиката разглеждат друг полезен тип грешка. Нашите ръководство за диагностично тестване на Nipah разглежда специализиран диагностичен контекст; не бива да се използва, за да се внушава, че рутинната лабораторна интерпретация идентифицира конкретен вирус. Ако купувачът включи дори 1 твърдение за патоген с високи последици в предвидената употреба, това твърдение изисква собствени релевантни диагностични доказателства и подходящи граници за ескалация.
Стандартите за докладване на проучвания подпомагат оценката, а не сертифицират ефективността. STARD 2015 съдържа 30 елемента за докладване на изследвания за диагностична точност, а TRIPOD+AI разглежда докладването на модели за прогнозиране; нито един от двата контролни списъка не дава на софтуера клиничен знак за одобрение. Посочените по-долу източници разграничават тези методологични източници и насоката KDIGO от 2024 г. от двете образователни публикации с DOI, така че читателите да могат да различават клиничните препоръки, насоките за докладване и специфичните за продукта доказателства.
Често задавани въпроси
0 Клинично валидиране на софтуер с ИИ за кръвни изследвания?
0 Клиничната валидация оценява дали определена версия на софтуер за AI кръвни изследвания предоставя достатъчно точни и безопасни резултати за пациентите и решенията, за които е предназначена. Тя трябва да разграничава най-малко 3 задачи: разчитане на първоначалния доклад, интерпретиране на клиничното значение и препоръчване на действие. Доказателствата трябва да описват референтния стандарт, размера на извадката на пациентско ниво, независимото тестване и обработката на неуспехи. Технически правилното обяснение само по себе си не доказва подобряване на клиничните резултати при пациентите.
Достатъчна ли е точността на 99%, за да се доверим на анализатор на кръвни изследвания с изкуствен интелект?
Твърдение за точност от 99% не може да докаже безопасност без знаменателя, определението на задачата и тежестта на грешките. В хипотетична група, в която само 1% имат целевото състояние, софтуер, който обозначава всички като отрицателни, постига точност от 99%, като не открива нито един от засегнатите пациенти. Купувачите трябва да поискат чувствителност, специфичност, грешки в докладите на ниво пациент и броя на отхвърлените входни данни. Редките, но опасни препоръки не бива да изчезват средна стойност, доминирана от лесни твърдения.
Каква е разликата между синтетичен бенчмарк и клинична валидация?
Синтетичен бенчмарк оценява софтуера върху изкуствено създадени случаи, докато клиничната валидация изисква доказателства, подходящи за предвидената пациентска популация и клиничното твърдение. Дори 100 000 синтетични случая не могат да установят разпространението в реални условия, клиничната полза или ефективността при всеки проблем с липсваща анамнеза или качеството на пробата. Синтетичното тестване може да помогне за идентифициране на технически неизправности и да подпомогне регресионните проверки. То следва да допълва, а не да заменя представителната външна и проспективна оценка.
От колко независимо тестване се нуждае изкуственият интелект в здравеопазването?
ИИ в здравеопазването се нуждае от независимо тестване, съобразено с последиците от неточен резултат, а не от универсален минимален брой отчети. Наблюдението на 0 грешки в 100 независими случая оставя приблизителна горна граница на честотата на грешки от 95%, близо до 3%, съгласно правилото на трите. Купувачите трябва да изискват защитени тестови данни, фиксирана версия на модела и оповестяване на отношенията с оценителите. Твърденията за редки сериозни грешки обикновено изискват повече доказателства, отколкото може да предостави малко пилотно проучване за използваемост или осъществимост.
Означава ли поддръжката на 100 езика еднаква точност на всеки език?
0 Поддръжката на 100 езика не гарантира еднаква клинична точност на всички тях. Оценяването по отделни езици трябва да проверява извличането на входните данни, десетичните разделители, мерните единици, отрицанието и значението на препоръките. Например глюкоза, записана като 5,6 mmol/L, не бива да се тълкува като 56 mmol/L. Купувачите трябва да изискват знаменатели за всеки език и да оповестяват кои езици не са преминали клиничен преглед.
Може ли ИИ да диагностицира хронично бъбречно заболяване въз основа на един нисък резултат за eGFR?
Един резултат от eGFR под 60 mL/min/1.73 m² сам по себе си не установява хронично бъбречно заболяване. Насоките на KDIGO от 2024 г. определят хроничното бъбречно заболяване чрез бъбречни отклонения, налични в продължение на поне 3 месеца, като се оценяват хроничността и клиничният контекст. Острите промени, телесният състав и други фактори могат да повлияят на интерпретацията. Софтуерът с изкуствен интелект трябва да обяснява несигурността и да подпомага проследяването от клиницист, вместо да определя еднократно понижена оценка като трайно заболяване.
Получете обяснение на резултатите от кръвните си изследвания
Качете лабораторния си доклад и AI на Kantesti ще обясни всеки биомаркер на разбираем език за секунди. Използва се от над 2 милиона души по света.
Референции
- Klein, T., Mitchell, S., & Weber, H. (2025). Ръководство за кръвен тест за C3, C4, комплемент и титър на ANA. Медицински изследвания с Kantesti AI. ДОИ
- Klein, T., Mitchell, S., & Weber, H. (2025). Кръвен тест за вируса Нипа: ръководство за ранно откриване и диагностика 2026. Медицински изследвания с Kantesti AI. ДОИ
- Bossuyt PM et al. (2015). STARD 2015: актуализиран списък на основните елементи за докладване на изследвания за диагностична точност. BMJ. ДОИ PubMed
- Collins GS et al. (2024). Декларация TRIPOD+AI: актуализирани насоки за докладване на клинични модели за прогнозиране, използващи регресионни методи или методи за машинно обучение. BMJ. ДОИ
- Работна група по ХБЗ на Kidney Disease: Improving Global Outcomes (KDIGO) (2024). Клинични практически насоки KDIGO 2024 за оценка и лечение на хронично бъбречно заболяване. Kidney International. ДОИ
- 2 милиона+Анализирани тестове
- 127+Държави
- 100+Езици
За медицинския екип


Сигнали за доверие E-E-A-T
Опит
Медицински преглед, воден от лекар, на работните процеси за интерпретация на лабораторни резултати.
Експертиза
Фокус в лабораторната медицина върху това как се държат биомаркерите в клиничен контекст.
Авторитетност
Медицинска рецензия от д-р Thomas Klein, с принос от д-р Sarah Mitchell и проф. д-р Hans Weber.
Надеждност
Интерпретация, основана на доказателства, с ясни последващи стъпки за намаляване на тревогата.
Медицински отказ от отговорност
Тази статия е само с образователна цел и не представлява медицински съвет. Винаги се консултирайте с квалифициран медицински специалист за решения относно диагностика и лечение.
Публикувано · Обновено · Свържете се с редакционния екип
Издава се от Kantesti Ltd, регистрирана в Англия и Уелс, дружество №. 17090423, Лондон, Обединено кралство.
