
Klinická validace znamená testování toho, zda software vytváří dostatečně přesné a bezpečné interpretace pro pacienty, pro které je určen, nikoli pouze toho, zda generuje přesvědčivé zprávy.

Klíčová sdělení
- Rozsah validace musí určit pacienty, pro které je systém určen, laboratorní vstupy a klinická rozhodnutí; úspěch u 1 úlohy nemůže potvrdit bezpečnost ve všech způsobech použití.
- Jmenovatele přesnosti je třeba rozlišovat mezi pacienty, zprávami, biomarkery a jednotlivými tvrzeními; 10 000 tvrzení může pocházet z pouhých 200 zpráv.
- Citlivost měří počet případů s pozitivním referenčním výsledkem, které byly zachyceny; hypotetický výsledek 90/100 znamená, že 10 postižených případů nebylo zachyceno.
- Prediktivní hodnota závisí na prevalenci: při prevalenci 1% vede senzitivita 90% a specificita 95% k pozitivní prediktivní hodnotě přibližně 15,4%.
- Nezávislé testování vyžaduje chráněná testovací data, zmrazenou verzi softwaru a zveřejnění informací o tom, kdo hodnocení navrhl, financoval a rozhodoval o výsledcích.
- Důkazy o podskupinách musí zahrnovat velikost vzorku a míru nejistoty; zjištění 0 přehlédnutí mezi 20 pozitivními případy nedokazuje dokonalou senzitivitu.
- Provozní rychlost přibližně 60 sekund popisuje naši funkci interpretace, nikoli prokázané snížení počtu diagnostických chyb nebo prodlev v léčbě.
- Kritéria pro zavedení by měla zahrnovat bezpečnost na úrovni pacienta, výkonnost pro jednotlivé jazyky, selhání při zadávání vstupů a zdokumentovaný postup při změnách softwaru.
Vzestup AI v lékařské diagnostice: co znamená validace
Ověření krevního testu s využitím AI vyžaduje důkazy, že konkrétní verze softwaru poskytuje přesné a bezpečné interpretace pro zamýšlené pacienty a rozhodnutí. Kupující by měli zkoumat jmenovatele na úrovni pacientů, nezávislé testování, výsledky podskupin a řešení selhání – nikoli pouze hlavní údaj o přesnosti. Kantesti je analyzátor krevních testů s využitím AI, jehož výstupy by měly podléhat stejným požadavkům na důkazy.
Interpretační software neměří původní vzorek. Laboratorní analyzátor vytváří hodnoty, například sodík 138 mmol/L; interpretační software tyto hodnoty následně načte a vysvětlí jejich možný význam, čímž vzniká další příležitost k chybě, i když je laboratorní měření správné. Kupující proto potřebují samostatné důkazy o přesnosti extrakce, práci s referenčními rozmezími a klinickém uvažování.
Klinická validita a klinická užitečnost odpovídají na různé otázky. Hodnocení může prokázat shodu u 500 zpráv, aniž by ukázalo, že se pacientům dostává lepší péče, že se vyhnou zbytečným vyšetřením nebo že přesněji rozumějí nejistotě. Náš průvodce vysvětlením lékařských zpráv vysvětluje, proč srozumitelné formulace stále vyžadují ověření zdrojů a vhodně stanovené hranice pro eskalaci.
Statistiky zavádění nemohou nahradit klinickou studii. Dosah 2M+ uživatelů v 127+ zemích uváděný naší platformou popisuje používání, nikoli reprezentativní validační kohortu s potvrzenými výsledky. Tato firemní pozadí pomáhá stanovit odpovědnost organizace; samostatný soubor důkazů musí určit přesné zamýšlené použití, způsobilou populaci a důsledky nesprávné interpretace.
Tvrzení o přesnosti: počítejte pacienty, zprávy a rozhodnutí odděleně
Tvrzení o přesnosti lze interpretovat pouze tehdy, jsou-li zveřejněny čitatel, jmenovatel a pravidla hodnocení. Údaj jako 98.49% může označovat extrahovaná pole, schválená tvrzení nebo klasifikované případy – tedy velmi odlišné úlohy. Zde je toto číslo příkladem hlavního údaje, který vyžaduje prověření, nikoli nezávisle ověřeným výsledkem klinické výkonnosti.
Opakovaná tvrzení nejsou nezávislí pacienti. V hypotetickém hodnocení 200 zpráv obsahujících po 50 hodnocených tvrzeních představuje 10 000 pozorování na úrovni tvrzení, ale stále jen 200 zpráv. Správné vysvětlení hodnoty sodíku 140 mmol/L by nemělo vyvážit nebezpečné doporučení jinde v téže zprávě; požadujte jak hodnocení na úrovni tvrzení, tak podíl zpráv s klinicky závažnými chybami.
Vyloučení vstupů může zdánlivou spolehlivost nadhodnotit. Předpokládejme, že je odesláno 1 000 zpráv, 100 je odmítnuto a 882 ze zbývajících 900 splní hodnoticí kritéria: přesnost mezi dokončenými zprávami je 98%, zatímco podíl přijatelných výstupů ze všech odeslaných zpráv činí 88.2%. Ani jeden jmenovatel není sám o sobě nečestný, kupující však potřebují oba, stejně jako důvody odmítnutí a informaci o tom, zda odmítnuté případy nepřiměřeně často zahrnují naléhavé abnormality.
Zveřejněná metodika by měla před zahájením hodnocení definovat, co se považuje za správné. Prohlášení STARD 2015 o vykazování požaduje, aby studie diagnostické přesnosti popsaly výběr účastníků, referenční standard a průběh účastníků (Bossuyt et al., 2015). Naše stránka s metodologií validace je výchozím bodem pro otázky týkající se Kantesti; bez podkladových studijních materiálů by nemělo být považováno za důkaz nezávislé výkonnosti na úrovni jednotlivých pacientů.
Senzitivita, specificita a prediktivní hodnota odpovídají na různé otázky
Senzitivita měří záchyt mezi případy s pozitivním referenčním výsledkem; specificita měří správné negativní výsledky mezi případy s negativním referenčním výsledkem. Pozitivní prediktivní hodnota vyjadřuje, jak často je pozitivní výstup správný v testovaném prostředí. U hypotetického nástroje se senzitivitou 90% a specificitou 95% při prevalenci 1% činí pozitivní prediktivní hodnota přibližně 15.4%.
Matice záměn tento kompromis zviditelňuje. Z 10 000 hypotetických pacientů při prevalenci 1% má cílové onemocnění 100: u 90 je zachyceno a 10 případů je přehlédnuto. Z 9 900 pacientů, kteří je nemají, dostane 495 falešně pozitivní výstup; správných je tedy pouze 90 z 585 pozitivních výstupů, přestože celková přesnost činí 94.95%.
Preciznost není univerzálním synonymem přesnosti. V klasifikaci se precizností obvykle rozumí pozitivní prediktivní hodnota, zatímco dodavatel může ve své hodnoticí rubrice pro narativní výstupy používat toto slovo jinak. Naše diskuse o potvrzení nízké pozitivity protilátek ilustruje klinický princip: interpretace závisí na předtestové pravděpodobnosti a potvrzení, nikoli pouze na tom, zda počáteční výsledek překročí mezní hodnotu.
Volba prahové hodnoty mění poměr mezi přehlédnutými případy a falešnými poplachy. Vyžádejte si matici záměn při navrhované prahové hodnotě pro nasazení, nikoli pouze křivku výkonnosti pokrývající mnoho prahových hodnot. V hypotetické studii systému upozorňování by snížení prahové hodnoty z 0.7 na 0.4 mohlo zvýšit senzitivitu a zároveň zdvojnásobit počet falešných upozornění; kupující musí posoudit, zda tento kompromis odpovídá klinickým důsledkům a kapacitě pro kontrolu.
Nezávislé testování vyžaduje chráněný soubor dat a důvěryhodný referenční standard
Nezávislé testování hodnotí zmrazený model na datech, která nebyla během vývoje k dispozici, a zveřejňuje vztahy hodnotitelů i klinicky obhajitelný referenční standard. Samotná externí data nezaručují nezávislé hodnocení. Studie zahrnující 3 nemocnice může stále obsahovat zkreslené štítky, sdílené datové toky nebo testovací případy, které ovlivnily ladění modelu.
Oddělení na úrovni pacientů předchází běžné formě úniku dat. Pokud se lednová zpráva pacienta použije při trénování a jeho únorová zpráva při testování, může model těžit z opakujících se vzorců nebo identifikátorů. Kupující by se měli zeptat, jak byly identifikovány duplicitní záznamy pacientů, opakované hospitalizace a zprávy ze 2 propojených laboratorních systémů a zda finální testovací soubor zůstal po výběru modelu a promptu nedotčený.
Referenční standard musí odpovídat tvrzení. Shoda odborníků při hodnocení 300 interpretací může posoudit kvalitu zpráv, ale automaticky nepotvrzuje přítomnost onemocnění ani budoucí výsledky. Tento rozdíl je dobře známý z oblasti přesnosti testu a načasování: hodnocený test, komparátor i načasování potvrzení mohou každý změnit zdánlivou výkonnost.
Syntetické benchmarky testují vytvořené případy, nikoli prevalenci onemocnění ani klinickou užitečnost v reálném světě. Ani 100,000 syntetických scénářů nemůže napodobit každou chybějící anamnézu, artefakt vzorku ani neočekávaný klinický obraz. U tvrzení týkajících se limity rozboru troponinu, studie potřebuje klinické informace a diagnostické následné vyšetření relevantní pro dané tvrzení; správná věta o laboratorní hranici nepotvrzuje diagnózu.
Výkonnost v podskupinách může odhalit rizika skrytá průměrnými hodnotami
Ověření podskupin zjišťuje, zda se výkonnost mění napříč klinicky relevantními skupinami pacientů a vstupními podmínkami. Kupující by si měli vyžádat jmenovatele, závažnost chyb a intervaly spolehlivosti pro děti, starší dospělé, těhotné ženy, osoby s poruchou funkce ledvin a další zamýšlené populace. Zjištění 0 přehlédnutí mezi 20 referenčně pozitivními případy ponechává značnou nejistotu ohledně skutečné míry přehlédnutí.
Referenční rozmezí specifická pro věk nejsou vzájemně zaměnitelná. Pediatrická interpretace nemůže bezpečně převzít všechny prahové hodnoty pro dospělé, i když jsou příslušný analyt i jednotka totožné. Náš průvodce AI interpretace pro děti vysvětluje bezpečnostní hranici; kupující by si měli vyžádat skutečné počty pro jednotlivá věková pásma, místo aby přijímali obecné tvrzení zahrnující pacienty ve věku od 1 do 18 let.
Biologický kontext je důležitější než demografické zkratky. Absolutní počet neutrofilů 1.2 × 10^9/L může vyžadovat jiný přístup u stabilního člověka s počtem spojeným s nulovým Duffyho antigenem než u někoho, komu počet během léčby nově klesá. Článek vysvětlení neutrofilů při nulovém Duffyho antigenu podporuje cílený testovací scénář; samotný původ nesmí sloužit k předpokládání genotypu ani klinické bezpečnosti.
Malé vzorky mohou skrývat klinicky významnou míru selhání. Přibližné pravidlo tří znamená, že 0 pozorovaných událostí ve 20 nezávislých pozorováních odpovídá horní hranici 95% blízké 15%, nikoli 0%. Srovnání podskupin také vyžadují analýzu zohledňující shlukování pacientů, pokud se zprávy opakují; studie by měla uvést neověřené skupiny, místo aby považovala statisticky nevýznamný rozdíl za důkaz rovnocenné výkonnosti.
Podpora více jazyků vyžaduje bezpečnostní testování pro každý jazyk zvlášť
Ověření vícejazyčnosti zjišťuje, zda se klinický význam zachová při překladu, zápisu čísel a vysvětlení pacientům v každém zamýšleném jazyce. Kantesti je platforma pro rozbor krevních výsledků s podporou jazyků 100+; tato schopnost sama o sobě neprokazuje rovnocennou klinickou výkonnost v jednotlivých jazycích. Každý jazyk vyžaduje odpovídající strategii hodnocení a zveřejnění rozsahu pokrytí.
Způsob zápisu desetinných čísel může změnit interpretovanou hodnotu. Výsledek glukózy zapsaný v jednom prostředí jako 5,6 mmol/L se po extrakci nesmí změnit na 56 mmol/L a převod jednotek musí zachovat klinický význam, nikoli pouze nahradit interpunkci. Vstupy v původním jazyce a přeložené výstupy vyhodnocujte odděleně; testování pouze anglických laboratorních zpráv přeložených do 10 jazyků přehlíží chyby při zpracování vstupů.
Negace a typ výsledku vyžadují samostatné testovací scénáře. Výrazy jako nezjištěno, pod mezí kvantifikace a nelze vyloučit vyjadřují různou míru jistoty. Náš článek průvodce kvalitativní versus kvantitativní vysvětluje tento rozdíl; hodnoticí kritéria pro dvojjazyčnou kontrolu by měla ověřovat tato významová rozlišení, včetně symbolů nerovnosti, jako je méně než 0.1, a nehodnotit pouze plynulost formulací.
Čtivost nezaručuje porozumění. Užitečné jazykové hodnocení by mohlo účastníky požádat, aby po přečtení 3 krátkých zpráv určili požadovaný postup a míru nejistoty, a současně zaznamenat, zda překlad mění naléhavost nebo doporučení týkající se léků. Jde o navrhované úkoly pro hodnocení, nikoli o univerzální ověřenou hranici; jazyky s menšími zdroji mohou vyžadovat další kontrolu, protože dostupná klinická terminologie a rozsah školení se liší.
Integrace API a formáty zpráv musí zachovat klinický význam
Ověření integrace zjišťuje, zda údaje o totožnosti pacienta, hodnoty, jednotky, data a varování zůstávají správné při přenosu mezi systémy. Výstupy HTML, JSON a PDF by měly sdělovat stejný klinický obsah, pokud jsou tyto formáty podporovány. Výsledek sodíku 128 mmol/L nesmí změnit význam kvůli tomu, že se v jednom výstupu ztratí varování nebo se v jiném zkrátí pole.
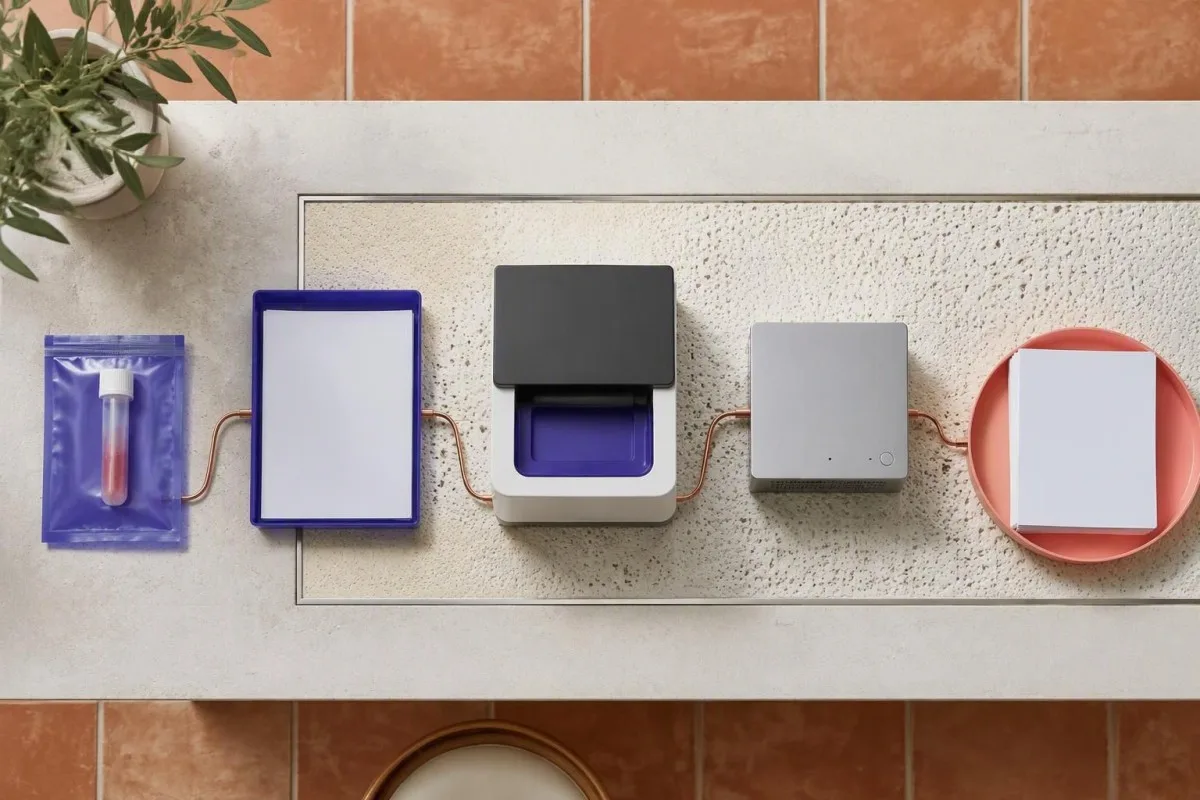
Funkční připojení k API neznamená ověřenou klinickou integraci. Naše B2B API vyžaduje kontroly specifické pro dané nasazení, které se týkají mapování, ověřování, zpracování odpovědí a chování při změně verzí; kompatibilita s EHR nebo LIS by měla být prokázána pro skutečné rozhraní. Otestujte alespoň 3 kategorie selhání — chybějící jednotky, neshodné identifikátory pacientů a opožděné duplicitní odpovědi — namísto přijetí jediné úspěšné demonstrační žádosti.
Odvozené hodnoty vyžadují výslovně uvedené vstupní údaje a původ vzorce. Například korigovaný sodík závisí na naměřeném sodíku, glukóze a použitém způsobu korekce; různé publikované koeficienty mohou vést k různým odhadům. Naše příručka ke korekci sodíku v souvislosti s glukózou nabízí klinický testovací případ, ale kupující by měli ověřit, že se s glukózou v mg/dL nikdy nezachází jako s hodnotou v mmol/L a že každý výpočet uvádí své předpoklady.
Dohoda o formátu by měla zahrnovat význam, nejen rozvržení. V hypotetickém testu exportu 300 zpráv může JSON zachovat příznak upozornění, zatímco šablona PDF jej skryje pod zalomením stránky. Porovnejte klinická doporučení, nejistotu, jednotky a časová razítka ve všech podporovaných výstupech; zachovejte dohledatelnost původních hodnot ke zdroji a stanovte, zda chybějící pole povede k bezpečnému odmítnutí, nebo k nepodložené interpretaci.
Rychlé zprávy a přívětivé rozhraní stále vyžadují důkazy z testování faktorů ovlivňujících lidskou činnost
Rychlost a použitelnost jsou provozní přínosy, nikoli přímý důkaz diagnostické přesnosti. Naše funkce interpretace obvykle vytvoří vysvětlení přibližně za 60 sekund, ale před klinickým nasazením je třeba měřit celkové zpoždění od začátku do konce, neúspěšné požadavky a náročnost kontroly. Samotná mediánová doba zpracování neukazuje, zda se naléhavé výsledky bezpečně dostanou ke správné osobě.
Latence by měla být vykazována jako rozložení hodnot. Vyžádejte si medián, 95. percentil a míru překročení časového limitu při realistickém souběžném používání, včetně velkých souborů a nekvalitních fotografií. Hypotetický medián 45 sekund s 95. percentilem 240 sekund popisuje velmi odlišnou službu než služba, která konzistentně dokončuje zpracování za přibližně 60 sekund; ani jedna z těchto hodnot nedokazuje, že léčba začne dříve.
Naléhavé laboratorní nálezy vyžadují ověřený způsob zobrazení a eskalace. Výsledek draslíku 6,5 mmol/L může ukazovat na naléhavý zdravotní stav, ačkoli interpretaci ovlivňuje kvalita vzorku a klinický kontext. Naše příručka pro naléhavé případy týkající se elektrolytů pomáhá při návrhu scénářů; pacienti s upozorněním na naléhavý laboratorní nález by měli neprodleně kontaktovat ošetřující pracoviště, a nečekat na vysvětlení aplikace, zejména pokud mají příznaky.
Testování lidských faktorů měří, jak uživatelé s výsledkem naloží. Při přístupu přes web, iOS, Android a rozšíření by kupující měli prověřit alespoň 3 úkoly: nalezení původní hodnoty, rozpoznání nejistoty a určení dalšího vhodného kroku. Zaznamenávejte i nesprávné úkony, nejen dobu dokončení, protože propracované rozhraní může zvýšit důvěru v nepodložené doporučení a ztížit rozpoznání automatizačního zkreslení.
Doklady o bezpečnosti a ochraně soukromí patří vedle klinické validace
Posouzení ochrany soukromí ověřuje, jak jsou citlivé laboratorní informace shromažďovány, zpracovávány, uchovávány, sdíleny a mazány. Zpracování v souladu s GDPR je deklarovaný přístup, nikoli náhrada smluvních a technických důkazů. V případě společnosti Kantesti Ltd, UK Company No. 17090423, by si kupující měli před odesláním byť jen 1 identifikovatelného výsledku vyjasnit příslušný vztah správce a zpracovatele i odpovědnosti.
Zdravotní informace vyžadují víc než odstranění jména. Zpráva může obsahovat čárový kód, přesné datum narození, číslo žádanky nebo podrobnosti v textu, které mohou v kombinaci s dalšími informacemi někoho identifikovat. Naše opatření na ochranu soukromí při nahrávání vysvětlete praktickou minimalizaci; kupující by měl samostatně vyhodnotit alespoň 3 vrstvy: obsah souboru, metadata účtu a provozní protokoly.
Tvrzení o zabezpečení musí mít jasně vymezený rozsah a datum doložení. Prověřte opatření šifrování, řízení přístupu, seznamy dílčích zpracovatelů, podmínky oznamování incidentů a nastavení uchovávání v dokumentaci k ochraně osobních údajů. Pokud dodavatel uvádí audit, zeptejte se, na kterou službu a období kontroly se vztahuje; zpráva pokrývající 1 infrastrukturní komponentu automaticky neposuzuje přístup ke klinické aplikaci ani nakládání s daty modelu.
Mezinárodní nasazení přináší další povinnosti. Používání v zemích 127+ neznamená, že jedna smlouva nebo právní základ pokrývá všechny jurisdikce, a soulad s GDPR neznamená použitelnost HIPAA ani splnění jejích požadavků. U funkcí pro rodiny ověřte hranice oprávnění pomocí 2 samostatných účtů, včetně odebrání přístupu a obnovení účtu; zda se smazáním zprávy odstraní také zálohy a protokoly, musí být výslovně objasněno.
Modul AI: validujte predikce a doporučení odděleně
Modul AI vyžaduje validaci vztahující se ke konkrétním tvrzením o interpretaci vzorců, předpovědi budoucího rizika a personalizovaných doporučeních. Jde o různé úkoly, i když jsou výstupem 1 zprávy. Architektura hlubokého učení a analýza více parametrů popisují, jak systém funguje; nedokládají, že jeho odhady pravděpodobnosti, diagnostické návrhy nebo výživová doporučení jsou klinicky spolehlivé.
Interpretace více parametrů by měla zachovávat i alternativní vysvětlení. Ve fiktivní zprávě s feritinem 40 ng/mL a CRP 20 mg/L nelze pouze na základě feritinu určit dostupnost železa, protože při reakci akutní fáze může hladina feritinu stoupat. Kupující hodnotící neuronovou síť Kantesti by měli použít takové případy citlivé na kontext, zatímco vysvětlení technologie zůstává odlišné od důkazu, že určitý klinický závěr je správný.
Predikce rizika vyžaduje definovaný výsledek a časový horizont. Pravděpodobnost 20% nelze interpretovat bez uvedení, co se může stát, komu a v jakém období – například hospitalizace během 30 dnů, nikoli vznik onemocnění během 5 let. Doporučení TRIPOD+AI podporuje transparentní podávání zpráv o studiích predikčních modelů (Collins et al., 2024); důležitá je kalibrace a externí validace, a to i v případě analýzy trendů souvisejících s léčivy.
Personalizované rady představují samostatnou povinnost zajistit bezpečnost. Výživové doporučení může být nevhodné, pokud nejsou známy funkce ledvin, užívané léky nebo okolnosti těhotenství; Funkce Health Risk pro rodiny rovněž vyžaduje jasný postup při nejistých nebo vlastní výpovědí poskytnutých údajích o anamnéze. Náš průvodce bezpečností výživy ledvin nabízí relevantní testovací scénáře, ale přijetí jídelníčku o 3 položkách nedokládá, že zlepšuje výsledky nebo bezpečně nahrazuje individuální posouzení dietologem.
Jak funguje rozbor krevních výsledků pomocí AI: kontrolní seznam pro kupující
Kupující by měl otestovat celý postup: zachycení zdroje, normalizaci, interpretaci v kontextu, vytvoření zprávy a klinickou kontrolu. Před testováním kombinovaného systému vyhodnoťte každý krok samostatně. Plán přejímky o 5 fázích usnadňuje určit, zda nebezpečný výstup vznikl kvůli chybně přečtené hodnotě, nesprávnému předpokladu nebo nevhodnému doporučení.
Začněte definováním zamýšleného použití a zmrazením hodnocené verze. Krok 1 představuje písemný soupis tvrzení a rizik; krok 2 uzamčený reprezentativní soubor dat s předem stanovenými kritérii způsobilosti a referenčními štítky. Následně otestujte zachycení PDF nebo fotografií s pozměněným rozvržením, různými zápisy desetinných čísel a nečitelnými poli; zaznamenejte odmítnuté případy, místo abyste je tiše vyřadili z konečného jmenovatele.
Dále otestujte kontext a dlouhodobé předpoklady. Krok 3 ověřuje jednotky, referenční rozmezí a metadata; krok 4 hodnotí interpretace a doporučení pomocí klinicky významných kategorií závažnosti. Náš průvodce změny mezi návštěvami laboratoře podporuje užitečný kritický pohled: změna kreatininu z 80 na 100 µmol/L vyžaduje zvážení načasování, variability metody a pacienta, nikoli automatické prohlášení o zhoršení.
Zakončete rozhodnutím o nasazení, nikoli sloganem o přesnosti. Krok 5 hodnotí prospektivní místní použití a zvládání selhání podle kritérií dohodnutých před přezkoumáním výsledků, včetně mezí nejistoty a postupu při eskalaci. Vyžádejte si dokumentaci obsahující tok kohorty, verzi modelu, úplnou hodnoticí rubriku, tabulky podskupin, příklady nežádoucích výstupů a pravidla řízení změn; žádné univerzální procento nemůže nahradit akceptační prahové hodnoty odpovídající důsledkům chyb.
Ukázkové zprávy a reference: oddělujte ilustraci od důkazů
Ukázková zpráva demonstruje prezentaci a uvažování, zatímco svědectví popisuje individuální dojem. Ani jedno nedokládá přesnost na úrovni pacienta ani klinický přínos. Zvažte jasně hypotetického dospělého ve věku 52 let s kreatininem 118 µmol/L, uvedenou eGFR 58 mL/min/1.73 m² a bez dostupných předchozích výsledků: bezpečné vysvětlení musí zachovat nejistotu.
Jediná snížená eGFR nepotvrzuje chronické onemocnění ledvin. KDIGO definuje chronické onemocnění ledvin jako abnormality struktury nebo funkce ledvin přítomné po dobu nejméně 3 měsíců; eGFR pod 60 mL/min/1.73 m² vyžaduje posouzení chronicity a souvislostí (KDIGO CKD Work Group, 2024). V tomto hypotetickém příkladu by zpráva měla doporučit posouzení lékařem a vhodné následné kontroly, nikoli na základě jediného výsledku diagnostikovat trvalé poškození ledvin.
Odhady založené na kreatininu mohou být méně informativní při neobvyklém tělesném složení. Pokud je hypotetická osoba velmi svalnatá nebo nedávno změnila užívání doplňků, interpretace by měla tyto faktory zohlednit, nikoli výsledek odmítnout. Naše pojednání o kreatininem u svalnatých dospělých poskytuje souvislosti; KDIGO podporuje, je-li dostupný, odhad pomocí kreatininu a cystatinu C při odpovídajícím posuzování chronického onemocnění ledvin u dospělých, namísto předpokladu, že počáteční odhad je definitivní.
Ukázky by měly zahrnovat obtížné vstupy a nepříznivé výstupy. Přidejte samostatný hypotetický výsledek draslíku 6.0 mmol/L s upozorněním na problém se vzorkem a použijte naše informace o omezeních výsledků souvisejících s hemolýzou k vysvětlení, proč je nutné zvážit potvrzení výsledku i naléhavost. U nástroje Kantesti je užitečným způsobem hodnocení zaslepené porovnání úplných zpráv; profesní svědectví, jsou-li uvedena se souhlasem, zůstávají zpětnou vazbou založenou na zkušenostech, nikoli náhradou takového testování.
Přijetí budoucnosti diagnostiky: zavádění založené na důkazech
Zavádějte interpretaci pomocí AI pouze pro použití podložená důkazy, s místním dohledem a zdokumentovaným postupem při chybách. Kantesti je nástroj pro analýzu krevních testů využívající AI; naši sadu funkcí je třeba posuzovat podle stejných standardů pro zadávání zakázek, které jsou popsány zde. Začít jedním omezeným případem použití je bezpečnější než předpokládat, že se důkazy vztahují na každého pacienta a každé doporučení.
Postupné zavádění by mělo rozlišovat mezi proveditelností a účinností. Hypotetické stínové hodnocení 100 zpráv může odhalit chyby v integraci a běžné problémy s formulacemi, aniž by pacienti byli vystaveni nezkontrolovaným doporučením, ale pravděpodobně neprokáže nízkou míru vzácných závažných chyb. Rozsáhlejší prospektivní hodnocení vyžaduje zdůvodnění velikosti vzorku a výsledné ukazatele odpovídající skutečnému tvrzení, včetně zbytečných následných vyšetření i přehlédnutých problémů.
Změny softwaru mohou ovlivnit dříve naměřenou výkonnost. Nový model, prompt, databáze referenčních rozmezí nebo šablona zprávy mohou změnit výstupy, i když název produktu zůstane stejný; zaznamenávejte všechny 4 kategorie v historii nasazení. Sledujte závažnost chyb, zdržení se odpovědi, posuny mezi podskupinami a zásahy uživatelů a určete, kdy změna vyžaduje cílené regresní testování, opakované místní hodnocení nebo pozastavení konkrétní funkce.
Rozhodnutí o přijetí by mělo vycházet z písemné analýzy nedostatků v důkazech. Určete, co je nezávisle potvrzené, co je podloženo pouze technickým testováním a co nebylo ověřeno; poté každému nevyřešenému riziku přiřaďte odpovědnou osobu. Naše kontaktní kanál pro zájemce z oblasti zdravotnictví je vhodným místem k vyžádání dokumentace pro konkrétní rozsah použití — upřednostněte užší, doložené tvrzení před titulkem 99% s nejasným jmenovatelem.
Vědecké publikace: rozlišujte mezi vzdělávacími příručkami a validačními studiemi
Níže uvedené 2 odkazy DOI na repozitáře odkazují na vzdělávací příručky, nikoli na klinické validační studie softwaru pro interpretaci pomocí AI. DOI poskytuje trvalý identifikátor; nedokládá recenzní řízení, nábor pacientů, nezávislé hodnocení ani klinickou účinnost. Kupující by měli každou citovanou publikaci zařadit podle toho, na jakou otázku může skutečně odpovědět.
Vzdělávací příručky mohou pomoci sestavit kritéria validace, samy však produkt nevalidují. Náš průvodce komplementem a ANA mohou pomoci při vysvětlování případů, kdy je třeba pečlivě objasnit 2 doplňující měření a souvislosti s protilátkami. Shoda s příručkou není totéž co shoda s nezávisle posouzenými výsledky pacientů, zejména pokud mají příručka a hodnocený software společný organizační zdroj.
Příručky k načasování diagnostiky se zabývají dalším užitečným typem selhání. Náš Průvodce diagnostickým testováním Nipah se zabývá specializovaným diagnostickým kontextem; neměla by být používána k naznačení, že rutinní laboratorní interpretace identifikuje konkrétní virus. Pokud kupující zahrne do zamýšleného použití byť jen 1 tvrzení o patogenu s vysokými důsledky, toto tvrzení vyžaduje vlastní relevantní diagnostické důkazy a náležité hranice eskalace.
Standardy pro vykazování studií podporují hodnocení, nikoli certifikaci výkonnosti. STARD 2015 obsahuje 30 položek pro vykazování výzkumu diagnostické přesnosti, zatímco TRIPOD+AI se zabývá vykazováním predikčních modelů; žádný z těchto kontrolních seznamů neuděluje softwaru klinické schválení. Níže uvedené reference oddělují tyto metodologické zdroje a doporučení KDIGO z roku 2024 od 2 vzdělávacích položek DOI, aby čtenáři mohli rozlišit klinická doporučení, pokyny pro vykazování a důkazy specifické pro produkt.
Často kladené dotazy
Co je klinická validace softwaru AI pro krevní testy?
Klinická validace hodnotí, zda konkrétní verze softwaru pro krevní testy s AI poskytuje dostatečně přesné a bezpečné výstupy pro zamýšlené pacienty a rozhodnutí. Měla by oddělovat alespoň 3 úkoly: čtení zdrojové zprávy, interpretaci klinického významu a doporučení dalšího postupu. Důkazy by měly popisovat referenční standard, počet vzorků na úrovni pacientů, nezávislé testování a řešení selhání. Technicky správné vysvětlení samo o sobě nedokazuje zlepšení výsledků pacientů.
Je přesnost 99% dostatečná k tomu, abychom mohli důvěřovat analyzátoru krevních testů s umělou inteligencí?
Tvrzení o přesnosti 99% nemůže prokázat bezpečnost bez uvedení jmenovatele, definice úlohy a závažnosti chyb. V hypotetické skupině, kde má cílové onemocnění pouze 1% osob, dosahuje software, který všechny označí jako negativní, přesnosti 99%, přičemž nezachytí žádného z postižených pacientů. Zájemci o nákup by měli požadovat senzitivitu, specificitu, chyby ve zprávách na úrovni pacientů a počet zamítnutých vstupů. Vzácná, ale nebezpečná doporučení by se neměla ztrácet v průměru, kterému dominují snadná tvrzení.
Jaký je rozdíl mezi syntetickým benchmarkem a klinickou validací?
0 Syntetický benchmark hodnotí software na uměle vytvořených případech, zatímco klinická validace vyžaduje důkazy odpovídající zamýšlené populaci pacientů a klinickému tvrzení. Ani 100 000 syntetických případů nemůže stanovit prevalenci v reálném světě, klinický přínos ani výkonnost při všech problémech s chybějící anamnézou a kvalitou vzorků. Syntetické testování může pomoci odhalit technická selhání a podpořit regresní testování. Mělo by doplňovat, nikoli nahrazovat reprezentativní externí a prospektivní hodnocení.
Kolik nezávislého testování zdravotnická umělá inteligence potřebuje?
AI ve zdravotnictví potřebuje nezávislé testování úměrné důsledkům nesprávného výstupu, nikoli univerzální minimální počet hlášení. Pozorování 0 selhání ve 100 nezávislých případech ponechává přibližnou horní mez míry selhání podle pravidla tří poblíž 3%. Kupující by měli požadovat chráněná testovací data, zmrazenou verzi modelu a zveřejněné vztahy hodnotitelů. Tvrzení o vzácných závažných chybách obvykle vyžadují více důkazů, než může poskytnout malý pilot zaměřený na použitelnost nebo proveditelnost.
Znamená podpora 100 jazyků stejnou přesnost v každém z nich?
Podpora 100 jazyků nedokládá stejnou klinickou přesnost ve všech těchto jazycích. Hodnocení pro jednotlivé jazyky by mělo ověřovat extrakci vstupních údajů, zápis desetinných čísel, jednotky, negaci a význam doporučení. Například glukóza zapsaná jako 5,6 mmol/L nesmí být interpretována jako 56 mmol/L. Zájemci o nákup by si měli vyžádat jmenovatele pro jednotlivé jazyky a uvést, které jazyky neprošly klinickou revizí.
Dokáže AI diagnostikovat chronické onemocnění ledvin na základě jediného nízkého výsledku eGFR?
Jediný výsledek eGFR nižší než 60 mL/min/1.73 m² sám o sobě nestanovuje chronické onemocnění ledvin. Doporučení KDIGO z roku 2024 definuje chronické onemocnění ledvin jako abnormality ledvin přetrvávající alespoň 3 měsíce; při posouzení se zohledňuje chronicita a klinický kontext. Interpretaci mohou ovlivnit akutní změny, tělesná stavba a další faktory. Software využívající AI by měl vysvětlit nejistotu a podporovat následné klinické sledování, nikoli označovat jediný snížený odhad za trvalé onemocnění.
Nechte si vysvětlit výsledky krevních testů
Nahrajte svou laboratorní zprávu a AI Kantesti během několika sekund vysvětlí jednotlivé biomarkery srozumitelným jazykem. Používá ji více než 2 miliony lidí na celém světě.
Reference
- Klein, T., Mitchell, S. a Weber, H. (2025). Průvodce krevními testy C3 a C4 a titrem ANA. Lékařský výzkum AI Kantesti. DOI
- Klein, T., Mitchell, S. a Weber, H. (2025). Krevní test na virus Nipah: Průvodce včasnou detekcí a diagnostikou 2026. Lékařský výzkum AI Kantesti. DOI
- Bossuyt PM et al. (2015). STARD 2015: aktualizovaný seznam základních položek pro vykazování studií diagnostické přesnosti. BMJ. DOI PubMed
- Collins GS et al. (2024). Prohlášení TRIPOD+AI: aktualizované pokyny pro vykazování klinických predikčních modelů využívajících regresní metody nebo metody strojového učení. BMJ. DOI
- Pracovní skupina pro CKD organizace Kidney Disease: Improving Global Outcomes (KDIGO) (2024). Klinické doporučení KDIGO 2024 pro vyšetření a léčbu chronického onemocnění ledvin. Kidney International. DOI
- 2 miliony+Analyzovaná vyšetření
- 127+země
- 100+Jazyky
O lékařském týmu


Signály důvěry E-E-A-T
Zažít
Lékařem vedená klinická revize pracovních postupů pro interpretaci laboratorních výsledků.
Odbornost
Zaměření laboratorní medicíny na to, jak se biomarkery chovají v klinickém kontextu.
Autoritativnost
Lékařskou kontrolu provedl Dr. Thomas Klein, s přispěním Dr. Sarah Mitchell a prof. Dr. Hanse Webera.
Důvěryhodnost
Interpretace založená na důkazech s jasnými následnými kroky pro snížení poplachu.
Lékařské upozornění
Tento článek je pouze pro vzdělávací účely a nepředstavuje lékařské poradenství. Pro rozhodnutí o diagnóze a léčbě se vždy poraďte s kvalifikovaným poskytovatelem zdravotních služeb.
Publikováno · Aktualizováno · Kontaktujte redakční tým
Vydává Kantesti Ltd, registrovaná v Anglii a Walesu, číslo společnosti. 17090423, Londýn, Spojené království.
