
Klinik doğrulama, yazılımın yalnızca ikna edici raporlar üretip üretmediğini değil, hedeflenen hastalar için yeterince doğru ve güvenli yorumlar sunup sunmadığını test etmek anlamına gelir.

Temel çıkarımlar
- Doğrulama kapsamı hedeflenen hastaları, laboratuvar girdilerini ve klinik kararları belirlemelidir; 1 görevdeki başarı, tüm kullanımlarda güvenliği kanıtlayamaz.
- Doğruluk paydaları hastaları, raporları, biyobelirteçleri ve tek tek ifadeleri birbirinden ayırmalıdır; 10.000 ifade yalnızca 200 rapordan gelmiş olabilir.
- Hassasiyet referans standardına göre pozitif vakaların ne kadarının saptandığını ölçer; varsayımsal 90/100 sonucu, etkilenen 10 vakanın gözden kaçırıldığı anlamına gelir.
- Öngörü değeri prevalansa bağlıdır: prevalans, duyarlılık ve %1 özgüllük, yaklaşık ,4 pozitif öngörü değeri verir.
- Bağımsız testler korunan test verileri, dondurulmuş bir yazılım sürümü ve değerlendirmeyi kimin tasarladığının, finanse ettiğinin ve sonuçları karara bağladığının açıklanmasını gerektirir.
- Alt grup kanıtları örneklem büyüklüklerini ve belirsizliği içermelidir; 20 pozitif olguda hiç kaçırma olmaması, duyarlılığın mükemmel olduğunu kanıtlamaz.
- Operasyonel hız yaklaşık 60 saniye olması, tanısal hatalarda veya tedavi gecikmelerinde kanıtlanmış bir azalmayı değil, yorumlama özelliğimizin hızını tanımlar.
- Benimseme kriterleri hasta düzeyinde güvenliği, dile özgü performansı, girdi hatalarını ve yazılım değişikliklerine verilen yanıtın belgelenmesini kapsamalıdır.
Tıbbi Tanıda Yapay Zekânın Yükselişi: Doğrulama Ne Anlama Geliyor?
AI kan testi doğrulaması belirli bir yazılım sürümünün, hedeflenen hastalar ve kararlar için doğru ve güvenli yorumlar ürettiğine dair kanıt gerektirir. Alıcılar yalnızca manşet niteliğindeki bir doğruluk yüzdesini değil; hasta düzeyindeki paydaları, bağımsız testleri, alt grup sonuçlarını ve hata yönetimini incelemelidir. Kantesti, çıktıları aynı kanıt gerekliliklerine tabi tutulması gereken bir AI kan testi analizörüdür.
Yorumlama yazılımı orijinal numuneyi ölçmez. Bir laboratuvar analizörü, sodyumun 138 mmol/L olması gibi değerler üretir; yorumlama yazılımı daha sonra bu değerleri okuyup olası önemlerini açıklar ve laboratuvar ölçümü doğru olsa bile ikinci bir hata olasılığı yaratır. Bu nedenle alıcıların veri çıkarma doğruluğu, referans aralığı yönetimi ve klinik akıl yürütme için ayrı kanıtlara ihtiyacı vardır.
Klinik geçerlilik ve klinik fayda farklı sorulara yanıt verir. Bir değerlendirme, 500 raporda uyum olduğunu gösterebilir; ancak hastaların daha iyi bakım aldığını, gereksiz tetkiklerden kaçındığını veya belirsizliği daha doğru anladığını göstermeyebilir. Bizim tıbbi rapor açıklama kılavuzumuz anlaşılır ifadelerin neden yine de kaynak kontrolüne ve uygun yönlendirme sınırlarına ihtiyaç duyduğunu açıklar.
Benimsenme istatistikleri bir klinik çalışmanın yerini tutamaz. Platformumuzun bildirdiği 2M+ kullanıcının 127+ ülkedeki erişimi, kullanımı tanımlar; doğrulanmış sonuçlara sahip temsili bir doğrulama kohortunu değil. şirket geçmişi kurumsal hesap verebilirliğin tesis edilmesine yardımcı olur; ayrı bir kanıt dosyası, amaçlanan kullanımın tam olarak ne olduğunu, uygun hasta popülasyonunu ve yanlış bir yorumun sonuçlarını belirtmelidir.
Doğruluk İddiaları: Hastaları, Raporları ve Kararları Ayrı Ayrı Sayın
Bir doğruluk iddiası, payı, paydası ve puanlama kuralları açıklandığında ancak yorumlanabilir. 98.49% gibi bir değer; çıkarılan alanları, kabul edilen ifadeleri veya sınıflandırılmış olguları tanımlayabilir—bunlar birbirinden çok farklı görevlerdir. Burada bu sayı, inceleme gerektiren manşet niteliğinde bir iddia örneğidir; bağımsız olarak doğrulanmış bir klinik performans sonucu değildir.
Tekrarlanan ifadeler, birbirinden bağımsız hastalar değildir. Varsayımsal bir değerlendirmede, her birinde puanlanan 50 ifade bulunan 200 rapor, ifade düzeyinde 10.000 gözlem sağlar; ancak rapor sayısı yine de yalnızca 200'dür. 140 mmol/L sodyumun doğru açıklanması, aynı raporun başka bir yerindeki tehlikeli bir öneriyi geçersiz kılmamalıdır; hem ifade düzeyinde puanlama hem de klinik açıdan ciddi sonuçlar doğurabilecek hatalar içeren raporların oranı talep edilmelidir.
Hariç tutulan girdiler, görünürdeki güvenilirliği artırabilir. Diyelim ki 1.000 rapor gönderildi, 100'ü reddedildi ve kalan 900 rapordan 882'si ölçütleri karşıladı: tamamlanan raporlardaki doğruluk 98% iken, gönderimler genelinde başarılı ve kabul edilebilir çıktı oranı 88.2% olur. Her iki payda da özünde yanıltıcı değildir; ancak alıcıların her ikisine de, ayrıca ret nedenlerine ve reddedilen olguların acil anormallikler içerme olasılığının orantısız olup olmadığına ihtiyacı vardır.
Yayımlanan yöntem, puanlama başlamadan önce neyin doğru sayıldığını tanımlamalıdır. STARD 2015 raporlama bildirimi, tanısal doğruluk çalışmalarında katılımcı seçiminin, referans standardın ve katılımcı akışının açıklanmasını ister (Bossuyt et al., 2015). Bizim doğrulama metodolojisi sayfası Kantesti hakkındaki sorular için bir başlangıç noktasıdır; temel çalışma materyalleri olmadan bağımsız hasta düzeyindeki performansın kanıtı olarak değerlendirilmemelidir.
Duyarlılık, Özgüllük ve Öngörü Değeri Farklı Soruları Yanıtlar
Duyarlılık, referans standarda göre pozitif vakaların saptanmasını ölçer; özgüllük, referans standarda göre negatif vakaların doğru biçimde belirlenmesini ölçer. Pozitif öngörü değeri, test edilen ortamda pozitif bir çıktının ne sıklıkta doğru olduğunu ölçer. 1% prevalansta 90% duyarlılığa ve 95% özgüllüğe sahip varsayımsal bir araç için pozitif öngörü değeri yaklaşık 15.4%'tür.
Bir karışıklık matrisi bu ödünleşimi görünür kılar. 1% prevalansa sahip varsayımsal 10.000 hastanın 100'ünde hedeflenen durum vardır: 90'ı saptanır, 10'u gözden kaçar. Bu durumun bulunmadığı 9.900 kişinin 495'i yanlış pozitif çıktı alır; sonuç olarak, genel doğruluk 94.95% olsa da 585 pozitif çıktının yalnızca 90'ı doğrudur.
Kesinlik, doğruluğun her durumda kullanılan eş anlamlısı değildir. Sınıflandırmada kesinlik genellikle pozitif öngörü değeri anlamına gelirken, bir tedarikçinin anlatı puanlama rubriğinde bu sözcük farklı bir anlamda kullanılabilir. Bizim düşük pozitif antikor sonucunun doğrulanmasına ilişkin değerlendirmemiz klinik ilkeyi ortaya koyar: yorumlama, yalnızca ilk sonucun eşiği aşıp aşmadığına değil, test öncesi olasılığa ve doğrulamaya bağlıdır.
Eşik seçimi, gözden kaçan vakalarla yanlış alarmlar arasındaki dengeyi değiştirir. Birçok eşiği kapsayan yalnızca bir performans eğrisi değil, önerilen devreye alma eşiğindeki karışıklık matrisini isteyin. Varsayımsal bir uyarı çalışmasında, eşiğin 0.7'den 0.4'e düşürülmesi duyarlılığı artırırken yanlış uyarıları iki katına çıkarabilir; alıcılar, bu ödünleşimin klinik sonuçlara ve inceleme kapasitesine uygun olup olmadığına karar vermelidir.
Bağımsız Testler, Korunan Bir Veri Kümesi ve Güvenilir Bir Referans Standardı Gerektirir
Bağımsız test, geliştirme sırasında erişilemeyen veriler üzerinde dondurulmuş bir modelin; değerlendirici ilişkileri açıklanarak ve klinik açıdan savunulabilir bir referans standardıyla değerlendirilmesini kapsar. Yalnızca harici veriler kullanılması, bağımsız değerlendirmeyi garanti etmez. Üç hastanenin yer aldığı bir çalışmada bile etiketler yanlı olabilir, veri hatları ortak olabilir veya test vakaları model ayarını etkilemiş olabilir.
Hasta düzeyinde ayrım, yaygın bir veri sızıntısı biçimini önler. Bir hastanın ocak ayına ait raporu eğitim verilerine, şubat ayına ait raporu ise test verilerine girerse model tekrarlayan örüntülerden veya tanımlayıcılardan yararlanabilir. Alıcılar, yinelenen hastaların, tekrarlanan yatışların ve birbiriyle bağlantılı 2 laboratuvar sisteminden gelen raporların nasıl belirlendiğini ve model ile istem seçiminin ardından nihai test kümesinin hiç kullanılmadan korunup korunmadığını sormalıdır.
Referans standardı, iddiayla uyumlu olmalıdır. 300 yorum üzerinde uzmanlar arasındaki uyum, rapor kalitesini değerlendirebilir; ancak bu, hastalığın varlığını veya gelecekteki sonuçları kendiliğinden doğrulamaz. Bu ayrım, test doğruluğu ve zamanlamakonusundan tanıdıktır: değerlendirilmekte olan test, karşılaştırıcı ve doğrulamanın zamanlaması, performansın görünürdeki düzeyini ayrı ayrı değiştirebilir.
Sentetik kıyaslamalar, gerçek dünyadaki hastalık prevalansını veya klinik yararı değil, oluşturulmuş vakaları test eder. 100.000 sentetik senaryo bile eksik öykülerin, numune artefaktlarının veya beklenmedik klinik tabloların her türünü taklit edemez. Şunları içeren iddialar için troponin yorumlama sınırları, bir çalışmanın iddiayla ilgili klinik bilgilere ve tanısal takibe ihtiyacı vardır; laboratuvar eşiği hakkında doğru bir cümle, doğrulanmış bir tanı değildir.
Alt Grup Performansı, Ortalamada Gizli Kalan Riskleri Ortaya Çıkarabilir
Alt grup doğrulaması, klinik açıdan anlamlı hasta grupları ve girdi koşulları arasında performansın değişip değişmediğini test eder. Alıcılar çocuklar, yaşlı yetişkinler, gebelik, böbrek yetmezliği ve hedeflenen diğer popülasyonlar için paydaları, hata şiddetini ve güven aralıklarını talep etmelidir. Referans sonucu pozitif 20 vakada 0 kaçırma gözlemlenmesi, gerçek kaçırma oranı konusunda kayda değer bir belirsizlik bırakır.
Yaşa özgü referans aralıkları birbirinin yerine kullanılamaz. Altta yatan analit ve birim aynı olsa bile, pediatrik bir yorum her yetişkin eşiğini güvenle devralamaz. Rehberimiz Çocuklar için YZ yorumu güvenlik sınırını açıklar; alıcılar 1 ile 18 yaş arasındaki hastaları kapsayan geniş bir iddiayı kabul etmek yerine gerçek yaş grubu sayılarını talep etmelidir.
Biyolojik bağlam, demografik kestirme yollardan daha önemlidir. 1.2 × 10^9/L mutlak nötrofil sayısı, Duffy-null ile ilişkili sayımı bulunan stabil bir kişide, tedavi sırasında yeni bir düşüş yaşayan bir kişiden farklı bir değerlendirme gerektirebilir. Duffy-null nötrofil açıklamamız hedefe yönelik bir test vakasını destekler; soy bilgisi tek başına genotip veya klinik güvenlik varsayımında bulunmak için kullanılmamalıdır.
Küçük örneklemler klinik açıdan anlamlı hata oranlarını gizleyebilir. Yaklaşık üç kuralına göre, 20 bağımsız gözlemde 0 olay gözlemlenmesi, 0% değil, 15% civarında bir üst 95% sınırına karşılık gelir. Raporlar tekrar içerdiğinde alt grup karşılaştırmaları hasta bazında kümelenmiş analiz de gerektirir; çalışma, anlamlı olmayan bir farkı performansın eşdeğer olduğunun kanıtı saymak yerine test edilmemiş grupları açıklamalıdır.
Çok Dilli Destek, Dile Özgü Güvenlik Testleri Gerektirir
Çok dilli doğrulama, klinik anlamın hedeflenen her dilde çeviri, sayısal biçimlendirme ve hastaya yönelik açıklama boyunca korunup korunmadığını kontrol eder. Kantesti, 100+ dil desteği sunan bir AI blood test interpretation platformudur; ancak bu özellik tek başına söz konusu dillerde eşdeğer klinik performans olduğunu kanıtlamaz. Her dil için uygun bir değerlendirme stratejisi ve açıklanmış kapsam gerekir.
Ondalık gösterim kuralları yorumlanan değeri değiştirebilir. Bir yerel ayarda 5,6 mmol/L olarak yazılan bir glikoz sonucu, çıkarım sonrasında 56 mmol/L'ye dönüşmemelidir; birim dönüşümü yalnızca noktalama işaretlerini değiştirmekle kalmamalı, klinik anlamı da korumalıdır. Özgün dildeki girdileri ve çevrilmiş çıktıları ayrı ayrı değerlendirin; yalnızca 10 dile çevrilmiş İngilizce laboratuvar raporlarını test etmek, girdi tarafındaki hataları gözden kaçırır.
Olumsuzluk ve sonuç türü için özel test vakaları gerekir. Saptanmadı, ölçüm sınırının altında ve dışlanamaz gibi ifadeler farklı kesinlik derecelerini belirtir. nitel ve nicel kılavuzumuz ayrımı açıklar; iki dilli bir inceleme rubriği, yalnızca akıcı ifadeleri ödüllendirmek yerine, 0.1'den küçüktür gibi eşitsizlik sembolleri de dâhil olmak üzere bu anlamları test etmelidir.
Okunabilirlik, anlamayı garanti etmez. Yararlı bir dil değerlendirmesinde katılımcılardan 3 kısa raporu okuduktan sonra gerekli eylemi ve belirsizliği belirlemeleri istenebilir; ayrıca çevirinin aciliyeti veya ilaç önerisini değiştirip değiştirmediği kaydedilebilir. Bunlar önerilen değerlendirme görevleridir, evrensel olarak doğrulanmış eşikler değildir; mevcut klinik terminoloji ve eğitim kapsamı farklılık gösterdiğinden, kaynakları daha kısıtlı diller için ek inceleme gerekebilir.
API Entegrasyonu ve Raporlama Biçimleri Klinik Anlamı Korunmalıdır
Entegrasyon doğrulaması, hasta kimliği, değerler, birimler, tarihler ve uyarıların sistem sınırları boyunca doğruluğunu koruyup korumadığını test eder. Desteklendiği durumlarda HTML, JSON ve PDF çıktıları aynı klinik içeriği aktarmalıdır. 128 mmol/L sodyum sonucu, bir çıktı uyarıyı kaybettiği veya diğeri bir alanı kestiği için anlam değiştirmemelidir.
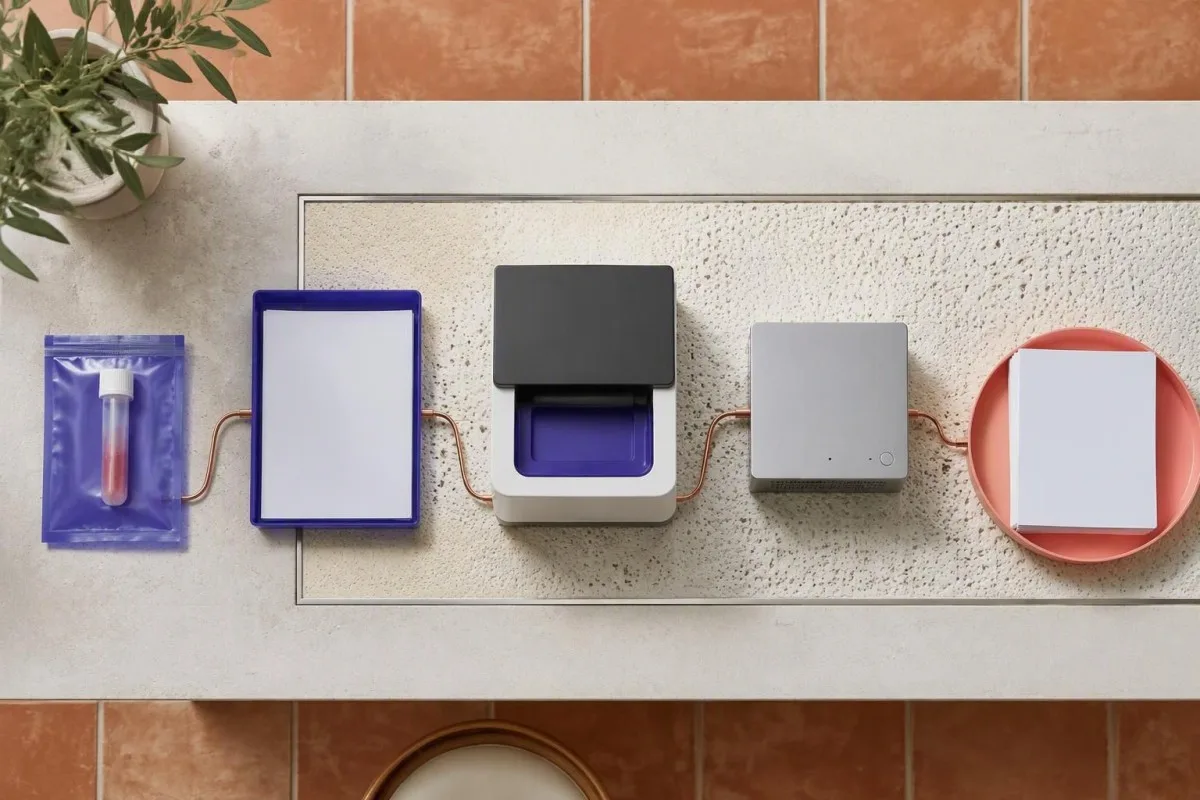
Çalışan bir API bağlantısı, doğrulanmış bir klinik entegrasyon değildir. B2B API'miz; eşleme, kimlik doğrulama, yanıt işleme ve sürüm davranışının dağıtıma özgü olarak kontrol edilmesini gerektirir; EHR veya LIS uyumluluğu, gerçek arayüz için gösterilmelidir. Tek bir başarılı gösterim isteğini kabul etmek yerine en az 3 hata sınıfını test edin: eksik birimler, uyuşmayan hasta tanımlayıcıları ve gecikmiş yinelenen yanıtlar.
Türetilmiş değerler, girdilerin ve formül kaynağının açıkça belirtilmesini gerektirir. Örneğin düzeltilmiş sodyum; ölçülen sodyum, glikoz ve düzeltme yaklaşımına bağlıdır; yayımlanmış farklı katsayılar farklı tahminler verebilir. Bizim glikoza bağlı sodyum düzeltme kılavuzumuz klinik bir test senaryosu sunar; ancak alıcılar, mg/dL cinsinden glikozun hiçbir zaman mmol/L olarak değerlendirilmediğini ve her hesaplamada varsayımların belirtildiğini doğrulamalıdır.
Biçim anlaşması yalnızca düzeni değil, anlamı da kapsamalıdır. Varsayımsal 300 rapor dışa aktarma testinde JSON kritik bir işareti korurken PDF şablonu bunu sayfa sonunun altına gizleyebilir. Desteklenen çıktılardaki klinik önerileri, belirsizliği, birimleri ve zaman damgalarını karşılaştırın; ham değerlerin kaynağa kadar izlenebilir olmasını sağlayın ve eksik bir alanın güvenli bir reddetmeye mi yoksa desteklenmeyen bir yoruma mı yol açacağını belirtin.
Hızlı Raporlar ve Kullanışlı Bir Arayüz İçin de İnsan Faktörlerine İlişkin Kanıt Gerekir
Hız ve kullanılabilirlik operasyonel faydalardır; tanısal doğruluğun doğrudan kanıtı değildir. Yorumlama özelliğimiz genellikle yaklaşık 60 saniyede bir açıklama üretir; ancak klinik kullanıma geçişte uçtan uca gecikme, başarısız istekler ve inceleme yükü ölçülmelidir. Tek başına medyan işlem süresi, acil sonuçların doğru kişiye güvenli biçimde ulaşıp ulaşmadığını gösteremez.
Gecikme, dağılım olarak raporlanmalıdır. Büyük dosyalar ve düşük kaliteli fotoğraflar dahil olmak üzere, gerçekçi eşzamanlı kullanım koşullarında medyanı, 95. yüzdelik dilimi ve zaman aşımı oranını isteyin. Medyanı 45 saniye ve 95. yüzdelik dilimi 240 saniye olan varsayımsal bir hizmet, sürekli olarak yaklaşık 60 saniyede tamamlanan bir hizmetten çok farklıdır; bu iki ölçüm de tedavinin daha erken başladığını kanıtlamaz.
Acil laboratuvar örüntülerinin sunumu ve yönlendirilmesi test edilmelidir. 6.5 mmol/L potasyum sonucu tıbbi acil duruma işaret edebilir; ancak numune kalitesi ve klinik bağlam yorumu etkiler. Bizim elektrolit aciliyeti kılavuzumuz senaryo tasarımını destekler; acil laboratuvar uyarısı alan hastalar, özellikle belirtileri varsa, bir uygulamanın açıklamasını beklemek yerine vakit kaybetmeden tedavi hizmetiyle iletişime geçmelidir.
İnsan faktörleri testleri, kullanıcıların raporu nasıl kullandığını ölçer. Web, iOS, Android ve uzantı tabanlı erişimde alıcılar en az 3 görevi incelemelidir: özgün değeri bulmak, belirsizliği fark etmek ve uygun sonraki adımı belirlemek. Tamamlama süresinin yanı sıra yanlış eylemleri de kaydedin; çünkü şık bir arayüz, desteklenmeyen bir öneriye duyulan güveni artırabilir ve otomasyon yanlılığını fark etmeyi zorlaştırabilir.
Güvenlik ve Gizlilik Kanıtları Klinik Doğrulamanın Yanında Yer Almalıdır
Gizlilik değerlendirmesi, hassas laboratuvar bilgilerinin nasıl toplandığını, işlendiğini, saklandığını, paylaşıldığını ve silindiğini doğrular. GDPR ile uyumlu işleme, beyan edilen bir yaklaşımdır; sözleşmeye dayalı ve teknik kanıtların yerini tutmaz. Kantesti Ltd, Birleşik Krallık Şirket No. 17090423 için alıcılar, kimliği belirlenebilir tek bir raporu bile göndermeden önce geçerli veri sorumlusu–veri işleyen ilişkisini ve sorumluluklarını belirlemelidir.
Sağlık bilgilerinin korunması için bir adı kaldırmaktan fazlası gerekir. Bir raporda barkod, kesin doğum tarihi, erişim numarası veya başka bilgilerle birleştirildiğinde bir kişiyi tanımlayabilecek anlatı niteliğinde ayrıntılar bulunabilir. Bizim yükleme gizliliği önlemlerimiz pratik veri minimizasyonunu açıklar; bir alıcı en az 3 katmanı ayrı ayrı değerlendirmelidir: dosya içeriği, hesap meta verileri ve operasyonel günlükler.
Güvenlik iddiaları için kapsamın ve kanıt tarihinin tanımlanmış olması gerekir. Şifreleme düzenlemelerini, erişim kontrollerini, alt işleyen listelerini, olay bildirim koşullarını ve saklama ayarlarını şu bölümde veri gizliliği belgeleri. Bir tedarikçi bir denetimden söz ederse, bunun hangi hizmeti ve kontrol dönemini kapsadığını sorun; 1 altyapı bileşenini kapsayan bir rapor, klinik uygulama erişimini veya model verilerinin işlenmesini otomatik olarak değerlendirmiş olmaz.
Uluslararası dağıtım ek yükümlülükler doğurur. 127+ ülkesinde kullanım, tek bir sözleşmenin veya hukuki dayanağın tüm yargı bölgelerini kapsadığı anlamına gelmez; GDPR ile uyum, HIPAA'nın uygulanabilir olduğu veya gerekliliklerinin karşılandığı anlamına da gelmez. Aile özellikleri için, erişimin geri alınması ve hesap kurtarma da dâhil olmak üzere, izin sınırlarını 2 ayrı hesap kullanarak sınayın; bir raporun silinmesinin yedekleri ve günlükleri de kaldırıp kaldırmadığı konusunda açık bir yanıt gerekir.
Yapay Zekâ Motoru: Tahminleri ve Önerileri Ayrı Ayrı Doğrulayın
Bir yapay zekâ motorunun örüntü yorumlama, gelecekteki riski tahmin etme ve kişiselleştirilmiş öneriler sunma konularında iddia bazında doğrulanması gerekir. Tek bir raporda oluşturulsalar bile bunlar farklı görevlerdir. Derin öğrenme mimarisi ve çok parametreli analiz, bir sistemin nasıl çalıştığını açıklar; olasılık tahminlerinin, tanısal önerilerinin veya beslenme tavsiyelerinin klinik açıdan güvenilir olduğunu kanıtlamaz.
Çok parametreli yorumlama, birbiriyle yarışan açıklamaları korumalıdır. Ferritinin 40 ng/mL ve CRP'nin 20 mg/L olduğu varsayımsal bir raporda, ferritin tek başına demir kullanılabilirliği sorusunu yanıtlayamaz; çünkü ferritin akut faz yanıtıyla yükselebilir. Kantesti'nin sinir ağını değerlendiren alıcılar, bu tür bağlama duyarlı vakaları kullanmalıdır; bu arada teknoloji açıklaması belirli bir klinik sonucun doğru olduğuna dair kanıtlardan ayrı kalır.
Risk tahmini, tanımlı bir sonuç ve zaman aralığı gerektirir. 20% olasılığı, ne olabileceği, kimin başına gelebileceği ve hangi süre içinde gerçekleşebileceği belirtilmeden yorumlanamaz; örneğin, 5 yıl içinde hastalığın başlaması yerine 30 gün içinde hastaneye yatış. TRIPOD+AI, tahmin modeli çalışmaları için şeffaf raporlamayı önerir (Collins ve ark., 2024); ilaçla ilişkili eğilim analizinde de kalibrasyon ve dış doğrulama önemlidir ilaçla ilişkili eğilim analizi.
Kişiselleştirilmiş tavsiyeler ayrı bir güvenlik yükümlülüğü doğurur. Böbrek işlevi, ilaçlar veya gebelik durumu bilinmiyorsa beslenme önerisi uygun olmayabilir; Aile Sağlığı Riski özelliğinin de belirsiz veya kişinin kendi beyanına dayanan öyküyü nasıl ele aldığı açıkça belirtilmelidir. Bizim böbrek beslenme güvenlik rehberi ilgili test senaryoları sunar; ancak 3 öğelik bir yemek planını kabul etmek, bunun sonuçları iyileştirdiğinin veya kişiye özel diyetisyen değerlendirmesinin güvenli bir ikamesi olduğunun kanıtı değildir.
Yapay Zekâ ile kan tahlili yorumlama nasıl çalışır: Alıcılar için doğrulama kontrol listesi
Alıcı tüm süreci sınamalıdır: kaynak verinin alınması, normalizasyon, bağlamsal yorumlama, rapor oluşturma ve klinik inceleme. Birleşik sistemi sınamadan önce her adımı ayrı ayrı değerlendirin. 5 aşamalı bir kabul planı, güvenli olmayan bir çıktının yanlış okunan bir değerden mi, hatalı bir varsayımdan mı yoksa uygunsuz bir öneriden mi kaynaklandığını belirlemeyi kolaylaştırır.
Amaçlanan kullanımı tanımlayarak ve değerlendirilen sürümü sabitleyerek başlayın. 1. adım, yazılı bir iddia ve risk envanteridir; 2. adım ise önceden tanımlanmış uygunluk ölçütleri ve referans etiketleri içeren, kilitlenmiş ve temsili bir veri kümesidir. Ardından PDF veya fotoğraf alımı; değiştirilmiş düzenler, ondalık gösterim biçimleri ve okunaksız alanlar kullanılarak sınanmalıdır; retleri, son paydadaki değerlerden sessizce çıkarmak yerine belgeleyin.
Sonra bağlamı ve boylamsal varsayımları sınayın. 3. adım birimleri, referans aralıklarını ve meta verileri kontrol eder; 4. adım yorumları ve önerileri klinik açıdan anlamlı şiddet kategorileri kullanarak puanlar. Rehberimiz laboratuvar ziyaretleri arasında değişir yararlı bir değerlendirme olanağı sunar: kreatininin 80'den 100 µmol/L'ye çıkması, otomatik olarak kötüleşme ilan etmek yerine zamanlamanın, test yöntemi değişkenliğinin ve hastanın göz önünde bulundurulmasını gerektirir.
Bir doğruluk sloganıyla değil, bir kullanıma alma kararıyla bitirin. 5. adım, sonuçlar incelenmeden önce üzerinde anlaşılmış ölçütler doğrultusunda ileriye dönük yerel kullanımı ve hata yönetimini değerlendirir; buna belirsizlik sınırları ve üst kademeye iletme davranışı da dahildir. Kohort akışını, model sürümünü, puanlama ölçütlerinin tamamını, alt grup tablolarını, olumsuz çıktı örneklerini ve değişiklik kontrol kurallarını içeren bir dosya talep edin; hiçbir evrensel yüzde, hata sonuçlarına uygun kabul eşiklerinin yerini tutamaz.
Örnek Raporlar ve Görüşler: Görselliği Kanıtlardan Ayırın
Örnek bir rapor sunumu ve akıl yürütme biçimini gösterirken, bir referans görüşü bireysel bir izlenimi aktarır. Bunların hiçbiri hasta düzeyinde doğruluğu veya klinik yararı kanıtlamaz. Kreatinini 118 µmol/L, bildirilen eGFR değeri 58 mL/dk/1,73 m² olan ve önceki sonuçları bulunmayan, tamamen varsayımsal 52 yaşında bir yetişkini düşünelim: güvenli açıklama belirsizliği korumalıdır.
Tek bir düşük eGFR değeri kronik böbrek hastalığını kanıtlamaz. KDIGO, kronik böbrek hastalığını en az 3 aydır mevcut olan böbrek yapısı veya işlevindeki anormallikler üzerinden tanımlar; 60 mL/dk/1,73 m²'nin altındaki bir eGFR değeri, kronikliğin ve bağlamın değerlendirilmesini gerektirir (KDIGO CKD Çalışma Grubu, 2024). Bu varsayımsal örnekte rapor, tek bir sonuca dayanarak kalıcı böbrek hasarı tanısı koymak yerine klinisyen değerlendirmesi ve uygun takip önermelidir.
Kreatinine dayalı tahminler, olağandışı vücut kompozisyonlarında daha az bilgilendirici olabilir. Varsayımsal kişi çok kaslıysa veya takviye kullanımını yakın zamanda değiştirdiyse, yorum bu etkenleri göz ardı etmek yerine dikkate almalıdır. kaslı yetişkinlerde kreatinin tartışmamız bağlam sağlar; KDIGO, ilk tahminin kesin olduğunu varsaymak yerine, uygun yetişkin CKD değerlendirmesinde mevcut olduğu durumlarda kreatinin-sistatin C ile tahmini destekler.
Gösterimlerde zorlayıcı girdiler ve olumsuz çıktılar yer almalıdır. Ayrı bir varsayımsal potasyum sonucu olarak 6.0 mmol/L değerini ve örnekte saptanan bir sorunu ekleyin; hemolize bağlı sonuç sınırlamalarını kullanarak doğrulama ve aciliyetin neden birlikte değerlendirilmesi gerektiğini açıklayın. Kantesti için yararlı bir değerlendirme, eksiksiz raporların körlemesine karşılaştırılmasıdır; izin alınarak sunulan profesyonel referans görüşleri, bu tür testlerin yerine geçmekten ziyade deneyime dayalı geri bildirim olarak kalır.
Tanının Geleceğini Kucaklamak: Kanıta Dayalı Benimseme
Yapay zekâ yorumlamasını yalnızca kanıtlarla desteklenen kullanım alanlarında, yerel gözetim ve hatalara yönelik belgelenmiş bir yanıt süreciyle benimseyin. Kantesti, yapay zekâ destekli bir kan testi analiz aracıdır; özellik setimiz burada açıklanan satın alma standartlarıyla aynı ölçütlere göre değerlendirilmelidir. Her hastaya ve öneriye ilişkin kanıtların geçerli olduğunu varsaymak yerine, tek bir sınırlı kullanım senaryosuyla başlamak daha güvenlidir.
Aşamalı bir uygulama, uygulanabilirliği etkililikten ayırmalıdır. Varsayımsal 100 raporluk bir gölge değerlendirmesi, hastaları incelenmemiş önerilere maruz bırakmadan entegrasyon hatalarını ve sık karşılaşılan ifade sorunlarını ortaya çıkarabilir; ancak nadir görülen ciddi hataların düşük oranını kanıtlaması olası değildir. Daha kapsamlı ileriye dönük değerlendirmeler, gerçek iddiayla uyumlu sonuçları ve kaçırılan sorunların yanı sıra gereksiz takipleri de içeren, örneklem büyüklüğüne ilişkin bir gerekçe gerektirir.
Yazılım değişiklikleri, daha önce ölçülen performansı değiştirebilir. Ürün adı aynı kalsa bile yeni bir model, istem, referans aralığı veri tabanı veya rapor şablonu çıktıları değiştirebilir; 4 kategorinin tamamını kullanıma alma geçmişine kaydedin. Hata şiddetini, yanıt vermekten kaçınma durumlarını, alt grup kaymalarını ve kullanıcı geçersiz kılmalarını izleyin; bir değişikliğin hedefli regresyon testini, yenilenmiş yerel değerlendirmeyi veya belirli bir işlevin askıya alınmasını ne zaman gerektireceğini tanımlayın.
Benimseme kararı, yazılı bir kanıt boşluğu analizine dayanmalıdır. Nelerin bağımsız olarak kanıtlandığını, nelerin yalnızca teknik testlerle desteklendiğini ve nelerin henüz test edilmediğini belirleyin; ardından çözümlenmemiş her risk için bir sorumlu atayın. Bizim sağlık hizmetleri alıcı iletişim kanalı kapsama özgü belgeleri talep etmek için uygun yerdir—belirsiz bir paydaya sahip 99% başlığı yerine daha dar kapsamlı, kanıtlarla desteklenen bir iddiayı tercih edin.
Araştırma Yayınları: Eğitim Rehberlerini Doğrulama Çalışmalarından Ayırın
Aşağıdaki 2 depo DOI referansı, AI yorumlama yazılımlarına ilişkin klinik doğrulama çalışmaları değil, eğitici kılavuzları tanımlar. Bir DOI kalıcı bir tanımlayıcı sağlar; hakem değerlendirmesi, hasta alımı, bağımsız değerlendirme veya klinik etkinlik kanıtlamaz. Alıcılar, atıf yapılan her yayını, yanıtlayabileceği gerçek soruya göre sınıflandırmalıdır.
Eğitici kılavuzlar, ürünü kendileri doğrulamadan bir doğrulama rubriği oluşturmaya yardımcı olabilir. Bizim kompleman ve ANA rehberi 2 kompleman ölçümünün ve antikor bağlamının dikkatle açıklanması gereken durumlarda bilgi sağlayabilir. Bir kılavuzla uyum, özellikle kılavuz ile değerlendirilen yazılım aynı kurumsal kaynağı paylaşıyorsa, bağımsız olarak karara bağlanmış hasta sonuçlarıyla uyum anlamına gelmez.
Tanı zamanlamasına ilişkin kılavuzlar, başka bir yararlı hata türünü ele alır. Bizim Nipah tanı testi kılavuzu özel bir tanı bağlamını ele alır; rutin laboratuvar yorumlamasının belirli bir virüsü saptadığını ima etmek için kullanılmamalıdır. Alıcı, kullanım amacına sonuçları ağır olabilecek tek bir patojen iddiasını bile dahil ederse, bu iddia kendi ilgili tanı kanıtlarını ve uygun yönlendirme sınırlarını gerektirir.
Çalışma raporlama standartları, performansı belgelendirmekten ziyade değerlendirmeyi destekler. STARD 2015, tanısal doğruluk araştırmaları için 30 raporlama maddesi içerirken TRIPOD+AI, tahmin modellerinin raporlanmasını ele alır; bu kontrol listelerinin hiçbiri yazılıma klinik onay vermez. Aşağıdaki referanslar, bu metodolojik kaynakları ve 2024 KDIGO kılavuzunu 2 eğitici DOI kaydından ayırarak okuyucuların klinik önerileri, raporlama kılavuzlarını ve ürüne özgü kanıtları birbirinden ayırt etmesini sağlar.
Sıkça sorulan sorular
Yapay zekâ kan testi yazılımının klinik doğrulaması nedir?
Klinik validasyon, belirtilen bir yapay zekâ kan testi yazılımı sürümünün, amaçlanan hastalar ve kararlar için yeterince doğru ve güvenli çıktılar üretip üretmediğini değerlendirir. En az 3 görevi birbirinden ayırmalıdır: kaynak raporu okuma, klinik anlamı yorumlama ve bir eylem önerme. Kanıtlar referans standardı, hasta düzeyindeki örneklem büyüklüğünü, bağımsız testleri ve başarısızlıkların ele alınmasını açıklamalıdır. Teknik olarak doğru bir açıklama, hasta sonuçlarının iyileştiğini tek başına kanıtlamaz.
99% doğruluğu, yapay zekâ destekli bir kan testi analizörüne güvenmek için yeterli mi?
Paydası, görev tanımı ve hata şiddeti bilinmeden doğruluk iddiası güvenliği kanıtlayamaz. Hedef durumun yalnızca oranında görüldüğü varsayımsal bir grupta, herkesi negatif olarak etiketleyen bir yazılım etkilenen hastaların hiçbirini tespit edememesine rağmen doğruluğa ulaşır. Alıcılar duyarlılık, özgüllük, hasta düzeyindeki rapor hataları ve reddedilen girdi sayısını talep etmelidir. Nadir görülen ancak tehlikeli öneriler, kolay ifadelerin ağırlıkta olduğu bir ortalamanın içinde kaybolmamalıdır.
Sentetik bir kıyaslama ile klinik doğrulama arasındaki fark nedir?
0 Sentetik bir kıyaslama testi, yazılımı oluşturulmuş vakalar üzerinde değerlendirirken klinik doğrulama, hedeflenen hasta popülasyonu ve klinik iddia için uygun kanıt gerektirir. 100.000 sentetik vaka bile gerçek dünyadaki prevalansı, klinik faydayı veya eksik öykü ve numune kalitesiyle ilgili her sorundaki performansı ortaya koyamaz. Sentetik testler teknik arızaların belirlenmesine ve regresyon kontrollerinin desteklenmesine yardımcı olabilir. Temsili dış değerlendirme ve prospektif değerlendirmeyi tamamlamalı, bunların yerini almamalıdır.
0 Healthcare yapay zekâsının ne kadar bağımsız teste ihtiyacı var?
0 Healthcare yapay zekâsı, evrensel bir asgari rapor sayısı değil, hatalı bir çıktının sonuçlarıyla orantılı bağımsız testler gerektirir. Birbirinden bağımsız 100 vakada 0 başarısızlık gözlemlenmesi, üç kuralına göre yaklaşık %3'lük bir üst başarısızlık oranı sınırı bırakır. Alıcılar koruma altındaki test verilerini, sabitlenmiş bir model sürümünü ve değerlendiricilerle olan ilişkilerin açıklanmasını talep etmelidir. Nadir görülen ciddi hatalara ilişkin iddialar, genellikle küçük bir kullanılabilirlik veya fizibilite pilotunun sağlayabileceğinden daha fazla kanıt gerektirir.
100 dili desteklemesi, her dilde aynı doğruluk oranını sağladığı anlamına mı geliyor?
100 dili desteklemesi, bu dillerin tümünde klinik doğruluğun eşit olduğunu göstermez. Dile özgü değerlendirme; girdi çıkarımını, ondalık gösterim kurallarını, birimleri, olumsuzluğu ve önerilerin anlamını sınamalıdır. Örneğin, 5,6 mmol/L olarak yazılan glikoz 56 mmol/L olarak yorumlanmamalıdır. Alıcılar, dile özgü paydaları talep etmeli ve hangi dillerin klinik incelemeden geçmediğini açıklamalıdır.
Yapay zekâ, tek bir düşük eGFR sonucundan kronik böbrek hastalığını teşhis edebilir mi?
60 mL/min/1.73 m²’nin altında tek bir eGFR sonucu, tek başına kronik böbrek hastalığı tanısı koydurmaz. 2024 KDIGO kılavuzu, kronik böbrek hastalığını en az 3 ay boyunca mevcut olan böbrek anormallikleriyle tanımlar; kronikliğin ve klinik bağlamın değerlendirilmesini öngörür. Akut değişiklikler, vücut bileşimi ve diğer faktörler yorumlamayı etkileyebilir. Yapay zekâ yazılımı, tek bir düşük tahmini kalıcı hastalık olarak etiketlemek yerine belirsizliği açıklamalı ve klinisyenin takibini desteklemelidir.
Kan tahlili sonuçları ne anlama gelir
Laboratuvar raporunuzu yükleyin; Kantesti'nin AI'ı her biyobelirteci saniyeler içinde sade bir dille açıklar. Dünya genelinde 2 milyondan fazla kişi tarafından kullanılıyor.
Referanslar
- Klein, T., Mitchell, S. ve Weber, H. (2025). C3 C4 Kompleman Kan Testi ve ANA Titre Kılavuzu. Kantesti AI Tıbbi Araştırma. DOI
- Klein, T., Mitchell, S. ve Weber, H. (2025). Nipah Virüsü Kan Testi: Erken Saptama ve Tanı Kılavuzu 2026. Kantesti AI Tıbbi Araştırma. DOI
- Bossuyt PM ve diğerleri (2015). STARD 2015: tanısal doğruluk çalışmalarının raporlanması için güncellenmiş temel maddeler listesi. BMJ. DOI PubMed
- Collins GS ve diğerleri (2024). TRIPOD+AI bildirisi: regresyon veya makine öğrenimi yöntemlerini kullanan klinik tahmin modellerinin raporlanmasına yönelik güncellenmiş kılavuz. BMJ. DOI
- Böbrek Hastalığı: Küresel Sonuçların İyileştirilmesi (KDIGO) KBH Çalışma Grubu (2024). Kronik Böbrek Hastalığının Değerlendirilmesi ve Yönetimine Yönelik KDIGO 2024 Klinik Uygulama Kılavuzu. Kidney International. DOI
- 2 milyondan fazlaAnaliz edilen testler
- 127+Ülkeler
- 100+Diller
Sağlık ekibi hakkında


E-E-A-T Güven Sinyalleri
Deneyim
Hekim liderliğinde laboratuvar yorumlama iş akışlarının klinik incelemesi.
Uzmanlık
Klinik bağlamda biyobelirteçlerin nasıl davrandığına odaklanan laboratuvar tıbbı.
Otorite
Dr. Thomas Klein tarafından tıbbi açıdan incelenmiş; Dr. Sarah Mitchell ve Prof. Dr. Hans Weber'in katkılarıyla hazırlanmıştır.
Güvenilirlik
Alarmı azaltmaya yönelik net takip yollarıyla kanıta dayalı yorumlama.
Tıbbi sorumluluk reddi
Bu makale yalnızca eğitim amaçlıdır ve tıbbi tavsiye niteliği taşımaz. Tanı ve tedavi kararları için her zaman yetkin bir sağlık hizmeti sağlayıcısına danışın.
Yayınlanmış · Güncellendi · Yayın ekibiyle iletişime geçin
Kantesti Ltd tarafından yayımlanmıştır; İngiltere ve Galler'de kayıtlı, şirket no. 17090423, Londra, Birleşik Krallık.
