
La validation clinique consiste à tester si le logiciel fournit des interprétations suffisamment exactes et sûres pour les patients auxquels il est destiné — et non simplement s’il génère des rapports convaincants.

Points clés à retenir
- Portée de la validation doit préciser les patients visés, les données de laboratoire et les décisions cliniques ; la réussite d’une tâche ne permet pas d’établir la sécurité pour toutes les utilisations.
- Dénominateurs d’exactitude doivent distinguer les patients, les rapports, les biomarqueurs et les énoncés individuels ; 10 000 énoncés peuvent provenir de seulement 200 rapports.
- Sensibilité mesure les cas positifs selon l’étalon de référence qui ont été détectés ; un résultat hypothétique de 90/100 signifie que 10 cas concernés n’ont pas été détectés.
- Valeur prédictive dépend de la prévalence : avec une prévalence de 1%, une sensibilité de 90% et une spécificité de 95% produisent une valeur prédictive positive d’environ 15.4%.
- Tests indépendants nécessitent des données de test protégées, une version figée du logiciel et la divulgation de l’identité des personnes ayant conçu, financé et évalué l’évaluation.
- Données probantes par sous-groupe doit inclure les tailles d’échantillon et l’incertitude ; ne détecter aucune erreur parmi 20 cas positifs ne permet pas d’établir une sensibilité parfaite.
- Vitesse opérationnelle d’environ 60 secondes décrit notre fonctionnalité d’interprétation, et non une réduction démontrée des erreurs diagnostiques ou des retards de traitement.
- Les critères d’adoption devraient couvrir la sécurité au niveau des patients, les performances propres à chaque langue, les échecs de saisie et une procédure documentée pour répondre aux modifications logicielles.
L’essor de l’IA dans le diagnostic médical : ce que signifie la validation
Validation des analyses sanguines par IA exige des éléments démontrant qu’une version logicielle spécifiée produit des interprétations exactes et sûres pour les patients et les décisions auxquels elle est destinée. Les acheteurs devraient examiner les dénominateurs au niveau des patients, les tests indépendants, les résultats par sous-groupe et la gestion des défaillances — et ne pas se fier uniquement à un pourcentage d’exactitude mis en avant. Kantesti est un analyseur d’analyses sanguines par IA dont les résultats devraient être soumis aux mêmes exigences en matière de preuves.
Un logiciel d’interprétation ne mesure pas l’échantillon d’origine. Un analyseur de laboratoire produit des valeurs telles que le sodium à 138 mmol/L ; le logiciel d’interprétation lit ensuite ces valeurs et en explique la signification possible, créant ainsi une seconde possibilité d’erreur même lorsque la mesure du laboratoire est correcte. Les acheteurs ont donc besoin de preuves distinctes concernant l’exactitude de l’extraction, la gestion des intervalles de référence et le raisonnement clinique.
La validité clinique et l’utilité clinique répondent à des questions différentes. Une évaluation pourrait montrer une concordance sur 500 comptes rendus sans démontrer que les patients reçoivent de meilleurs soins, évitent des examens inutiles ou comprennent mieux l’incertitude. Notre guide d’explication des comptes rendus médicaux explique pourquoi une formulation compréhensible nécessite tout de même une vérification des sources et des limites appropriées quant aux situations nécessitant une prise en charge renforcée.
Les statistiques d’adoption ne peuvent remplacer une étude clinique. Notre portée déclarée par la plateforme, soit 2M+ utilisateurs dans 127+ pays, décrit l’utilisation, et non une cohorte de validation représentative dont les résultats ont été confirmés. Le historique de l’entreprise contribue à établir la responsabilisation organisationnelle ; un dossier de preuves distinct doit préciser l’utilisation prévue exacte, la population admissible et les conséquences d’une interprétation erronée.
Revendications d’exactitude : compter séparément les patients, les rapports et les décisions
Une affirmation d’exactitude n’est interprétable que si son numérateur, son dénominateur et ses règles de notation sont divulgués. Un chiffre tel que 98.49% pourrait désigner des champs extraits, des affirmations acceptées ou des cas classifiés — des tâches très différentes. Ici, ce chiffre est un exemple d’affirmation mise en avant qui doit être examinée avec soin, et non un résultat de performance clinique vérifié de manière indépendante.
Des affirmations répétées ne correspondent pas à des patients indépendants. Dans une évaluation hypothétique, 200 comptes rendus contenant chacun 50 affirmations notées donnent 10 000 observations au niveau des affirmations, mais toujours seulement 200 comptes rendus. Une explication correcte du sodium à 140 mmol/L ne devrait pas compenser une recommandation dangereuse ailleurs dans le même compte rendu ; exigez à la fois une notation au niveau des affirmations et la proportion de comptes rendus contenant des erreurs aux conséquences cliniques.
L’exclusion des données d’entrée peut gonfler la fiabilité apparente. Supposons que 1 000 comptes rendus soient soumis, que 100 soient rejetés et que 882 des 900 restants satisfassent aux critères : l’exactitude parmi les comptes rendus traités est de 98%, tandis que la proportion de résultats acceptables obtenus parmi les soumissions est de 88.2%. Aucun des deux dénominateurs n’est intrinsèquement malhonnête, mais les acheteurs ont besoin des deux, ainsi que des motifs de rejet et de savoir si les cas rejetés concernent de manière disproportionnée des anomalies urgentes.
La méthodologie publiée devrait définir ce qui était considéré comme correct avant le début de la notation. La déclaration STARD 2015 sur la présentation des études demande aux études d’exactitude diagnostique de décrire la sélection des participants, l’étalon de référence et le parcours des participants (Bossuyt et al., 2015). Notre page sur la méthodologie de validation constitue un point de départ pour les questions sur Kantesti ; il ne doit pas être considéré comme une preuve de performance indépendante au niveau du patient sans les documents sous-jacents de l’étude.
La sensibilité, la spécificité et la valeur prédictive répondent à des questions différentes
La sensibilité mesure la détection parmi les cas positifs selon l’étalon de référence ; la spécificité mesure les résultats négatifs corrects parmi les cas négatifs selon l’étalon de référence. La valeur prédictive positive mesure la fréquence à laquelle un résultat positif est correct dans le contexte testé. Pour un outil hypothétique présentant une sensibilité de 90% et une spécificité de 95% à une prévalence de 1%, la valeur prédictive positive est d’environ 15.4%.
Une matrice de confusion rend le compromis visible. Parmi 10 000 patients hypothétiques à une prévalence de 1%, 100 présentent la maladie cible : 90 sont détectés et 10 ne le sont pas. Parmi les 9 900 qui ne la présentent pas, 495 reçoivent des résultats faussement positifs ; par conséquent, seuls 90 des 585 résultats positifs sont corrects, même si l’exactitude globale est de 94.95%.
La précision n’est pas un synonyme universel de l’exactitude. En classification, la précision désigne généralement la valeur prédictive positive, tandis que la grille d’évaluation narrative d’un fournisseur peut employer le terme différemment. Notre analyse de la confirmation d’un résultat positif faible pour les anticorps illustre le principe clinique : l’interprétation dépend de la probabilité prétest et de la confirmation, et pas seulement du fait qu’un résultat initial dépasse un seuil.
Le choix du seuil modifie l’équilibre entre les cas non détectés et les fausses alertes. Demandez la matrice de confusion au seuil de déploiement proposé, et pas seulement une courbe de performance couvrant de nombreux seuils. Dans une étude hypothétique sur les alertes, abaisser un seuil de 0.7 à 0.4 pourrait améliorer la sensibilité tout en doublant les fausses alertes ; les acheteurs doivent déterminer si ce compromis est adapté aux conséquences cliniques et à la capacité d’examen.
Les tests indépendants nécessitent un jeu de données protégé et un étalon de référence crédible
Les tests indépendants évaluent un modèle figé sur des données indisponibles pendant son développement, avec divulgation des liens avec les évaluateurs et un étalon de référence cliniquement défendable. Les données externes ne garantissent pas à elles seules une évaluation indépendante. Une étude menée dans 3 hôpitaux peut malgré tout comporter des étiquettes biaisées, des chaînes de traitement des données partagées ou des cas de test ayant influencé l’ajustement du modèle.
La séparation au niveau du patient évite une forme courante de fuite de données. Si le compte rendu de janvier d’un patient entre dans les données d’entraînement et son compte rendu de février dans les données de test, le modèle peut tirer parti de motifs récurrents ou d’identifiants. Les acheteurs devraient demander comment les patients en double, les admissions répétées et les comptes rendus provenant de 2 systèmes de laboratoire reliés ont été repérés, et si le jeu de test final est resté intact après la sélection du modèle et des prompts.
L’étalon de référence doit correspondre à l’allégation. L’accord entre experts sur 300 interprétations peut servir à évaluer la qualité des comptes rendus, mais ne confirme pas automatiquement la présence d’une maladie ni les résultats futurs. Cette distinction est bien connue dans le domaine de l’exactitude des tests et du moment de leur réalisation: le test évalué, le comparateur et le moment de la confirmation peuvent chacun modifier les performances apparentes.
Les bancs d’essai synthétiques évaluent des cas construits, et non la prévalence des maladies ou l’utilité clinique dans le monde réel. Même 100,000 scénarios synthétiques ne peuvent reproduire chaque antécédent manquant, artefact de prélèvement ou présentation inattendue. Pour les allégations portant sur les limites d’interprétation de la troponine, une étude nécessite les informations cliniques et le suivi diagnostique pertinents pour l’allégation ; une phrase correcte sur un seuil de laboratoire ne constitue pas un diagnostic confirmé.
Les performances par sous-groupe peuvent révéler des risques masqués par la moyenne
Les tests de validation des sous-groupes vérifient si les performances varient selon les groupes de patients et les conditions d’entrée cliniquement pertinents. Les acheteurs devraient demander les dénominateurs, la gravité des erreurs et les intervalles de confiance pour les enfants, les personnes âgées, les femmes enceintes, les personnes atteintes d’insuffisance rénale et les autres populations visées. L’observation de 0 cas manqués parmi 20 cas positifs selon la méthode de référence laisse une grande incertitude quant au véritable taux de cas manqués.
Les intervalles de référence spécifiques à l’âge ne sont pas interchangeables. Une interprétation pédiatrique ne peut pas reprendre sans risque tous les seuils adultes, même lorsque l’analyte et l’unité sous-jacents sont identiques. Notre guide sur Interprétation de l'IA pour les enfants explique la limite de sécurité ; les acheteurs devraient demander le nombre réel de patients dans chaque tranche d’âge plutôt que d’accepter une allégation générale couvrant les patients de 1 à 18 ans.
Le contexte biologique compte davantage que les raccourcis démographiques. Un nombre absolu de neutrophiles de 1.2 × 10^9/L peut nécessiter un raisonnement différent chez une personne stable présentant un nombre associé à un phénotype Duffy-null que chez une personne dont le nombre a récemment diminué pendant un traitement. Le explication des neutrophiles Duffy-null permet de définir un cas de test ciblé ; l’ascendance seule ne doit pas servir à présumer un génotype ou une sécurité clinique.
De petits échantillons peuvent masquer des taux d’échec cliniquement significatifs. La règle approximative de trois signifie que 0 événement observé sur 20 observations indépendantes correspond à une borne supérieure de 95% proche de 15%, et non de 0%. Les comparaisons entre sous-groupes nécessitent également une analyse regroupée par patient lorsque les rapports se répètent ; une étude devrait signaler les groupes non testés plutôt que de considérer une différence non significative comme une preuve d’équivalence des performances.
La prise en charge multilingue nécessite des tests de sécurité propres à chaque langue
La validation multilingue vérifie si le sens clinique est préservé lors de la traduction, du formatage numérique et des explications destinées aux patients dans chaque langue visée. Kantesti est une plateforme d’interprétation des prises de sang par IA prenant en charge 100+ langues ; cette capacité n’établit pas à elle seule l’équivalence des performances cliniques dans ces langues. Chaque langue nécessite une stratégie d’évaluation appropriée et une couverture déclarée.
Les conventions décimales peuvent modifier la valeur interprétée. Un résultat de glycémie écrit 5,6 mmol/L dans une langue régionale ne doit pas devenir 56 mmol/L après extraction, et une conversion d’unité doit préserver le sens clinique plutôt que simplement remplacer la ponctuation. Évaluez séparément les données d’entrée dans la langue d’origine et les résultats traduits ; tester uniquement des rapports de laboratoire en anglais traduits en 10 langues ne permet pas de détecter les erreurs dans les données d’entrée.
La négation et le type de résultat méritent des cas de test dédiés. Des expressions telles que non détecté, inférieur à la limite de quantification et ne peut être exclu indiquent des degrés de certitude différents. Notre guide qualitatif versus quantitatif explique cette distinction ; une grille d’évaluation bilingue devrait tester ces sens, y compris les symboles d’inégalité tels que inférieur à 0.1, plutôt que de récompenser uniquement la fluidité du texte.
La lisibilité ne garantit pas la compréhension. Une évaluation linguistique utile pourrait demander aux participants de repérer l’action requise et le degré d’incertitude après la lecture de 3 rapports courts, tout en notant si la traduction modifie le degré d’urgence ou les conseils concernant les médicaments. Il s’agit de tâches d’évaluation proposées, et non d’un seuil universel validé ; les langues disposant de moins de ressources peuvent nécessiter un examen supplémentaire, car la terminologie clinique disponible et la couverture de la formation varient.
L’intégration des API et les formats de rapport doivent préserver le sens clinique
La validation de l’intégration vérifie si l’identité du patient, les valeurs, les unités, les dates et les avertissements restent corrects d’un système à l’autre. Les sorties HTML, JSON et PDF devraient communiquer le même contenu clinique lorsque ces formats sont pris en charge. Le sens d’un résultat de sodium de 128 mmol/L ne doit pas changer parce qu’une sortie omet un avertissement ou qu’une autre tronque un champ.
Une connexion API fonctionnelle ne constitue pas une intégration clinique validée. Notre API B2B nécessite des vérifications propres au déploiement concernant le mappage, l’authentification, le traitement des réponses et le comportement selon les versions ; la compatibilité avec le DPI ou le SIL doit être démontrée pour l’interface réelle. Testez au moins 3 catégories de défaillance — unités manquantes, identifiants de patients discordants et réponses en double retardées — au lieu de vous contenter d’une seule requête de démonstration réussie.
Les valeurs dérivées nécessitent des données d’entrée explicites et la traçabilité de la formule. La natrémie corrigée, par exemple, dépend de la natrémie mesurée, de la glycémie et de la méthode de correction ; différents coefficients publiés peuvent produire des estimations différentes. Notre guide de correction de la natrémie en fonction de la glycémie fournit un cas clinique de test, mais les acheteurs doivent vérifier que la glycémie en mg/dL n’est jamais traitée comme étant en mmol/L et que tout calcul explicite ses hypothèses.
L’accord sur les formats doit porter sur le sens, pas seulement sur la mise en page. Dans un test hypothétique d’exportation de 300 rapports, le JSON peut conserver un indicateur critique tandis qu’un modèle PDF le masque sous un saut de page. Comparez les recommandations cliniques, l’incertitude, les unités et les horodatages dans les formats de sortie pris en charge ; assurez la traçabilité des valeurs brutes jusqu’à leur source et précisez si un champ manquant entraîne un rejet sûr ou une interprétation non prise en charge.
Des rapports rapides et une interface conviviale nécessitent tout de même des données probantes sur les facteurs humains
La rapidité et la facilité d’utilisation sont des avantages opérationnels, et non des preuves directes de la précision diagnostique. Notre fonctionnalité d’interprétation produit généralement une explication en environ 60 secondes, mais le déploiement clinique devrait mesurer le délai de bout en bout, les requêtes échouées et la charge de vérification. Le temps de traitement médian à lui seul ne permet pas de savoir si les résultats urgents parviennent à la bonne personne en toute sécurité.
La latence doit être présentée sous forme de distribution. Demandez la médiane, le 95e percentile et le taux d’expiration des délais dans des conditions réalistes d’utilisation simultanée, y compris avec des fichiers volumineux et des photos de mauvaise qualité. Une médiane hypothétique de 45 secondes avec un 95e percentile de 240 secondes décrit un service très différent d’un service qui termine systématiquement en près de 60 secondes ; aucun de ces chiffres ne prouve que le traitement commence plus tôt.
La présentation et l’escalade des profils biologiques urgents doivent être testées. Un résultat de potassium de 6.5 mmol/L peut indiquer une urgence médicale, bien que la qualité du prélèvement et le contexte clinique influent sur l’interprétation. Notre guide des situations urgentes liées aux électrolytes aide à concevoir des scénarios ; les patients ayant reçu une alerte biologique urgente doivent contacter rapidement le service qui les prend en charge plutôt que d’attendre une explication de l’application, en particulier s’ils présentent des symptômes.
Les tests sur les facteurs humains mesurent ce que les utilisateurs font avec le rapport. Pour les accès via le web, iOS, Android et une extension, les acheteurs devraient examiner au moins 3 tâches : trouver la valeur d’origine, reconnaître l’incertitude et déterminer la prochaine action appropriée. Consignez les actions incorrectes ainsi que le temps nécessaire pour terminer les tâches, car une interface soignée peut renforcer la confiance dans une recommandation non étayée et rendre plus difficile la détection du biais d’automatisation.
Les données probantes relatives à la sécurité et à la confidentialité doivent accompagner la validation clinique
L’évaluation de la confidentialité vérifie comment les informations sensibles de laboratoire sont recueillies, traitées, conservées, partagées et supprimées. Un traitement conforme au GDPR est une approche déclarée, et non un substitut à des preuves contractuelles et techniques. Pour Kantesti Ltd, société britannique n° 17090423, les acheteurs doivent établir la relation applicable entre responsable du traitement et sous-traitant, ainsi que les responsabilités de chacun, avant d’envoyer ne serait-ce qu’un seul rapport identifiable.
Les informations de santé exigent davantage que la suppression d’un nom. Un rapport peut contenir un code-barres, une date de naissance exacte, un numéro de dossier ou un détail narratif permettant d’identifier une personne lorsqu’il est associé à d’autres informations. Notre précautions à prendre pour préserver la confidentialité lors du téléversement expliquer la minimisation pratique ; un acheteur devrait évaluer séparément au moins 3 couches : le contenu des fichiers, les métadonnées des comptes et les journaux opérationnels.
Les affirmations en matière de sécurité doivent avoir un périmètre défini et une date de référence. Examiner les dispositifs de chiffrement, les contrôles d’accès, les listes de sous-traitants, les conditions de notification des incidents et les paramètres de conservation dans la documentation sur la confidentialité des données. Si un fournisseur mentionne un audit, demander quels services et quelle période de contrôle il couvre ; un rapport portant sur 1 composant d’infrastructure n’évalue pas automatiquement l’accès aux applications cliniques ni le traitement des données par le modèle.
Un déploiement international entraîne des obligations supplémentaires. Une utilisation dans les pays de 127+ ne signifie pas qu’un seul contrat ou fondement juridique couvre chaque juridiction, et l’alignement sur le GDPR n’implique ni l’applicabilité de HIPAA ni le respect de ses exigences. Pour les fonctionnalités familiales, tester les limites des autorisations au moyen de 2 comptes distincts, y compris le retrait des accès et la récupération des comptes ; la question de savoir si la suppression d’un rapport efface également les sauvegardes et les journaux nécessite une réponse explicite.
Le moteur d’IA : valider séparément les prédictions et les recommandations
Un moteur d’IA nécessite une validation propre à chaque revendication concernant l’interprétation des schémas, la prédiction des risques futurs et les recommandations personnalisées. Il s’agit de tâches différentes, même lorsqu’elles sont générées dans 1 rapport. L’architecture d’apprentissage profond et l’analyse multiparamétrique décrivent le fonctionnement d’un système ; elles ne prouvent pas que ses estimations de probabilité, ses suggestions diagnostiques ou ses conseils alimentaires sont cliniquement fiables.
L’interprétation multiparamétrique devrait préserver les explications concurrentes. Dans un rapport hypothétique indiquant une ferritine de 40 ng/mL et une CRP de 20 mg/L, la ferritine seule ne permet pas de trancher la question de la disponibilité du fer, car son taux peut augmenter en cas de réaction de phase aiguë. Les acheteurs qui évaluent le réseau neuronal de Kantesti devraient utiliser des cas de ce type, sensibles au contexte, tandis que le explication technologique reste distinct des preuves qu’une conclusion clinique précise est correcte.
La prédiction des risques nécessite un résultat et un horizon temporel définis. Une probabilité de 20% est ininterprétable sans préciser ce qui peut se produire, chez qui et sur quelle période — par exemple, une hospitalisation dans les 30 jours plutôt que l’apparition d’une maladie dans les 5 ans. TRIPOD+AI recommande une communication transparente des études sur les modèles prédictifs (Collins et al., 2024) ; le calibrage et la validation externe sont importants, y compris pour l’ analyse des tendances liées aux médicaments.
Les conseils personnalisés entraînent une obligation de sécurité distincte. Une recommandation nutritionnelle peut être inappropriée lorsque la fonction rénale, les médicaments ou le contexte de grossesse ne sont pas connus ; Family Health Risk nécessite également une gestion claire des antécédents incertains ou autodéclarés. Notre guide de sécurité nutritionnelle pour les reins propose des scénarios de test pertinents, mais accepter un plan de repas en 3 éléments ne prouve pas qu’il améliore les résultats ni qu’il remplace sans risque une évaluation diététique individualisée.
Comment fonctionne l’interprétation prise de sang par l’IA : liste de vérification de validation pour les acheteurs
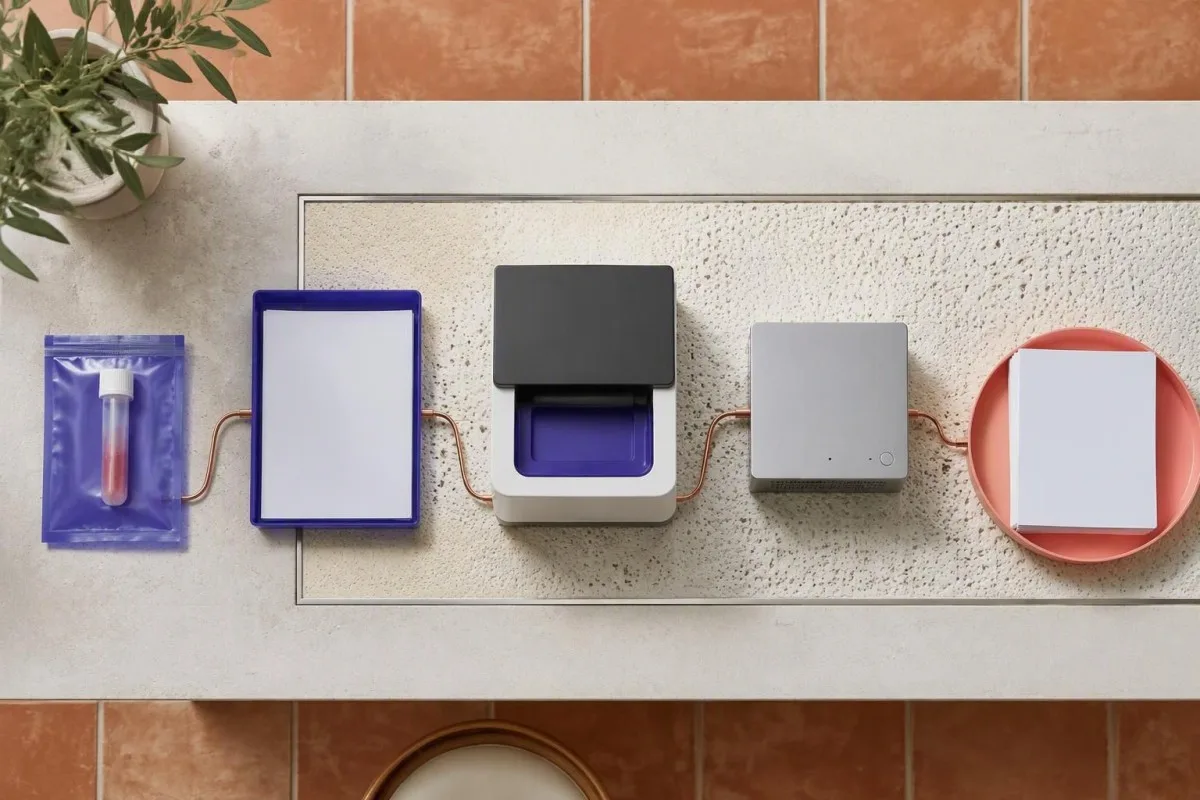
Un acheteur devrait tester l’ensemble de la séquence : capture des sources, normalisation, interprétation contextuelle, génération du rapport et examen clinique. Évaluer chaque étape séparément avant de tester le système dans son ensemble. Un plan d’acceptation en 5 étapes facilite la détermination de l’origine d’un résultat dangereux : lecture erronée d’une valeur, hypothèse incorrecte ou recommandation inappropriée.
Commencer par définir l’usage prévu et figer la version évaluée. L’étape 1 consiste à établir un inventaire écrit des revendications et des risques ; l’étape 2, à constituer un jeu de données représentatif verrouillé, assorti de critères d’admissibilité et de références prédéfinis. La capture de PDF ou de photos devrait ensuite être testée avec des mises en page modifiées, différentes conventions décimales et des champs illisibles ; consigner les refus plutôt que de les exclure discrètement du dénominateur final.
Ensuite, tester le contexte et les hypothèses longitudinales. L’étape 3 vérifie les unités, les intervalles de référence et les métadonnées ; l’étape 4 évalue les interprétations et les recommandations selon des catégories de gravité cliniquement pertinentes. Notre guide sur les changements entre les visites au laboratoire permet de poser une question utile : une variation de la créatinine de 80 à 100 µmol/L nécessite de tenir compte du délai, de la variabilité du dosage et du patient, et ne signifie pas automatiquement une détérioration.
Terminez par une décision de déploiement, et non par un slogan sur la précision. L’étape 5 évalue l’utilisation prospective locale et la gestion des défaillances au regard de critères convenus avant l’examen des résultats, notamment les limites d’incertitude et les modalités d’escalade. Demandez un dossier contenant le flux de la cohorte, la version du modèle, la grille d’évaluation complète, les tableaux par sous-groupe, des exemples de résultats défavorables et les règles de contrôle des modifications ; aucun pourcentage universel ne peut remplacer des seuils d’acceptation adaptés aux conséquences des erreurs.
Rapports d’exemple et témoignages : distinguer l’illustration des données probantes
Un exemple de rapport illustre la présentation et le raisonnement, tandis qu’un témoignage décrit une impression individuelle. Ni l’un ni l’autre n’établit la précision au niveau du patient ni le bénéfice clinique. Considérons un adulte de 52 ans, clairement hypothétique, dont la créatinine est de 118 µmol/L, le DFGe déclaré de 58 mL/min/1,73 m² et dont aucun résultat antérieur n’est disponible : l’explication prudente doit préserver l’incertitude.
Un seul DFGe réduit ne suffit pas à établir une maladie rénale chronique. KDIGO définit la maladie rénale chronique par la présence d’anomalies de la structure ou de la fonction rénales pendant au moins 3 mois ; un DFGe inférieur à 60 mL/min/1,73 m² nécessite une évaluation de la chronicité et du contexte (KDIGO CKD Work Group, 2024). Dans cet exemple hypothétique, un rapport devrait suggérer une évaluation par un clinicien et un suivi approprié, et non diagnostiquer une atteinte rénale permanente à partir d’un seul résultat.
Les estimations fondées sur la créatinine peuvent être moins informatives en cas de composition corporelle inhabituelle. Si la personne hypothétique est très musclée ou a récemment modifié ses suppléments, l’interprétation devrait tenir compte de ces facteurs plutôt que d’écarter le résultat. Notre discussion sur la créatinine chez les adultes musclés apporte un éclairage ; KDIGO préconise, lorsqu’elle est disponible, l’estimation combinant créatinine et cystatine C pour l’évaluation appropriée de la maladie rénale chronique chez l’adulte, plutôt que de supposer que l’estimation initiale est définitive.
Les démonstrations devraient inclure des données difficiles et des résultats défavorables. Ajoutez un résultat hypothétique distinct de potassium à 6.0 mmol/L, accompagné d’un signalement de problème lié à l’échantillon, en utilisant nos limites des résultats liées à l’hémolyse pour expliquer pourquoi il faut tenir compte à la fois de la confirmation et de l’urgence. Pour Kantesti, une évaluation utile consiste à comparer à l’aveugle des rapports complets ; les témoignages de professionnels, s’ils sont présentés avec leur consentement, restent des retours fondés sur l’expérience et ne remplacent pas de tels tests.
Accueillir l’avenir du diagnostic : une adoption fondée sur les données probantes
Adoptez l’interprétation par IA uniquement pour les usages étayés par des preuves, sous supervision locale et avec une procédure documentée de réponse aux erreurs. Kantesti est un outil d’analyse des analyses sanguines reposant sur l’IA ; notre éventail de fonctionnalités devrait être évalué selon les mêmes normes d’approvisionnement décrites ici. Commencer par 1 cas d’utilisation limité est plus sûr que de supposer que les preuves s’appliquent à tous les patients et à toutes les recommandations.
Une introduction progressive devrait distinguer la faisabilité de l’efficacité. Une évaluation en mode silencieux portant hypothétiquement sur 100 rapports peut révéler des problèmes d’intégration et des défauts de formulation fréquents sans exposer les patients à des recommandations non vérifiées, mais elle ne devrait guère permettre d’établir un faible taux d’erreurs graves rares. Une évaluation prospective plus vaste nécessite une justification de la taille de l’échantillon et des critères de jugement adaptés à l’allégation réelle, notamment le suivi inutile ainsi que les problèmes non détectés.
Les modifications logicielles peuvent altérer les performances mesurées précédemment. Un nouveau modèle, une nouvelle invite, une nouvelle base de données d’intervalles de référence ou un nouveau modèle de rapport peut modifier les résultats même si le nom du produit reste le même ; consignez les 4 catégories dans l’historique de déploiement. Surveillez la gravité des erreurs, les abstentions, les écarts entre sous-groupes et les dérogations des utilisateurs, et définissez dans quels cas une modification déclenche des tests de régression ciblés, une nouvelle évaluation locale ou la suspension d’une fonction particulière.
La décision d’adoption devrait s’appuyer sur une analyse écrite des lacunes en matière de preuves. Déterminez ce qui est établi de façon indépendante, ce qui n’est étayé que par des tests techniques et ce qui n’a pas encore été évalué ; désignez ensuite un responsable pour chaque risque non résolu. Notre canal de contact pour l’acheteur du secteur de la santé est l’endroit approprié pour demander une documentation propre au périmètre d’utilisation — privilégiez une affirmation plus restreinte et étayée plutôt qu’un titre accrocheur à 99% dont le dénominateur n’est pas clair.
Publications de recherche : distinguer les guides pédagogiques des études de validation
Les 2 références DOI de dépôt ci-dessous identifient des guides pédagogiques, et non des études de validation clinique de logiciels d’interprétation par IA. Un DOI fournit un identifiant permanent ; il n’établit ni l’évaluation par les pairs, ni le recrutement de patients, ni une évaluation indépendante, ni l’efficacité clinique. Les acheteurs devraient classer chaque publication citée selon la question à laquelle elle peut réellement répondre.
Les guides pédagogiques peuvent aider à élaborer une grille de validation sans valider eux-mêmes le produit. Notre guide du complément et des ANA peut éclairer les cas où 2 mesures du complément et le contexte des anticorps nécessitent une explication minutieuse. La concordance avec un guide n’équivaut pas à une concordance avec des résultats de patients évalués de manière indépendante, en particulier lorsque le guide et le logiciel évalué proviennent de la même organisation.
Les guides sur le calendrier diagnostique abordent un autre mode de défaillance utile. Notre guide de dépistage du Nipah traite d’un contexte diagnostique spécialisé ; il ne faut pas l’utiliser pour laisser entendre que l’interprétation courante des analyses de laboratoire permet d’identifier un virus particulier. Si un acheteur inclut ne serait-ce qu’une seule allégation relative à un agent pathogène à conséquences graves dans l’utilisation prévue, cette allégation nécessite ses propres preuves diagnostiques pertinentes et des limites d’escalade appropriées.
Les normes de présentation des études facilitent l’évaluation plutôt que de certifier les performances. STARD 2015 comprend 30 éléments de présentation pour les études sur la précision diagnostique, tandis que TRIPOD+AI porte sur la présentation des modèles prédictifs ; aucune de ces listes de contrôle ne constitue une approbation clinique du logiciel. Les références ci-dessous distinguent ces sources méthodologiques et la directive KDIGO 2024 des 2 entrées DOI pédagogiques, afin que les lecteurs puissent différencier les recommandations cliniques, les recommandations de présentation et les données probantes propres au produit.
Foire aux questions
Qu’est-ce que la validation clinique d’un logiciel d’IA pour les analyses de sang ?
La validation clinique évalue si une version donnée du logiciel d’analyse sanguine par IA produit des résultats suffisamment précis et sûrs pour les patients et les décisions visés. Elle doit distinguer au moins 3 tâches : lire le rapport source, interpréter la signification clinique et recommander une action. Les données probantes doivent décrire la norme de référence, la taille de l’échantillon au niveau des patients, les tests indépendants et la gestion des défaillances. Une explication techniquement correcte ne prouve pas à elle seule une amélioration des résultats pour les patients.
La précision de 99% est-elle suffisante pour faire confiance à un analyseur de tests sanguins basé sur l’IA ?
0 Une affirmation de précision de 99% ne permet pas d’établir la sécurité sans en connaître le dénominateur, la définition de la tâche et la gravité des erreurs. Dans un groupe hypothétique où seuls 1% présentent une affection ciblée, un logiciel qui classe tout le monde comme négatif atteint une précision de 99% tout en ne détectant aucun des patients atteints. Les acheteurs devraient demander la sensibilité, la spécificité, les erreurs dans les rapports au niveau du patient et le nombre d’entrées rejetées. Les recommandations rares mais dangereuses ne doivent pas disparaître dans une moyenne dominée par des énoncés faciles.
Quelle est la différence entre un benchmark synthétique et une validation clinique ?
Un benchmark synthétique évalue un logiciel sur des cas construits, tandis que la validation clinique exige des preuves adaptées à la population de patients visée et à l’allégation clinique. Même 100 000 cas synthétiques ne peuvent pas établir la prévalence en conditions réelles, le bénéfice clinique ou les performances face à chaque problème lié à un historique manquant ou à la qualité des échantillons. Les tests synthétiques peuvent aider à identifier les défaillances techniques et à effectuer des vérifications de régression. Ils doivent compléter, et non remplacer, une évaluation externe représentative et prospective.
De combien de tests indépendants l’IA en santé a-t-elle besoin ?
L’IA en santé doit faire l’objet de tests indépendants proportionnés aux conséquences d’un résultat incorrect, et non d’un nombre minimum universel de rapports. L’observation de 0 échec dans 100 cas indépendants laisse une borne supérieure approximative de 3% pour le taux d’échec, selon la règle de trois. Les acheteurs devraient demander des données de test protégées, une version figée du modèle et la divulgation des liens avec les évaluateurs. Les affirmations concernant de rares erreurs graves nécessitent généralement davantage de preuves qu’un petit projet pilote d’utilisabilité ou de faisabilité ne peut en fournir.
La prise en charge de 100 langues signifie-t-elle une précision égale dans chaque langue ?
La prise en charge de 100 langues ne garantit pas une précision clinique équivalente dans chacune d’elles. L’évaluation propre à chaque langue doit porter sur l’extraction des données d’entrée, les conventions décimales, les unités, la négation et le sens des recommandations. Par exemple, une glycémie indiquée comme 5,6 mmol/L ne doit pas être interprétée comme 56 mmol/L. Les acheteurs devraient demander des dénominateurs propres à chaque langue et préciser quelles langues n’ont pas fait l’objet d’un examen clinique.
L’IA peut-elle diagnostiquer une maladie rénale chronique à partir d’un seul résultat d’eGFR bas ?
Un seul résultat d’eGFR inférieur à 60 mL/min/1.73 m² ne suffit pas, à lui seul, à établir un diagnostic de maladie rénale chronique. Les recommandations KDIGO 2024 définissent la maladie rénale chronique par la présence d’anomalies rénales depuis au moins 3 mois, en tenant compte de leur chronicité et du contexte clinique. Les changements aigus, la composition corporelle et d’autres facteurs peuvent influer sur l’interprétation. Les logiciels d’IA devraient expliquer cette incertitude et favoriser le suivi par un clinicien plutôt que de qualifier une estimation ponctuellement réduite de maladie permanente.
Faites-vous expliquer vos résultats prise de sang
Téléversez votre compte rendu d’analyses et l’IA de Kantesti explique chaque biomarqueur en langage clair en quelques secondes. Déjà utilisé par plus de 2 millions de personnes dans le monde.
Références
- Klein, T., Mitchell, S. et Weber, H. (2025). Guide sur le test sanguin C3 C4 du complément et le titre ANA. Recherche médicale par IA de Kantesti. DOI
- Klein, T., Mitchell, S. et Weber, H. (2025). Test sanguin pour le virus Nipah : guide de détection précoce et de diagnostic 2026. Recherche médicale par IA de Kantesti. DOI
- Bossuyt PM et al. (2015). STARD 2015 : liste actualisée des éléments essentiels à présenter dans les études sur la précision diagnostique. BMJ. DOI PubMed
- Collins GS et al. (2024). Déclaration TRIPOD+AI : recommandations actualisées pour la présentation des modèles de prédiction clinique utilisant des méthodes de régression ou d’apprentissage automatique. BMJ. DOI
- Groupe de travail CKD de Kidney Disease: Improving Global Outcomes (KDIGO) (2024). Recommandation de pratique clinique KDIGO 2024 pour l’évaluation et la prise en charge de la maladie rénale chronique. Kidney International. DOI
- 2 millions et plusTests analysés
- 127+Des pays
- 100+Langues
À propos de l’équipe médicale


Signaux de confiance E-E-A-T
Expérience
Revue clinique guidée par un médecin des flux d’interprétation des analyses.
Compétence
Orientation en médecine de laboratoire sur la façon dont les biomarqueurs se comportent dans un contexte clinique.
autorité
Révisé médicalement par le Dr Thomas Klein, avec la contribution de la Dre Sarah Mitchell et du Pr Dr Hans Weber.
Fiabilité
Interprétation fondée sur des preuves, avec des parcours de suivi clairs pour réduire l’alarme.
Avertissement médical
Cet article est fourni à des fins éducatives uniquement et ne constitue pas un avis médical. Consultez toujours un professionnel de santé qualifié pour les décisions de diagnostic et de traitement.
Publié · Mis à jour · Contacter l’équipe éditoriale
Publié par Kantesti Ltd, immatriculée en Angleterre et au pays de Galles, sous le numéro d’entreprise. 17090423, Londres, Royaume-Uni.
