Intégrez l’interprétation de l’IA comme une étape supervisée entre les résultats de laboratoire vérifiés et les communications approuvées par le clinicien. Commencez par un flux de travail, validez les données locales, préservez les alertes de résultats critiques et mesurez la sécurité parallèlement au temps gagné.

Points clés à retenir
- Le périmètre du déploiement doit commencer par un flux de travail clinique clairement défini, et non par une interprétation sans restriction dans toutes les spécialités.
- La compatibilité des résultats nécessite la valeur d’origine, l’unité, l’intervalle de référence, les détails de l’échantillon et l’heure du prélèvement ; la conversion de la créatinine utilise 88,4 µmol/L par 1 mg/dL.
- La validation locale doit distinguer les erreurs d’extraction des erreurs d’interprétation ; un projet pilote proposé de 300 rapports constitue un point de départ, et non une exigence de preuve universelle.
- Validation par le clinicien devrait couvrir 100% des interprétations de l’IA destinées aux patients pendant un premier projet pilote supervisé.
- Résultats critiques doit conserver la procédure d’escalade existante du laboratoire ; un taux de potassium de 6.5 mmol/L ou plus nécessite généralement une évaluation clinique urgente.
- Examen de la confidentialité devrait définir les responsabilités du responsable du traitement et du sous-traitant, les règles de conservation, les transferts internationaux et les contrôles d’accès avant le premier téléversement de données identifiables.
- Indicateurs du projet pilote devraient inclure le temps de vérification, les erreurs cliniquement significatives, les escalades omises, les suivis inutiles et les performances par sous-groupe — et pas seulement la vitesse de production des résultats.
- Modifications du modèle nécessitent un suivi des versions et une revalidation ciblée ; 0 erreur observée ne permet pas d’établir qu’un système ne commet aucune erreur.
Ce que l’intégration de l’IA aux analyses sanguines doit faire dans une clinique
Intégration de l’IA aux analyses sanguines devrait ajouter une interprétation supervisée aux résultats de laboratoire vérifiés — et non remplacer la mesure, le diagnostic clinique ou la notification des résultats critiques. Commencez par 1 processus défini, vérifiez la compatibilité des données, validez localement, exigez la validation par un clinicien, effectuez un examen de la confidentialité et définissez les critères de réussite du projet pilote avant de l’étendre.
Kantesti est un Analyseur de test sanguin AI développé par Kantesti Ltd, société britannique n° 17090423, qui interprète les rapports de laboratoire téléversés plutôt que d’analyser les échantillons. Notre contexte organisationnel aide les équipes chargées des achats à identifier le fournisseur ; l’immatriculation de la société ne prouve ni l’autorisation en tant que dispositif médical ni l’efficacité clinique.
La mesure et l’interprétation sont 2 tâches différentes. Un laboratoire établit la concentration de potassium indiquée à l’aide de sa méthode analytique ; un système d’interprétation explique ce résultat en fonction du contexte disponible, et aucun de ces processus ne garantit qu’une erreur d’échantillon ou l’absence d’antécédents médicamenteux sera détectée.
La précision diagnostique doit être démontrée pour une tâche, une population et un comparateur définis — elle ne peut être déduite d’explications éloquentes. Distinguez 3 avantages potentiels dans le dossier commercial : moins d’erreurs de transcription, des explications plus claires et de meilleures décisions cliniques ; chacun nécessite une évaluation différente, et une amélioration de l’un ne prouve pas une amélioration des autres.
Rédigez une déclaration d’utilisation prévue d’une page avant de mettre en place des interfaces : qui reçoit le résultat, quels bilans sont pris en charge, quelles décisions il peut éclairer et dans quels cas le système doit s’abstenir. Excluez du périmètre initial le triage des urgences, la prescription autonome et les spécialités non prises en charge, à moins que ces usages ne disposent de leurs propres données probantes et mécanismes de gouvernance.
Cartographier le flux de travail avant de connecter l’API
Cartographie du flux de travail permet de déterminer où l’interprétation par l’IA intervient dans le parcours existant d’examen des résultats de la clinique et qui reste responsable à chaque étape. Cartographiez au moins 6 étapes : prescription, prélèvement, vérification par le laboratoire, transfert des données, examen par le clinicien et communication au patient ; l’escalade des résultats critiques doit fonctionner indépendamment de l’IA.
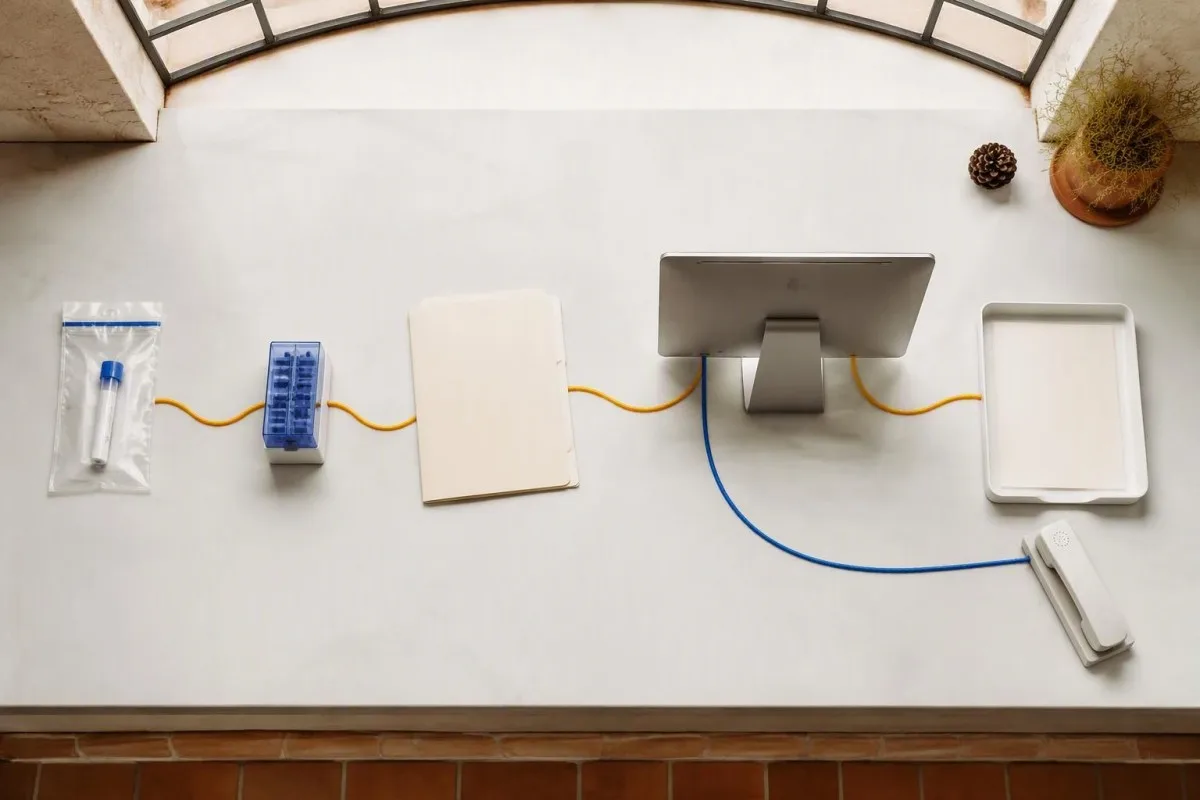
Pour les cliniques et les hôpitaux, la durée qu’il est souvent utile de cibler est celle entre les résultats vérifiés et l’examen documenté — et non le délai d’analyse. Mesurez séparément ces 2 intervalles, car une explication plus rapide ne peut compenser une boîte de réception sans clinicien de garde pendant les congés ou les week-ends.
Les laboratoires doivent déterminer séparément si les commentaires de l’IA feront partie d’un rapport autorisé ou resteront un brouillon externe. Conservez 2 dossiers distincts : le résultat vérifié du laboratoire et l’interprétation qui lui est associée ; une révision ultérieure de l’IA ne doit jamais modifier silencieusement la mesure d’origine ni l’intervalle de référence.
Les professionnels de santé n’en tirent avantage que si le résultat parvient à la bonne file de traitement sans créer de tâches en double. Testez explicitement 3 situations : un résultat de laboratoire corrigé, un rapport reçu après la sortie du patient et un clinicien qui change de cabinet ; notre flux de partage de résultats sécurisé explique pourquoi l’identité du destinataire est importante.
Les équipes d’assurance exigent une limite distincte : une explication clinique ne constitue pas une décision validée de souscription ou de règlement de sinistre. Maintenez une interdiction explicite de toute décision défavorable non examinée par un professionnel et fondée sur des interprétations de l’IA, et évaluez tout accès proposé aux assureurs séparément de la prestation des soins, notamment quant à sa finalité légale et aux restrictions concernant les informations de santé sensibles.
Faire correspondre les fonctionnalités d’interprétation aux exigences cliniques
Sélection des fonctionnalités devrait suivre le flux de travail clinique plutôt que la longueur de la liste des fonctionnalités d’un produit. Notre plateforme propose le téléversement de PDF et de photos, une interprétation généralement réalisée en environ 60 secondes, l’analyse des tendances, des plans nutritionnels, des fonctionnalités de gestion des risques de santé familiaux et une API B2B ; leur disponibilité ne garantit pas leur adéquation à tous les usages cliniques.
Kantesti indique plus de 2 millions d'utilisateurs, un accès dans Plus de 127 pays et une prise en charge de 100+ langues. Ces chiffres de portée communiqués par l’entreprise décrivent l’accessibilité, et non les performances cliniques ; les cliniques doivent tout de même tester les formats de rapport qu’elles utilisent réellement, les populations de patients et les consignes de sécurité traduites.
Notre explication de la technologie IA fournit des éléments de contexte pour les discussions techniques, mais les équipes chargées des achats devraient demander la spécification d’interface à jour plutôt que de supposer une architecture particulière de réseau neuronal ou une version d’API précise. Confirmez au moins 4 éléments : la structure des requêtes, le schéma des réponses, la politique de gestion des versions et le traitement explicite des entrées non prises en charge.
L’interprétation destinée aux consommateurs, en environ 60 secondes , ne constitue pas une garantie contractuelle de délai de réponse B2B. Renseignez-vous sur les requêtes simultanées, les limites de débit, le comportement en cas de délai d’attente dépassé et l’assistance technique ; les applications natives iOS et Android, une extension Chrome et les téléchargements signalés par 100K+ ne fournissent pas automatiquement un mode d’intégration clinique approuvé.
L’analyse des tendances est plus utile lorsqu’elle conserve les dates de prélèvement, les différences entre les méthodes de dosage et les changements de médicaments, au lieu de simplement relier les valeurs par une ligne. Pour 2 résultats séquentiels, vérifiez que l’analyte et les unités concordent avant de les comparer ; notre guide des tendances de sécurité des médicaments explique le contexte supplémentaire nécessaire.
Vérifier les unités, les métadonnées des échantillons et la compatibilité des systèmes
Compatibilité des données exige davantage que le transfert d’un nombre dans un champ JSON. Préservez au moins 8 éléments lorsqu’ils sont disponibles : identifiant du patient, analyte, valeur, unité, intervalle de référence du laboratoire, type d’échantillon, heure du prélèvement et statut du résultat ; les champs manquants ou ambigus devraient déclencher une vérification plutôt que des suppositions implicites.
Une créatinine de 1 mg/dL équivaut à environ 88.4 µmol/L, et une glycémie de 1 mmol/L équivaut à environ 18.0 mg/dL. La conversion doit être propre à chaque analyte ; appliquer le facteur de conversion du glucose à la créatinine provoque une erreur cliniquement importante, même si le nombre obtenu peut sembler plausible.
Les ressources FHIR telles que DiagnosticReport et Observation, les messages de laboratoire HL7 v2, les codes d’analyte LOINC et les unités UCUM peuvent favoriser l’interopérabilité, mais une API n’implique pas la prise en charge native des 4 normes. Vérifiez quelles transformations votre couche d’intégration effectue, notamment pour les virgules décimales, les symboles d’inégalité, les résultats corrigés et les messages en double.
Un taux de plaquettes de 150 × 10⁹/L équivaut à 150,000/µL; une albuminémie de 4.0 g/dL équivaut à 40 g/L. Ne convertissez pas un résultat indiqué comme inférieur à la limite de détection en une mesure exacte et distinguez les résultats réactifs, détectés et numériques à l’aide de notre guide qualitatif et quantitatif des résultats.
Les avertissements préanalytiques doivent accompagner le résultat, car la qualité de l’échantillon modifie son interprétation. Dans un rapport hypothétique où le potassium 6.2 mmol/L et un indicateur d’hémolyse élevé, le système doit conserver les deux observations et demander une évaluation clinique ; notre explication de l’interférence due à l’hémolyse montre pourquoi une anomalie apparente ne peut pas être interprétée isolément.
Valider le raisonnement clinique, et pas seulement les indicateurs de référence
L’interprétation clinique distingue les intervalles de référence du laboratoire des critères diagnostiques, des objectifs thérapeutiques et des seuils d’intervention urgente. Par exemple, une HbA1c de 6,5% ou 48 mmol/mol atteint un seuil diagnostique du diabète, mais une confirmation est généralement requise en l’absence d’hyperglycémie sans équivoque ; un simple indicateur de référence ne peut pas établir le diagnostic.
Les recommandations de l’American Diabetes Association en matière de 2024 diagnostic identifient une glycémie plasmatique à jeun de 126 mg/dL ou 7.0 mmol/L et une HbA1c de 6.5% comme seuils diagnostiques (American Diabetes Association Professional Practice Committee, 2024). Élaborez des cas de validation qui distinguent les mesures à jeun des mesures aléatoires et traitent explicitement les résultats discordants au lieu de faire la moyenne d’éléments diagnostiques incompatibles.
Kantesti est un plateforme d’interprétation prise de sang AI dont l’utilisation clinique nécessite un contexte dépassant un seul chiffre anormal. Un eGFR inférieur à 60 mL/min/1,73 m² doit persister pendant au moins 3 mois, ou coexister avec d’autres éléments probants répondant aux critères de lésion rénale chronique, pour étayer un diagnostic de MRC ; KDIGO reconnaît également un ACR urinaire persistant de 30 mg/g ou plus comme marqueur de lésion rénale (KDIGO CKD Work Group, 2024).
La masse musculaire peut influer sur l’eGFR calculé à partir de la créatinine ; un athlète de force hypothétique présentant une créatinine de 1,4 mg/dL nécessite donc une évaluation différente de celle d’une personne âgée fragile présentant le même résultat. Notre guide sur la créatinine chez les adultes musclés explique ce raisonnement ; les recommandations KDIGO 2024 préconisent l’estimation combinée créatinine–cystatine C lorsqu’une plus grande précision est nécessaire et que cette méthode est disponible.
L’interprétation de l’HbA1c peut devenir peu fiable après une transfusion ou lorsque le renouvellement des globules rouges est modifié, même lorsque le résultat affiché est de 6.5%. Incluez ce contexte dans le jeu de tests plutôt que de récompenser une simple recherche correcte du seuil ; notre explication de l’HbA1c après transfusion illustre pourquoi le motif d’une exception importe autant que la règle.
Effectuer une validation locale avant le déploiement auprès des patients
La validation locale teste le système complet avec les formats de votre laboratoire, votre population clinique et le flux de travail prévu. Une première conception pourrait inclure 300 rapports, examinés indépendamment par des cliniciens qualifiés, avec des évaluations distinctes de l’extraction, de l’interprétation clinique et de l’escalade ; la taille d’échantillon nécessaire dépend du préjudice mesuré.
Un ensemble de validation enrichi devrait inclure des résultats normaux courants, des résultats limites, des anomalies critiques et des documents difficiles, et pas seulement des PDF propres. Pour une hypothétique évaluation de 300 rapports , prédéfinissez des catégories telles que les photos de mauvaise qualité, les rapports dans une langue autre que l’anglais, les résultats modifiés et les analyses peu familières ; ne présentez pas cet échantillon illustratif comme une étude achevée.
Évaluez l’extraction numérique séparément du jugement clinique qu’elle étaye. Si 300 rapports contiennent 20 résultats numériques chacun, cela crée 6 000 possibilités de vérifier les paires valeur–unité, mais ces observations sont corrélées au sein des rapports : il ne s’agit pas de 6 000 patients indépendants ; une valeur de potassium erronée peut avoir plus d’importance que des dizaines de différences de mise en forme sans conséquence.
Un intervalle de référence central de 95% laisse environ 5% des résultats de la population de référence en dehors de ses limites. Selon l’hypothèse simplificatrice de 20 tests indépendants, la probabilité d’au moins un signalement est d’environ 64%; notre Une explication des résultats hors plage aide les examinateurs à éviter de considérer chaque signalement comme une maladie.
Zéro erreur parmi 100 cas de tests critiques laisse tout de même une limite supérieure approximative de confiance de 95% de 3% pour le taux d’erreur selon des hypothèses binomiales simples. Comparez l’examen par des cliniciens seuls à celui effectué par des cliniciens avec l’IA, faites appel à des évaluateurs indépendants lorsque cela est possible et utilisez notre informations de validation clinique de Kantesti comme documentation de référence sur le fournisseur, et non comme substitut à votre propre évaluation de la sécurité.
Maintenir l’approbation du clinicien et les alertes critiques indépendantes
Validation par le clinicien devrait approuver chaque interprétation destinée aux patients pendant un pilote supervisé initial, tandis que la notification des résultats critiques du laboratoire se poursuit sans changement. Une kaliémie de 6,5 mmol/L ou plus justifie généralement une évaluation clinique urgente ; un problème d’échantillon suspecté ne doit pas servir de raison pour reporter l’évaluation lorsqu’une hyperkaliémie dangereuse est possible.
Un enregistrement de validation doit identifier au moins 4 éléments: le clinicien approbateur, le rapport source, la version du modèle et l’heure de validation. Consignez les modifications importantes et les recommandations rejetées sous forme d’événements structurés ; une case à cocher sans accès au résultat original ne fournit pas de piste d’audit utile sur le plan clinique.
Les seuils critiques doivent respecter la politique du laboratoire local et le contexte clinique, plutôt qu’une liste universelle établie par l’IA. Testez au moins 3 scénarios de défaillance— délai d’expiration de l’IA, panne de l’interface et absence du clinicien — et confirmez qu’aucun ne bloque le parcours d’escalade existant ; notre guide des profils électrolytiques urgents fournit un contexte clinique.
Un TCA ou un temps de prothrombine normal n’exclut pas toutes les affections hémorragiques, et un TCA isolément prolongé n’établit pas un risque hémorragique. Incluez au moins 2 cas de mise à l’épreuve impliquant une exposition à un anticoagulant ou des résultats de dépistage faussement rassurants ; notre limites des tests de coagulation explique pourquoi les formulations rassurantes doivent également être examinées avec attention.
Les résultats de surveillance thérapeutique nécessitent des mesures de protection propres à chaque spécialité. La 2020 recommandation de consensus préconise une AUC/MIC de la vancomycine de 400–600 en cas d’infections graves à SARM lorsque la CMI est supposée être de 1 mg/L (Rybak et al., 2020) ; une concentration isolée ne permet pas d’établir cette exposition sans le contexte de dosage, de prélèvement et de modélisation.
Effectuer d’abord l’examen de la confidentialité, de la sécurité et de la réglementation
Examen de la confidentialité doit établir la base juridique, les rôles en matière de données, les contrôles d’accès, les modalités de conservation et de transfert avant le premier téléversement de données cliniques identifiables. Utilisez 1 cartographie documentée des flux de données couvrant la clinique, le fournisseur d’intégration, le service d’IA et les sous-traitants ultérieurs ; un traitement conforme au GDPR est une approche de gouvernance, et non une conformité automatique pour chaque déploiement.
Kantesti décrit notre traitement des données comme axé sur la protection de la vie privée et conforme au GDPR. Consultez notre les informations sur la confidentialité et les données, puis obtenez des accords propres au déploiement couvrant au moins 5 domaines: les instructions de traitement, les sous-traitants, la conservation, la suppression et les transferts internationaux ; les politiques publiques à elles seules ne définissent pas les conditions d’un contrat clinique.
Supprimer le nom d’un patient ne revient pas à anonymiser un rapport. Vérifiez au moins 6 identifiants possibles: date de naissance, adresse, numéro de dossier, code QR, nom de fichier et métadonnées de l’image ; les données de santé pseudonymisées restent généralement des données personnelles lorsqu’une personne peut encore être identifiée.
Appliquez des contrôles d’accès basés sur les rôles, l’authentification multifacteur lorsqu’elle est prise en charge et séparez le développement de la production. Établissez 2 politiques distinctes pour les dossiers cliniques et les fichiers temporaires de traitement par l’IA, car la suppression d’une copie chez un fournisseur n’autorise pas la suppression d’un dossier que la clinique est légalement tenue de conserver ; évaluez si le traitement proposé nécessite une analyse d’impact relative à la protection des données.
Le statut réglementaire dépend de la destination prévue du logiciel et de la juridiction, et non du fait qu’un clinicien signe le résultat. Vérifiez les exigences relatives aux dispositifs médicaux, les obligations en matière de sécurité clinique au Royaume-Uni, le cas échéant, et les justificatifs liés aux achats ; la participation à 4 programmes ou partenariats technologiques—Microsoft FoundersHub, NVIDIA Inception, Google Cloud et Cloudflare—ne constitue pas une autorisation médicale, une conformité à HIPAA ni une preuve d’efficacité clinique.
Adapter la communication avec les patients sans perdre le sens clinique
Les explications destinées aux patients doivent préserver le résultat original, expliquer l’incertitude et indiquer la prochaine étape approuvée par un clinicien dans la langue de préférence du patient. Pour un service prenant en charge 100+ langues, validez les langues réellement utilisées par votre clinique ; les conseils d’urgence traduits et les unités numériques doivent faire l’objet d’une vérification distincte de la lisibilité générale.
Une explication utile distingue 3 messages: ce qui a été mesuré, ce que le résultat peut signifier et ce qui se passe ensuite. Si la ferritine est 12 ng/mL, ne réduisez pas la réponse à une liste de conseils alimentaires génériques ; les symptômes, les pertes menstruelles, la grossesse, l’inflammation et le plan diagnostique du clinicien influent sur les conseils appropriés.
Les résultats pédiatriques et ceux liés à la grossesse nécessitent une interprétation propre à la population concernée, et non un tableau de référence pour adultes traduit. Considérez-les comme au moins 2 groupes de validation distincts, avec exclusion lorsque les preuves à l’appui sont insuffisantes ; notre guide de sécurité sur l’interprétation par l’IA des résultats des enfants explique pourquoi l’âge peut modifier à la fois les intervalles de référence et le degré d’urgence.
L’accès familial doit distinguer la commodité au sein du foyer de l’autorisation à consulter des informations de santé. Établissez 1 dossier d’autorisation par personne et par lien de parenté, avec des règles adaptées à l’âge et une révocation ; notre guide sur le consentement multigénérationnel explique pourquoi un compte partagé ne devrait pas impliquer un accès partagé à chaque résultat.
Les plans nutritionnels et les fonctionnalités Family Health Risk nécessitent leurs propres limites : ni un profil biologique ni les antécédents familiaux n’établissent un diagnostic génétique. Testez au moins 3 formats de communication— texte en langage clair, contenu numérique accessible et entretien avec un clinicien — et empêchez les conseils diététiques généraux de prévaloir sur les restrictions rénales, les allergies ou les traitements prescrits.
Mesurer la réussite du projet pilote sans exagérer la portée des témoignages
La réussite du projet pilote signifie des soins plus sûrs ou tout aussi sûrs, avec un gain appréciable en termes de flux de travail — et non une simple génération de texte plus rapide. Un projet pilote supervisé de 4 à 6 semaines devrait suivre le temps de révision clinique, les erreurs importantes, l’efficacité de l’escalade, les tests supplémentaires et la compréhension des patients ; sa durée devrait être prolongée si le volume de rapports est trop faible.
Supposons qu’une clinique hypothétique traite 800 rapports par mois, et que le temps médian de révision passe de 4 minutes à 3 minutes. Si l’économie moyenne est également de 1 minute, cela représente environ 13,3 heures de personnel économisées par mois avant les frais généraux de mise en œuvre ; la seule variation de la médiane ne permet pas de calculer de manière fiable le temps total du personnel.
Un tableau de bord utile comporte au moins 6 indicateurs: erreurs d’extraction des valeurs et des unités, erreurs d’interprétation cliniquement significatives, escalades urgentes manquées, temps de révision, examens de suivi supplémentaires et performances par sous-groupe. Suivez le parcours combinant clinicien et IA, car un brouillon dangereux toujours corrigé et un message dangereux envoyé aux patients correspondent à des résultats différents.
Les chiffres d’adoption de Kantesti ne démontrent ni une diminution des hospitalisations, ni une diminution des erreurs diagnostiques, ni une amélioration de la survie. Pour tout récit de réussite publié, demandez 4 détails: le dénominateur, le comparateur, la période d’observation et la définition du résultat ; notre explication sur la vérification des sources aide à distinguer les éléments probants vérifiables d’une présentation persuasive.
Les témoignages peuvent décrire la facilité d’utilisation, mais ils ne peuvent remplacer une évaluation clinique contrôlée. Ne reprenez pas de citations invérifiables et n’inventez pas de cliniciens, de chercheurs ou de patients nommément désignés ; documentez 1 rapport de mise en œuvre attribuable avec ses limites, et précisez si le témoignage a été fourni par un client ou évalué de manière indépendante.
Budgétiser l’intégration, la capacité et les coûts environnementaux
Tarification et accessibilité doivent être évaluées en fonction du coût total du flux de travail déployé, et non uniquement des frais par rapport. Comparez au moins 6 catégories de coûts: licence, intégration, examen clinique, validation, formation et soutien continu ; demandez un devis B2B à jour, car les offres publiques destinées aux consommateurs ne permettent pas d’établir les tarifs institutionnels.
Une unité d’achat utile est le coût par rapport approuvé sur le plan clinique, y compris les téléversements rejetés et le temps de correction du clinicien. Dans un budget hypothétique, £600 le coût mensuel du service plus £400 les frais généraux d’examen pour 500 rapports approuvés équivaut à 2 £ par rapport approuvé; ces chiffres illustrent le calcul et ne correspondent pas à nos tarifs.
Réserver un quota signifie convenir d’une capacité opérationnelle, et non acheter une priorité dans le jugement clinique. Précisez le volume quotidien prévu, la demande de pointe et un objectif de temps de réponse au 95e percentile, puis clarifiez si les nouvelles tentatives, les demandes échouées et les soumissions en double sont comptabilisées dans l’utilisation ; ne réservez une capacité qu’une fois que le projet pilote a établi un flux de travail acceptable.
Les allégations environnementales doivent définir au moins 2 périmètres: les changements de ressources du côté de la clinique et l’utilisation des ressources par le service numérique. Le traitement par l’IA consomme de l’électricité, tandis que la réduction du nombre de pages imprimées ou des visites évitées peut diminuer d’autres impacts ; sans données d’utilisation mesurées ni comparaison crédible, il ne faut revendiquer ni pourcentage de réduction des émissions de carbone ni bénéfice environnemental net.
Évitez de financer le service en développant les tests à faible valeur ajoutée ou les bilans répétés automatiquement. Notre guide annuel de dépistage fondé sur le risque explique pourquoi multiplier les mesures n’améliore pas nécessairement les soins ; incluez 1 mesure d’utilisation dans le projet pilote pour détecter les examens répétés inutiles suscités par des commentaires trop prudents de l’IA.
Utiliser une liste de contrôle de déploiement avec des responsables nommément désignés
Une liste de contrôle pour le déploiement devrait désigner un responsable et un critère de mise en production pour chacune des 6 exigences: cartographie des flux de travail, compatibilité des données, validation locale, approbation par les cliniciens, examen de la confidentialité et mesures du projet pilote. Commencez dans un environnement de test, passez à une évaluation silencieuse, puis n’introduisez une utilisation supervisée auprès des patients qu’une fois ces étapes validées.
Cartographie des flux de travail : désignez le responsable clinique et documentez l’endroit où les brouillons sont versés au dossier. Compatibilité des données : vérifiez les unités, les identités et la gestion des résultats modifiés à l’aide d’au moins 3 formats de rapports si votre service en reçoit autant ; exigez le rejet explicite des formats non pris en charge plutôt qu’une interprétation improvisée.
Validation locale : approuvez le jeu de test, les règles d’arbitrage et les seuils de sécurité avant d’évaluer les performances. Approbation par les cliniciens : vérifiez que 100% des résultats du projet pilote ne peuvent parvenir aux patients sans approbation, et assurez-vous que le processus d’approbation préserve le rapport original plutôt que de le remplacer par une paraphrase de l’IA.
Examen de la confidentialité : remplissez les contrats, effectuez les tests d’accès et procédez à l’évaluation documentée des transferts avant d’utiliser des dossiers permettant d’identifier les personnes. Mesures du projet pilote : définissez à l’avance les mesures de référence et postérieures à l’intégration ; notre guide de préparation aux tests de référence aide également les équipes à recueillir le contexte des échantillons que l’interprétation en aval ne peut pas reconstituer.
La formation devrait couvrir au moins 3 modes de défaillance: une explication plausible mais incorrecte, une valeur associée à une unité inadéquate et une alerte de résultat critique absente. Convenez des horaires d’assistance, des niveaux de gravité des incidents, des contacts pour les escalades et d’une procédure de retour en arrière ; désignez un clinicien remplaçant et prévoyez un processus hors ligne d’examen des résultats, car cela compte davantage qu’une démonstration préliminaire du produit.
Planifier les développements futurs en fonction des données probantes et du contrôle des changements
Développement futur devrait privilégier la traçabilité, une incertitude calibrée, une interopérabilité plus sûre et une évaluation prospective — et non un diagnostic autonome sans éléments probants à l’appui. Conservez 1 dossier versionné du modèle, du schéma de l’interface et de la configuration clinique utilisés pour chaque résultat ; une mise à jour logicielle peut modifier le comportement clinique même si l’interface semble inchangée.
Kantesti est un Plateforme d’interprétation des biomarqueurs par IA dont les intégrations cliniques doivent être évaluées au moyen de données probantes propres à chaque version. Distinguez 3 types de validation: les tests d’extraction technique, l’évaluation de l’interprétation clinique et l’évaluation prospective du flux de travail ; les performances sur des cas synthétiques ne permettent pas d’établir l’efficacité chez des patients dont les dossiers sont incomplets et qui présentent des problèmes cliniques concomitants.
La recherche sur les tendances doit tenir compte de la variation biologique et des changements de dosage, et ne pas interpréter chaque variation en pourcentage comme une réponse au traitement. Une variation hypothétique de la créatinine de 0.90 à 1.00 mg/dL est d’environ 11%, mais sa signification dépend du contexte et de la variation des mesures ; notre guide sur les variations des résultats entre les visites explique cette distinction.
Les jeux de données de recherche nécessitent des autorisations explicites, une finalité définie et une protection contre la réidentification. Utilisez au moins 2 voies d’accès distinctes pour la prestation de services cliniques et la recherche secondaire, et ne supposez pas que la soumission d’un compte rendu à des fins d’interprétation autorise l’entraînement de modèles, la publication ou le rapprochement avec des dossiers externes.
L’amélioration continue nécessite une boucle de rétroaction assortie de seuils d’action prédéfinis, plutôt que des anecdotes informelles. Examinez 4 déclencheurs de revalidation : les mises à jour du modèle, un nouveau dosage de laboratoire ou un nouveau format de compte rendu, l’extension à une nouvelle population et un incident de sécurité important ; les études prospectives devraient mesurer les résultats chez les patients lorsque la revendication visée concerne leur bénéfice.
Procéder à un déploiement responsable et à une recherche transparente
Adoption responsable signifie ne procéder au déploiement que si l’usage prévu, les données probantes locales, la responsabilité clinique et les dispositions relatives à la confidentialité le permettent. Utilisez 1 document final de décision de mise en service pour consigner les vérifications réussies, les limites non résolues et l’autorité responsable du retour en arrière ; les publications de recherche citées ci-dessous fournissent des éléments de formation, et non des preuves de la sécurité de l’intégration.
Le dossier de mise en service d’une clinique doit identifier 3 responsables redevables: cliniques, techniques et chargés de la confidentialité ou de la gouvernance de l’information. Notre information sur l’IA responsable fournit le contexte relatif au fournisseur, mais les responsables locaux doivent décider si les éléments probants justifient l’usage envisagé et si les patients comprennent le rôle de l’interprétation automatisée.
La collaboration communautaire est particulièrement utile lorsque les équipes partagent les catégories de défaillances désidentifiées, les méthodes de test et les mesures d’amélioration plutôt que des affirmations promotionnelles. Organisez un premier examen après 30 jours, puis choisissez une fréquence en fonction du risque et du volume ; signalez la gestion des résultats corrigés et les problèmes liés aux messages destinés aux patients, ainsi que des exemples de mise en œuvre réussie.
La publication sur la coagulation ci-dessous traite du TCA, des D-dimères et de la protéine C, qui correspondent à des questions cliniques différentes plutôt qu’à des scores de risque de coagulation interchangeables. Le document d’accompagnement guide des marqueurs de coagulation fournit un contexte pédagogique ; les intervalles du TCA dépendent du réactif et de l’analyseur, de sorte qu’ une plage universelle ne devrait pas être codée en dur dans tous les laboratoires.
La publication sur les protéines sériques ci-dessous traite de l’albumine, des globulines et du rapport albumine/globulines ; ces résultats nécessitent un contexte clinique et des unités cohérentes. Notre guide d'interprétation des protéines sériques étaye ces lectures de fond ; les 2 dépôts DOI Zenodo désignent des publications pédagogiques, et non des essais évalués par des pairs ou une certification réglementaire.
Foire aux questions
Comment les cliniques intègrent-elles l’interprétation prise de sang par l’IA ?
Les cliniques intègrent l’interprétation des prises de sang par l’IA en reliant les résultats de laboratoire vérifiés à une étape de vérification supervisée, et non en remplaçant l’analyse de laboratoire. Le déploiement doit satisfaire à 6 critères : cartographie des flux de travail, compatibilité des données, validation locale, approbation du clinicien, examen de la confidentialité et indicateurs du projet pilote. Un projet pilote initial devrait exiger l’approbation de 100% des interprétations de l’IA destinées aux patients. Les notifications existantes de résultats critiques doivent continuer même si le service d’IA est indisponible.
Une API d’analyse sanguine par IA peut-elle se connecter à un DSE ou à un système de laboratoire ?
0 Une API d’analyse sanguine par IA peut se connecter à un DPI ou à un système d’information de laboratoire lorsque les formats de données, les interfaces et les dispositifs de sécurité requis sont pris en charge. Vérifiez la prise en charge d’au moins 8 champs, notamment l’identité du patient, l’analyte, la valeur, l’unité, l’intervalle de référence, le type d’échantillon, l’heure du prélèvement et le statut du résultat. FHIR, HL7 v2, LOINC et UCUM peuvent contribuer à standardiser les échanges, mais la disponibilité d’une API ne prouve pas la prise en charge native de ces normes. Les résultats corrigés et les doublons doivent également faire l’objet de tests explicites.
De quel niveau de validation locale une clinique a-t-elle besoin avant d’utiliser l’IA ?
La quantité de validation locale dépend de la tâche visée, du risque clinique, de la diversité des comptes rendus et du niveau d’incertitude acceptable. Une évaluation proposée de 300 comptes rendus peut constituer une conception initiale, mais il ne s’agit pas d’une exigence universelle en matière de taille d’échantillon. La précision de l’extraction, les erreurs d’interprétation cliniquement significatives et les défauts d’escalade doivent être mesurés séparément. Zéro omission dans 100 cas critiques permet tout de même une limite de confiance supérieure approximative de 3% à 95% selon des hypothèses binomiales simples.
L’interprétation prise de sang par l’IA nécessite-t-elle l’approbation d’un clinicien ?
L’interprétation des analyses sanguines par l’IA destinée aux patients devrait nécessiter l’approbation d’un clinicien lors d’un projet pilote clinique initial supervisé. Un objectif initial pratique est une couverture d’approbation de 100%, en conservant le rapport source, la version du modèle, le clinicien approbateur et l’heure d’approbation. L’exigence d’approbation ne remplace pas la procédure du laboratoire concernant les résultats urgents. Une kaliémie de 6,5 mmol/L ou plus nécessite généralement une évaluation clinique urgente plutôt que d’attendre une explication générée par l’IA.
L’intégration d’analyses sanguines par IA est-elle automatiquement conforme au GDPR ?
L’intégration d’un test sanguin par IA n’est pas automatiquement conforme au GDPR parce qu’un fournisseur décrit son service comme étant aligné sur le GDPR. Avant le premier téléversement de données identifiantes, la clinique devrait documenter la base juridique, les rôles de responsable du traitement et de sous-traitant, les sous-traitants ultérieurs, la durée de conservation, la sécurité et les transferts internationaux. Une évaluation des flux de données devrait également vérifier au moins 6 identifiants, notamment les noms, les numéros de dossier, les codes QR et les métadonnées des images. Les exigences relatives aux dispositifs médicaux et à la sécurité clinique sont distinctes de la conformité à la protection des données.
Comment une clinique doit-elle mesurer le retour sur investissement de l’intégration de l’IA ?
Une clinique devrait mesurer le rendement de l’intégration de l’IA en calculant le coût total par rapport approuvé, ainsi que les résultats en matière de sécurité et de flux de travail. Dans un exemple hypothétique, un gain moyen de 1 minute sur 800 rapports mensuels représente environ 13,3 heures de personnel économisées avant les frais généraux liés à la mise en œuvre. Suivez les erreurs cliniquement significatives, les escalades urgentes, les examens supplémentaires et le temps de correction par le clinicien, ainsi que la rapidité. Une interprétation grand public en environ 60 secondes ne garantit pas un niveau de service contractuel pour une API clinique.
Faites-vous expliquer vos résultats prise de sang
Téléversez votre compte rendu d’analyses et l’IA de Kantesti explique chaque biomarqueur en langage clair en quelques secondes. Déjà utilisé par plus de 2 millions de personnes dans le monde.
Références
- Klein, T., Mitchell, S., et Weber, H. (2024). Plage normale du TCA : guide sur les D-dimères et la coagulation sanguine par la protéine C. Recherche médicale par IA de Kantesti. DOI
- Klein, T., Mitchell, S., et Weber, H. (2024). Guide des protéines sériques : globulines, albumine et rapport albumine/globulines dans les analyses sanguines. Recherche médicale par IA de Kantesti. DOI
- Comité de pratique professionnelle de l’American Diabetes Association (2024). 2. Diagnostic et classification du diabète : normes de prise en charge du diabète — 2024. Diabetes Care. DOI
- Groupe de travail KDIGO sur la maladie rénale chronique (2024). Recommandation de pratique clinique KDIGO 2024 pour l’évaluation et la prise en charge de la maladie rénale chronique. Kidney International. DOI
- Rybak MJ et al. (2020). Suivi thérapeutique de la vancomycine pour les infections graves à Staphylococcus aureus résistant à la méthicilline : guide de consensus révisé et revue par l’American Society of Health-System Pharmacists, l’Infectious Diseases Society of America, la Pediatric Infectious Diseases Society et la Society of Infectious Diseases Pharmacists. American Journal of Health-System Pharmacy. DOI
- 2 millions et plusTests analysés
- 127+Des pays
- 100+Langues
À propos de l’équipe médicale


Signaux de confiance E-E-A-T
Expérience
Revue clinique guidée par un médecin des flux d’interprétation des analyses.
Compétence
Orientation en médecine de laboratoire sur la façon dont les biomarqueurs se comportent dans un contexte clinique.
autorité
Révisé médicalement par le Dr Thomas Klein, avec la contribution de la Dre Sarah Mitchell et du Pr Dr Hans Weber.
Fiabilité
Interprétation fondée sur des preuves, avec des parcours de suivi clairs pour réduire l’alarme.
Avertissement médical
Cet article est fourni à des fins éducatives uniquement et ne constitue pas un avis médical. Consultez toujours un professionnel de santé qualifié pour les décisions de diagnostic et de traitement.
Publié · Mis à jour · Contacter l’équipe éditoriale
Publié par Kantesti Ltd, immatriculée en Angleterre et au pays de Galles, sous le numéro d’entreprise. 17090423, Londres, Royaume-Uni.

3 répond à « AI Blood Test Integration for Clinics: A 2026 Guide »
Excellent outil d'analyse de test sanguin IA et très bon marché pour les cliniques.
En tant que clinique basée au Luxembourg, nous sommes ravis de voir un outil d'IA aussi révolutionnaire pour l'interprétation des analyses sanguines. L'innovation de PIYA.AI s'aligne parfaitement avec notre vision de faire progresser le diagnostic de précision et les soins aux patients. Nous apprécions la rigueur scientifique et l'accessibilité qu'offre cette solution, offrant un soutien inégalé aux cliniques du monde entier. Merci d'avoir développé une technologie aussi transformatrice dans le cadre du White Lab. Nous sommes impatients d'intégrer cet outil dans nos systèmes et de faire partie de cette révolution dans les soins de santé. – Tino
j'aimerais un système d'analyse sanguine IA.