
Klinisk validering innebär att testa om programvaran ger tillräckligt träffsäkra och säkra tolkningar för de patienter den är avsedd för – inte bara om den genererar övertygande rapporter.

Viktiga slutsatser
- Valideringens omfattning måste identifiera avsedda patienter, laboratorieunderlag och kliniska beslut; framgång med en uppgift kan inte fastställa säkerhet för all användning.
- Nämnare för träffsäkerhet bör skilja mellan patienter, rapporter, biomarkörer och enskilda påståenden; 10 000 påståenden kan härröra från bara 200 rapporter.
- Känslighet mäter upptäckta referenspositiva fall; ett hypotetiskt resultat på 90/100 innebär att 10 drabbade fall missades.
- Prediktivt värde beror på prevalensen: vid en prevalens på 1% ger en sensitivitet på 90% och en specificitet på 95% ett positivt prediktivt värde på cirka 15.4%.
- Oberoende testning kräver skyddade testdata, en fryst programvaruversion och upplysningar om vem som utformade, finansierade och bedömde utvärderingen.
- Belägg för undergrupper måste inkludera urvalsstorlekar och osäkerhet; att observera 0 missar bland 20 positiva fall visar inte att sensitiviteten är perfekt.
- Operativ hastighet på cirka 60 sekunder beskriver vår tolkningsfunktion, inte en påvisad minskning av diagnostiska fel eller behandlingsfördröjningar.
- Kriterier för införande bör omfatta säkerhet på patientnivå, prestanda för respektive språk, indatafel och en dokumenterad hantering av programvaruändringar.
AI:s framväxt inom medicinsk diagnostik: vad validering innebär
Validering av AI-blodprov kräver belägg för att en specificerad programvaruversion ger korrekta och säkra tolkningar för de patienter och beslut den är avsedd för. Köpare bör granska nämnare på patientnivå, oberoende tester, resultat för undergrupper och felhantering – inte enbart en framträdande procentsiffra för träffsäkerhet. Kantesti är en AI-analysator för blodprov vars resultat bör uppfylla samma evidenskrav.
Tolkningsprogramvara mäter inte det ursprungliga provet. En laboratorieanalysator genererar värden såsom natrium på 138 mmol/L; tolkningsprogramvaran läser sedan av dessa värden och förklarar deras möjliga betydelse, vilket skapar ytterligare en risk för fel även när laboratoriemätningen är korrekt. Köpare behöver därför separata belägg för extraktionsnoggrannhet, hantering av referensintervall och kliniskt resonemang.
Klinisk validitet och klinisk nytta besvarar olika frågor. En utvärdering kan visa överensstämmelse för 500 rapporter utan att visa att patienterna får bättre vård, slipper onödiga utredningar eller förstår osäkerheten bättre. Vår guide till förklaringar av medicinska rapporter förklarar varför begripligt språk ändå kräver källkontroll och lämpliga gränser för eskalering.
Adoptionsstatistik kan inte ersätta en klinisk studie. Vår plattformsrapporterade räckvidd på 2M+ användare i 127+ länder beskriver användning, inte en representativ valideringskohort med bekräftade utfall. Den företagsbakgrund bidrar till att fastställa organisatoriskt ansvar; en separat evidensdokumentation måste ange exakt avsedd användning, målpopulation och konsekvenserna av en felaktig tolkning.
Påståenden om träffsäkerhet: räkna patienter, rapporter och beslut separat
Ett påstående om träffsäkerhet kan tolkas först när täljare, nämnare och poängsättningsregler redovisas. En siffra som 98.49% kan avse extraherade fält, godkända påståenden eller klassificerade fall – mycket olika uppgifter. Här är den siffran ett exempel på en framträdande uppgift som kräver granskning, inte ett oberoende verifierat resultat av klinisk prestanda.
Upprepade påståenden är inte oberoende patienter. I en hypotetisk utvärdering ger 200 rapporter med 50 poängsatta påståenden vardera 10 000 observationer på påståendenivå, men fortfarande bara 200 rapporter. En korrekt förklaring av natrium på 140 mmol/L bör inte väga upp en farlig rekommendation någon annanstans i samma rapport; kräv både poängsättning på påståendenivå och andelen rapporter som innehåller kliniskt betydelsefulla fel.
Uteslutna indata kan blåsa upp den skenbara tillförlitligheten. Anta att 1 000 rapporter skickas in, att 100 avvisas och att 882 av de återstående 900 uppfyller bedömningskriterierna: träffsäkerheten bland slutförda rapporter är 98%, medan andelen inskickade rapporter som ger ett godtagbart resultat är 88.2%. Inget av nämnarvalen är i sig oärligt, men köpare behöver båda, samt skälen till avvisning och information om huruvida de avvisade fallen i oproportionerlig grad gäller akuta avvikelser.
Publicerad metodik bör definiera vad som räknades som korrekt innan poängsättningen började. STARD 2015:s rapporteringsuttalande ber studier av diagnostisk träffsäkerhet att beskriva urvalet av deltagare, referensstandarden och deltagarflödet (Bossuyt et al., 2015). Vår sida om valideringsmetodik är en utgångspunkt för frågor om Kantesti; det bör inte betraktas som bevis för oberoende prestanda på patientnivå utan tillgång till det underliggande studiematerialet.
Sensitivitet, specificitet och prediktivt värde besvarar olika frågor
Sensitivitet mäter upptäckt bland fall som är positiva enligt referensstandarden; specificitet mäter korrekta negativa resultat bland fall som är negativa enligt referensstandarden. Positivt prediktivt värde mäter hur ofta ett positivt resultat är korrekt i den testade miljön. För ett hypotetiskt verktyg med 90% sensitivitet och 95% specificitet vid 1% prevalens är det positiva prediktiva värdet ungefär 15.4%.
En förväxlingsmatris synliggör avvägningen. Bland 10 000 hypotetiska patienter med 1% prevalens har 100 måltillståndet: 90 upptäcks och 10 missas. Av de 9 900 som inte har tillståndet får 495 falskt positiva resultat; följaktligen är endast 90 av 585 positiva resultat korrekta, trots att den totala träffsäkerheten är 94.95%.
Precision är inte en universell synonym till träffsäkerhet. Inom klassificering betyder precision vanligtvis positivt prediktivt värde, medan en leverantörs bedömningsmatris för berättande kan använda ordet på ett annat sätt. Vår diskussion om bekräftelse av antikroppar vid låga nivåer illustrerar den kliniska principen: tolkningen beror på sannolikheten före testet och bekräftelse, inte enbart på om ett första resultat överskrider en tröskel.
Valet av tröskel förändrar avvägningen mellan missade fall och falsklarm. Be om förväxlingsmatrisen vid den föreslagna driftsättningströskeln, inte bara en prestandakurva som omfattar många trösklar. I en hypotetisk larmstudie kan en sänkning av tröskeln från 0,7 till 0,4 förbättra sensitiviteten och samtidigt fördubbla antalet falsklarm; köpare måste avgöra om den avvägningen passar de kliniska konsekvenserna och granskningskapaciteten.
Oberoende testning kräver en skyddad datamängd och en trovärdig referensstandard
Oberoende testning utvärderar en fryst modell på data som inte var tillgängliga under utvecklingen, med redovisade relationer till utvärderaren och en kliniskt försvarbar referensstandard. Externa data garanterar inte i sig en oberoende utvärdering. En studie som omfattar 3 sjukhus kan ändå ha partiska etiketter, delade datapipelines eller testfall som påverkat modellens finjustering.
Separation på patientnivå förebygger en vanlig form av dataläckage. Om en patients januarirapport ingår i träningsdata och hens februarirapport i testdata kan modellen dra nytta av återkommande mönster eller identifierare. Köpare bör fråga hur dubbletter av patienter, återkommande inläggningar och rapporter från 2 sammankopplade laboratoriesystem identifierades, och om den slutliga testmängden förblev orörd efter valet av modell och prompt.
Referensstandarden måste motsvara påståendet. Experters överensstämmelse om 300 tolkningar kan användas för att bedöma rapportkvalitet, men bekräftar inte automatiskt förekomst av sjukdom eller framtida utfall. Skillnaden är välkänd från analysnoggrannhet och timing: testet som utvärderas, jämförelsemetoden och tidpunkten för bekräftelse kan alla påverka den skenbara prestandan.
Syntetiska riktmärken testar konstruerade fall, inte sjukdomsprevalens eller klinisk nytta i verkligheten. Inte ens 100 000 syntetiska scenarier kan återskapa varje saknad anamnesuppgift, provartefakt eller oväntad sjukdomsbild. För påståenden som rör begränsningar vid tolkning av troponin, en studie behöver den kliniska information och den diagnostiska uppföljning som är relevanta för påståendet; en korrekt mening om en laboratorietröskel är inte en bekräftad diagnos.
Prestanda i undergrupper kan avslöja risker som döljs av genomsnittet
Validering av undergrupper visar om prestandan förändras mellan kliniskt relevanta patientgrupper och indatavillkor. Köpare bör begära nämnare, felens allvarlighetsgrad och konfidensintervall för barn, äldre vuxna, graviditet, nedsatt njurfunktion och andra avsedda populationer. Att observera 0 missar bland 20 referenspositiva fall innebär betydande osäkerhet om den verkliga missfrekvensen.
Åldersspecifika referensintervall är inte utbytbara. En pediatrisk tolkning kan inte utan risk överta varje tröskelvärde för vuxna, även när den underliggande analyten och enheten är identiska. Vår guide om AI-tolkning för barn förklarar säkerhetsgränsen; köpare bör begära faktiska antal per åldersgrupp i stället för att godta ett brett påstående som omfattar patienter från 1 till 18 år.
Biologisk kontext är viktigare än demografiska genvägar. Ett absolut neutrofilantal på 1.2 × 10^9/L kan kräva ett annat resonemang hos en stabil person med ett Duffy-null-associerat antal än hos någon vars värde nyligen sjunkit under behandling. Den förklaring av Duffy-null-neutrofiler stöder ett riktat testfall; härkomst ensam får inte användas för att anta genotyp eller klinisk säkerhet.
Små urval kan dölja kliniskt betydelsefulla felfrekvenser. Den ungefärliga tre-regeln innebär att 0 observerade händelser bland 20 oberoende observationer motsvarar en övre 95%-gräns nära 15%, inte 0%. Jämförelser mellan undergrupper kräver också analys som tar hänsyn till patientklustring när rapporter upprepas; en studie bör redovisa oprövade grupper i stället för att behandla en icke-signifikant skillnad som bevis för likvärdig prestanda.
Flerspråkigt stöd kräver språkspecifik säkerhetstestning
Flerspråkig validering kontrollerar om den kliniska betydelsen bevaras vid översättning, numerisk formatering och patientinriktade förklaringar på varje avsett språk. Kantesti är en AI-plattform för tolkning av blodprov med stöd för 100+ språk; den förmågan i sig fastställer inte likvärdig klinisk prestanda på dessa språk. Varje språk behöver en lämplig utvärderingsstrategi och redovisad täckning.
Decimalteckenskonventioner kan förändra det tolkade värdet. Ett glukosresultat som skrivs 5,6 mmol/L i en lokal får inte bli 56 mmol/L efter extrahering, och en enhetsomvandling måste bevara den kliniska betydelsen i stället för att bara byta ut skiljetecken. Utvärdera originalspråkiga indata och översatta utdata separat; tester som enbart omfattar engelska laboratorierapporter översatta till 10 språk missar fel på indatasidan.
Negation och resultattype kräver särskilda testfall. Utsagor som inte detekterat, under kvantifieringsgränsen och kan inte utesluta förmedlar olika grader av säkerhet. Vår kvalitativ kontra kvantitativ guide förklarar skillnaden; en tvåspråkig granskningsmall bör testa dessa betydelser, inklusive olikhetssymboler som mindre än 0.1, i stället för att enbart belöna ett flytande språk.
Läsbarhet garanterar inte förståelse. En användbar språkutvärdering kan be deltagare identifiera den åtgärd som krävs och osäkerheten efter att ha läst 3 korta rapporter, samtidigt som man noterar om översättningen ändrar hur brådskande något är eller råd om läkemedel. Detta är föreslagna utvärderingsuppgifter, inte en validerad universell tröskel; språk med färre resurser kan behöva ytterligare granskning eftersom tillgången till klinisk terminologi och utbildningstäckningen varierar.
API-integrering och rapportformat måste bevara den kliniska innebörden
Integrationsvalidering kontrollerar om patientidentitet, värden, enheter, datum och varningar förblir korrekta över systemgränser. HTML-, JSON- och PDF-utdata bör förmedla samma kliniska innehåll när dessa format stöds. Ett natriumresultat på 128 mmol/L får inte ändra innebörd för att en utdata utelämnar en varning eller en annan kapar ett fält.
En fungerande API-anslutning är inte en validerad klinisk integration. Vårt B2B-API kräver driftsättningsspecifika kontroller av mappning, autentisering, svarshantering och versionsbeteende; kompatibilitet med EHR eller LIS bör demonstreras för det faktiska gränssnittet. Testa minst 3 felklasser – saknade enheter, matchningsfel mellan patientidentifierare och fördröjda dubbla svar – i stället för att godta en enda lyckad demonstrationsbegäran.
Härledda värden kräver uttryckliga indata och dokumenterad formelhärkomst. Korrigerat natrium beror till exempel på uppmätt natrium, glukos och korrigeringsmetod; olika publicerade koefficienter kan ge olika uppskattningar. Vår guide för glukosrelaterad natriumkorrigering tillhandahåller ett kliniskt testfall, men köpare bör verifiera att glukos i mg/dL aldrig behandlas som mmol/L och att eventuella beräkningar anger sina antaganden.
Överensstämmelse mellan format bör omfatta innebörden, inte bara layouten. I ett hypotetiskt exporttest med 300 rapporter kan JSON bevara en kritisk flagga medan en PDF-mall döljer den under en sidbrytning. Jämför kliniska rekommendationer, osäkerhet, enheter och tidsstämplar mellan utdataformat som stöds; se till att råvärden kan spåras till källan och ange om ett saknat fält leder till ett säkert avvisande eller en tolkning utan stöd.
Snabba rapporter och ett användarvänligt gränssnitt behöver fortfarande belägg för användbarhet och säkerhet
Hastighet och användbarhet är operativa fördelar, inte direkta belägg för diagnostisk träffsäkerhet. Vår tolkningsfunktion genererar vanligtvis en förklaring på cirka 60 sekunder, men vid klinisk driftsättning bör fördröjning från början till slut, misslyckade begäranden och granskningsbörda mätas. Enbart en median för bearbetningstiden kan inte visa om brådskande resultat når rätt person på ett säkert sätt.
Fördröjning bör redovisas som en fördelning. Begär medianen, 95:e percentilen och timeoutfrekvensen vid realistisk samtidig användning, inklusive stora filer och fotografier av låg kvalitet. En hypotetisk median på 45 sekunder med en 95:e percentil på 240 sekunder beskriver en helt annan tjänst än en som konsekvent slutförs på omkring 60 sekunder; inget av värdena visar att behandlingen inleds tidigare.
Brådskande laboratoriefynd kräver testad presentation och eskalering. Ett kaliumresultat på 6.5 mmol/L kan tyda på ett medicinskt akuttillstånd, även om provkvalitet och kliniskt sammanhang påverkar tolkningen. Vår guide om brådskande elektrolytfynd stödjer utformningen av scenarier; patienter med en brådskande laboratorievarning bör omgående kontakta behandlande vårdenhet i stället för att vänta på en appförklaring, särskilt om de har symtom.
Testning av mänskliga faktorer mäter vad användarna gör med rapporten. För webb, iOS, Android och åtkomst via tillägg bör köpare undersöka minst 3 uppgifter: att hitta det ursprungliga värdet, känna igen osäkerhet och identifiera nästa lämpliga åtgärd. Registrera felaktiga åtgärder såväl som slutförandetid, eftersom ett polerat gränssnitt kan öka tilliten till en rekommendation utan stöd och göra automatiseringsbias svårare att upptäcka.
Belägg för säkerhet och integritet hör hemma tillsammans med klinisk validering
En integritetsbedömning verifierar hur känslig laboratorieinformation samlas in, behandlas, lagras, delas och raderas. GDPR-anpassad hantering är en angiven inriktning, inte en ersättning för avtalsmässiga och tekniska belägg. För Kantesti Ltd, UK Company No. 17090423, bör köpare fastställa det tillämpliga förhållandet mellan personuppgiftsansvarig och personuppgiftsbiträde samt respektive ansvar innan ens 1 identifierbar rapport skickas.
Hälsouppgifter kräver mer än att ett namn tas bort. En rapport kan innehålla en streckkod, ett exakt födelsedatum, ett accessionsnummer eller en beskrivande uppgift som kan identifiera någon i kombination med annan information. Vår integritetsåtgärder vid uppladdning förklara praktisk dataminimering; en köpare bör utvärdera minst 3 lager separat: filinnehåll, kontometadata och driftloggar.
Säkerhetspåståenden behöver ett definierat omfång och ett evidensdatum. Granska krypteringslösningar, åtkomstkontroller, listor över underbiträden, villkor för incidentmeddelanden och inställningar för lagring i dokumentationen om dataskydd. Om en leverantör hänvisar till en granskning ska du fråga vilken tjänst och vilken kontrollperiod den omfattar; en rapport som omfattar 1 infrastrukturkomponent bedömer inte automatiskt åtkomst till kliniska applikationer eller hantering av modelldata.
Internationell driftsättning medför ytterligare skyldigheter. Användning i 127+ länder betyder inte att ett enda avtal eller en rättslig grund täcker alla jurisdiktioner, och anpassning till GDPR innebär inte att HIPAA är tillämpligt eller att dess krav uppfylls. För familjefunktioner ska du testa behörighetsgränser med 2 separata konton, inklusive återkallande av åtkomst och kontoåterställning; huruvida borttagning av en rapport också tar bort säkerhetskopior och loggar kräver ett uttryckligt svar.
AI-motorn: validera förutsägelser och rekommendationer separat
En AI-motor behöver validering för specifika påståenden om mönstertolkning, förutsägelse av framtida risk och personliga rekommendationer. Detta är olika uppgifter, även när de genereras i 1 rapport. Arkitektur för djupinlärning och multiparameteranalys beskriver hur ett system fungerar; de bevisar inte att dess sannolikhetsuppskattningar, diagnostiska förslag eller kostråd är kliniskt tillförlitliga.
Multiparametertolkning bör bevara alternativa förklaringar. I en hypotetisk rapport med ferritin på 40 ng/mL och CRP på 20 mg/L kan ferritin ensamt inte avgöra frågan om järntillgänglighet eftersom ferritin kan stiga vid en akutfasreaktion. Köpare som utvärderar Kantesti:s neurala nätverk bör använda sådana kontextkänsliga fall, medan teknikförklaring förblir åtskild från evidens för att en specifik klinisk slutsats är korrekt.
Riskprediktion kräver ett definierat utfall och en tidsram. En sannolikhet på 20% är omöjlig att tolka utan att ange vad som kan hända, vem det kan hända och under vilken tidsperiod – till exempel sjukhusinläggning inom 30 dagar snarare än sjukdomsdebut inom 5 år. TRIPOD+AI rekommenderar transparent rapportering av studier av prediktionsmodeller (Collins et al., 2024); kalibrering och extern validering är viktiga, även för trendanalys relaterad till läkemedel.
Personliga råd medför en separat säkerhetsskyldighet. En näringsrekommendation kan vara olämplig om information om njurfunktion, läkemedel eller graviditet saknas; Family Health Risk behöver också tydlig hantering av osäker eller självrapporterad sjukdomshistorik. Vår njur-näringssäkerhetsguide erbjuder relevanta testsituationer, men att godkänna en måltidsplan med 3 punkter är inte evidens för att den förbättrar utfall eller på ett säkert sätt ersätter en individuell dietistbedömning.
Så fungerar tolkning av blodprov med AI: en valideringschecklista för köpare
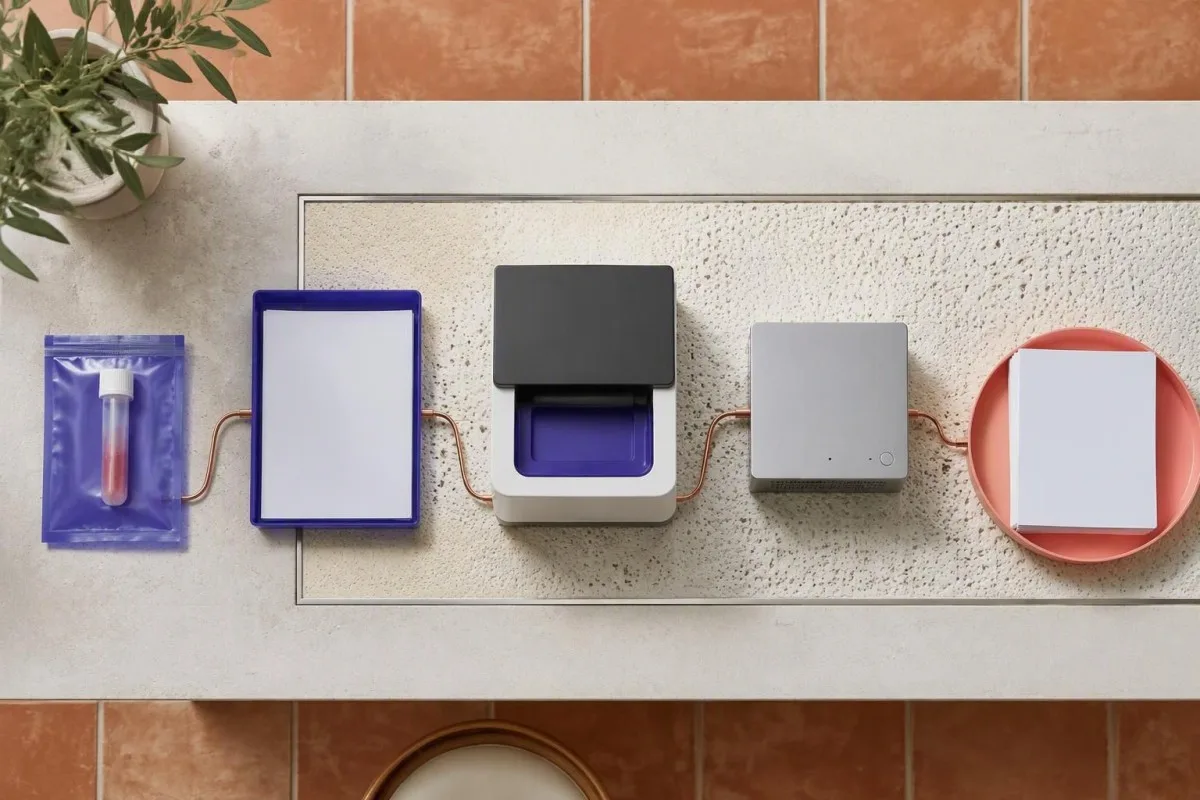
En köpare bör testa hela sekvensen: insamling av källmaterial, normalisering, kontextuell tolkning, rapportgenerering och klinisk granskning. Utvärdera varje steg separat innan det kombinerade systemet testas. En acceptansplan i 5 steg gör det lättare att identifiera om ett osäkert resultat började med ett felläst värde, ett felaktigt antagande eller en olämplig rekommendation.
Börja med att definiera den avsedda användningen och låsa den version som ska utvärderas. Steg 1 är en skriftlig förteckning över påståenden och risker; steg 2 är en låst, representativ datamängd med fördefinierade kriterier för behörighet och referensetiketter. Insamling från PDF eller foto bör sedan testas med ändrade layouter, decimalnotationer och oläsliga fält; dokumentera avvisningar i stället för att i tysthet utesluta dem från den slutliga nämnaren.
Testa därefter kontext- och longitudinella antaganden. Steg 3 kontrollerar enheter, referensintervall och metadata; steg 4 poängsätter tolkningar och rekommendationer med kliniskt meningsfulla svårighetskategorier. Vår guide till förändringar mellan laboratoriebesök stöder en relevant utmaning: en kreatininförändring från 80 till 100 µmol/L kräver att tidpunkt, analysvariation och patienten beaktas, inte att en försämring automatiskt fastslås.
Avsluta med ett beslut om driftsättning, inte en slogan om träffsäkerhet. Steg 5 utvärderar prospektiv lokal användning och hantering av fel mot kriterier som överenskommits innan resultaten granskas, inklusive osäkerhetsgränser och eskaleringsbeteende. Begär en dokumentation som innehåller kohortflöde, modellversion, fullständig poängsättningsmatris, tabeller för undergrupper, exempel på skadliga utdata och regler för ändringskontroll; ingen universell procentsats kan ersätta acceptanströsklar som anpassats efter konsekvenserna av fel.
Exempelrapporter och kundomdömen: skilj illustration från belägg
En exempelrapport visar presentation och resonemang, medan ett omdöme beskriver ett individuellt intryck. Ingetdera fastställer träffsäkerhet på patientnivå eller klinisk nytta. Betrakta en tydligt hypotetisk 52-årig vuxen med kreatinin på 118 µmol/L, rapporterat eGFR på 58 mL/min/1.73 m² och inga tidigare provresultat tillgängliga: den säkra förklaringen måste bevara osäkerheten.
Ett enda lågt eGFR fastställer inte kronisk njursjukdom. KDIGO definierar kronisk njursjukdom genom avvikelser i njurarnas struktur eller funktion som föreligger i minst 3 månader; ett eGFR under 60 mL/min/1.73 m² kräver bedömning av varaktighet och sammanhang (KDIGO CKD Work Group, 2024). I detta hypotetiska exempel bör en rapport föreslå läkarbedömning och lämplig uppföljning, inte diagnostisera bestående njurskada utifrån ett enda provresultat.
Kreatininbaserade skattningar kan vara mindre informativa vid ovanlig kroppssammansättning. Om den hypotetiska personen är mycket muskulös eller nyligen har ändrat sina kosttillskott bör tolkningen ta hänsyn till dessa faktorer i stället för att avfärda resultatet. Vår diskussion om kreatinin hos muskulösa vuxna ger sammanhang; KDIGO stödjer kreatinin–cystatin C-baserad skattning när sådan finns tillgänglig för lämplig CKD-bedömning hos vuxna, i stället för att anta att den första skattningen är definitiv.
Demonstrationer bör omfatta svåra indata och ogynnsamma utdata. Lägg till ett separat hypotetiskt kaliumresultat på 6.0 mmol/L med en flaggad provfråga, och använd vår begränsningar för hemolysrelaterade resultat för att förklara varför både bekräftelse och brådska måste beaktas. För Kantesti är en användbar utvärdering en blindad jämförelse av fullständiga rapporter; professionella omdömen, om de presenteras med samtycke, är fortsatt erfarenhetsbaserad återkoppling snarare än en ersättning för sådan testning.
Omfamna diagnostikens framtid: evidensbaserad användning
Inför AI-tolkning endast för användningsområden som stöds av evidens, med lokal tillsyn och en dokumenterad hantering av fel. Kantesti är ett AI-drivet verktyg för analys av blodprov; vår funktionsuppsättning bör bedömas enligt samma upphandlingsstandarder som beskrivs här. Att börja med 1 begränsat användningsområde är säkrare än att anta att evidensen gäller alla patienter och rekommendationer.
Ett stegvis införande bör skilja genomförbarhet från effektivitet. En hypotetisk skuggutvärdering av 100 rapporter kan avslöja integrationsfel och vanliga formuleringsproblem utan att utsätta patienter för oreviderade rekommendationer, men den kommer sannolikt inte att fastställa en låg frekvens av sällsynta allvarliga fel. En bredare prospektiv utvärdering behöver en motivering av stickprovsstorleken och utfall som motsvarar det faktiska påståendet, inklusive onödig uppföljning såväl som missade problem.
Programvaruändringar kan påverka tidigare uppmätt prestanda. En ny modell, prompt, databas med referensintervall eller rapportmall kan ändra utdata även när produktnamnet förblir detsamma; registrera alla 4 kategorier i driftsättningshistoriken. Övervaka felens allvarlighetsgrad, avståenden, förändringar mellan undergrupper och användaröverskrivningar, och definiera när en ändring utlöser riktad regressionstestning, en förnyad lokal utvärdering eller avstängning av en viss funktion.
Beslutet om införande bör grundas på en skriftlig analys av evidensluckor. Identifiera vad som har fastställts oberoende, vad som endast stöds av teknisk testning och vad som fortfarande inte har testats; utse sedan en ansvarig för varje olöst risk. Vår kontaktkanal för vårdköpare är rätt plats att begära dokumentation som är specifik för användningsområdet – föredra ett snävare, underbyggt påstående framför en rubrik med 99% där nämnaren är oklar.
Forskningspublikationer: skilj utbildningsguider från valideringsstudier
De 2 DOI-referenserna till arkiv nedan identifierar utbildningsguider, inte kliniska valideringsstudier av AI-programvara för tolkning. En DOI ger en beständig identifierare; den fastställer inte sakkunniggranskning, patientrekrytering, oberoende utvärdering eller klinisk effekt. Köpare bör klassificera varje citerad publikation utifrån vilken fråga den faktiskt kan besvara.
Utbildningsguider kan hjälpa till att utforma ett valideringsramverk utan att själva validera produkten. Vår komplement- och ANA-guiden kan ge vägledning i fall där 2 komplementmätningar och antikroppskontext behöver förklaras noggrant. Överensstämmelse med en guide är inte likvärdig med överensstämmelse med oberoende bedömda patientutfall, särskilt när guiden och den utvärderade programvaran har samma organisatoriska ursprung.
Guider om diagnostisk tidpunkt behandlar en annan användbar felkälla. Vår Nipah diagnostiska testguide behandlar ett specialiserat diagnostiskt sammanhang; den bör inte användas för att antyda att rutinmässig laboratorietolkning identifierar ett visst virus. Om en köpare inkluderar ens 1 patogenpåstående med potentiellt allvarliga konsekvenser i den avsedda användningen, behöver det påståendet egen relevant diagnostisk evidens och lämpliga gränser för eskalering.
Standarder för studierapportering stöder granskning snarare än intygar prestanda. STARD 2015 innehåller 30 rapporteringspunkter för diagnostiska noggrannhetsstudier, medan TRIPOD+AI behandlar rapportering av prediktionsmodeller; ingen av checklistorna ger programvara ett kliniskt godkännandestämplar. Referenserna nedan skiljer dessa metodologiska källor och KDIGO-riktlinjen från 2024 från de 2 pedagogiska DOI-posterna, så att läsarna kan skilja mellan kliniska rekommendationer, rapporteringsvägledning och produktspecifik evidens.
Vanliga frågor
Vad innebär klinisk validering av programvara för AI-blodprov?
0 Klinisk validering utvärderar om en viss version av AI-programvara för blodprov ger tillräckligt korrekta och säkra resultat för de patienter och beslut som den är avsedd för. Den bör skilja mellan minst 3 uppgifter: att läsa källrapporten, tolka den kliniska betydelsen och rekommendera en åtgärd. Evidensen bör beskriva referensstandarden, urvalsstorleken på patientnivå, oberoende testning och hantering av fel. En tekniskt korrekt förklaring bevisar inte i sig förbättrade patientutfall.
Räcker noggrannheten hos 99% för att lita på en AI-analysator för blodprov?
Ett påstående om 99% noggrannhet kan inte fastställa säkerhet utan att ange nämnaren, uppgiftsdefinitionen och felens allvarlighetsgrad. I en hypotetisk grupp där bara 1% har ett måltillstånd uppnår programvara som klassificerar alla som negativa 99% noggrannhet, samtidigt som den inte upptäcker någon av de drabbade patienterna. Köpare bör begära sensitivitet, specificitet, fel i rapporter på patientnivå och antalet indata som avvisats. Sällsynta men farliga rekommendationer får inte försvinna i ett genomsnitt som domineras av enkla påståenden.
Vad är skillnaden mellan ett syntetiskt riktmärke och klinisk validering?
Ett syntetiskt riktmärke utvärderar programvara på konstruerade fall, medan klinisk validering kräver evidens som är lämplig för den avsedda patientpopulationen och det kliniska påståendet. Inte ens 100 000 syntetiska fall kan fastställa prevalens i verkligheten, klinisk nytta eller prestanda vid varje problem med saknad anamnes och provkvalitet. Syntetisk testning kan hjälpa till att identifiera tekniska fel och stödja regressionskontroller. Den bör komplettera, inte ersätta, representativ extern och prospektiv utvärdering.
Hur mycket oberoende testning behöver AI inom hälso- och sjukvården?
AI inom hälso- och sjukvården behöver oberoende tester som står i proportion till konsekvenserna av ett felaktigt resultat, inte ett universellt minimiantal rapporter. Att observera 0 fel i 100 oberoende fall innebär en ungefärlig övre gräns för felfrekvensen på 3%, enligt tre-regeln. Köpare bör begära skyddade testdata, en fryst modellversion och redovisade relationer mellan utvärderare. Påståenden om sällsynta allvarliga fel kräver vanligtvis mer evidens än vad en liten pilotstudie om användbarhet eller genomförbarhet kan ge.
Betyder stöd för 100 språk att noggrannheten är densamma på alla språk?
Stöd för 100 språk fastställer inte likvärdig klinisk noggrannhet på alla dessa språk. Språkspecifik utvärdering bör testa inmatningsextraktion, decimaltecken, enheter, negation och rekommendationernas innebörd. Till exempel får glukos angivet som 5,6 mmol/L inte tolkas som 56 mmol/L. Köpare bör begära språkspecifika nämnare och uppge vilka språk som inte har granskats kliniskt.
Kan AI diagnostisera kronisk njursjukdom utifrån ett enda lågt eGFR-resultat?
Ett eGFR-resultat under 60 mL/min/1.73 m² räcker inte i sig för att fastställa kronisk njursjukdom. KDIGO:s riktlinje från 2024 definierar kronisk njursjukdom utifrån avvikelser i njurarna som föreligger i minst 3 månader, med bedömning av kroniskhet och kliniskt sammanhang. Akuta förändringar, kroppssammansättning och andra faktorer kan påverka tolkningen. AI-programvara bör förklara osäkerheten och stödja klinisk uppföljning i stället för att klassificera en enda sänkt skattning som permanent sjukdom.
Få dina blodprovsresultat förklarade
Ladda upp din laboratorierapport så förklarar Kantesti:s AI varje biomarkör på ett lättbegripligt språk inom några sekunder. Används av mer än 2 miljoner människor världen över.
Referenser
- Klein, T., Mitchell, S. & Weber, H. (2025). Guide till blodprov för C3, C4, komplement och ANA-titer. Kantesti AI Medicinsk forskning. DOI
- Klein, T., Mitchell, S. & Weber, H. (2025). Blodprov för Nipahvirus: guide till tidig upptäckt och diagnos 2026. Kantesti AI Medicinsk forskning. DOI
- Bossuyt PM et al. (2015). STARD 2015: en uppdaterad lista över viktiga punkter för rapportering av diagnostiska noggrannhetsstudier. BMJ. DOI PubMed
- Collins GS et al. (2024). TRIPOD+AI-uttalande: uppdaterad vägledning för rapportering av kliniska prediktionsmodeller som använder regressions- eller maskininlärningsmetoder. BMJ. DOI
- Kidney Disease: Improving Global Outcomes (KDIGO) arbetsgrupp för CKD (2024). KDIGO:s riktlinje för klinisk praxis 2024 för utvärdering och behandling av kronisk njursjukdom. Kidney International. DOI
- 2 miljoner+Analyserade tester
- 127+Länder
- 100+Språk
Om det medicinska teamet


E-E-A-T förtroendesignaler
Uppleva
Läkarledd klinisk granskning av arbetsflöden för laboratorietolkning.
Expertis
Laboratoriemedicinskt fokus på hur biomarkörer beter sig i kliniskt sammanhang.
Auktoritet
Medicinskt granskad av Dr. Thomas Klein, med bidrag från Dr. Sarah Mitchell och Prof. Dr. Hans Weber.
Trovärdighet
Evidensbaserad tolkning med tydliga uppföljningsspår för att minska larm.
Medicinsk friskrivning
Den här artikeln är endast avsedd för utbildningsändamål och utgör inte medicinsk rådgivning. Rådgör alltid med en behörig vårdgivare för beslut om diagnos och behandling.
Publicerad · Uppdaterad · Kontakta redaktionen
Publicerad av Kantesti Ltd, registrerat i England och Wales, företagsnr. 17090423, London, Storbritannien.
