
Validação clínica significa testar se o software produz interpretações suficientemente precisas e seguras para os pacientes a que se destina — não simplesmente se gera relatórios convincentes.

Principais conclusões
- Escopo da validação deve identificar os pacientes a que se destina, os dados laboratoriais de entrada e as decisões clínicas; o sucesso em 1 tarefa não comprova a segurança em todos os usos.
- Denominadores de precisão devem distinguir pacientes, relatórios, biomarcadores e afirmações individuais; 10.000 afirmações podem vir de apenas 200 relatórios.
- Sensibilidade mede os casos positivos segundo o padrão de referência que foram detectados; um resultado hipotético de 90/100 significa que 10 casos afetados não foram identificados.
- Valor preditivo depende da prevalência: com prevalência de 1%, sensibilidade de 90% e especificidade de 95%, o valor preditivo positivo é de aproximadamente 15.4%.
- Testes independentes exigem dados de teste protegidos, uma versão de software congelada e a divulgação de quem projetou, financiou e julgou a avaliação.
- Evidências por subgrupo deve incluir tamanhos de amostra e incerteza; observar 0 erros de detecção entre 20 casos positivos não demonstra sensibilidade perfeita.
- Velocidade operacional de aproximadamente 60 segundos descreve nosso recurso de interpretação, não uma redução demonstrada de erros diagnósticos ou atrasos no tratamento.
- Critérios de adoção devem abranger a segurança no nível do paciente, o desempenho específico por idioma, as falhas de entrada e uma resposta documentada às alterações no software.
A ascensão da IA no diagnóstico médico: o que significa validação
Validação de exames de sangue por IA exige evidências de que uma versão especificada do software produz interpretações precisas e seguras para os pacientes e as decisões a que se destina. Os compradores devem examinar os denominadores no nível do paciente, os testes independentes, os resultados por subgrupo e o tratamento de falhas — não apenas um percentual de precisão destacado. Kantesti é um analisador de exames de sangue por IA cujos resultados devem atender aos mesmos requisitos de evidência.
O software de interpretação não mede a amostra original. Um analisador laboratorial gera valores como sódio a 138 mmol/L; em seguida, o software de interpretação lê esses valores e explica seu possível significado, criando uma segunda oportunidade para erros, mesmo quando a medição laboratorial está correta. Portanto, os compradores precisam de evidências separadas sobre a precisão da extração, o tratamento dos intervalos de referência e o raciocínio clínico.
Validade clínica e utilidade clínica respondem a perguntas diferentes. Uma avaliação pode demonstrar concordância em 500 laudos sem mostrar que os pacientes recebem melhores cuidados, evitam investigações desnecessárias ou compreendem melhor a incerteza. Nosso guia de explicação de laudos médicos explica por que uma redação compreensível ainda exige verificação da fonte e limites apropriados para o encaminhamento.
Estatísticas de adoção não substituem um estudo clínico. O alcance informado pela plataforma, de 2M+ usuários em 127+ países, descreve o uso, não uma coorte de validação representativa com desfechos confirmados. O histórico da empresa ajuda a estabelecer a responsabilização organizacional; um dossiê de evidências separado deve identificar o uso pretendido exato, a população elegível e as consequências de uma interpretação incorreta.
Alegações de precisão: conte pacientes, relatórios e decisões separadamente
Uma alegação de precisão só pode ser interpretada quando seu numerador, denominador e regras de pontuação são divulgados. Um valor como 98.49% poderia descrever campos extraídos, afirmações aceitas ou casos classificados — tarefas muito diferentes. Aqui, esse número é um exemplo de valor destacado que requer análise crítica, não um resultado de desempenho clínico verificado de forma independente.
Afirmações repetidas não são pacientes independentes. Em uma avaliação hipotética, 200 laudos com 50 afirmações pontuadas cada geram 10.000 observações no nível da afirmação, mas ainda correspondem a apenas 200 laudos. Uma explicação correta de sódio a 140 mmol/L não deve compensar uma recomendação perigosa em outra parte do mesmo laudo; exija tanto a pontuação no nível da afirmação quanto a proporção de laudos com erros de consequências clínicas.
Entradas excluídas podem inflar a confiabilidade aparente. Suponha que 1.000 laudos sejam enviados, 100 sejam rejeitados e 882 dos 900 restantes atendam aos critérios: a precisão entre os laudos concluídos é de 98%, enquanto a proporção de resultados aceitáveis obtidos entre todos os envios é de 88.2%. Nenhum dos denominadores é intrinsecamente desonesto, mas os compradores precisam de ambos, além dos motivos das rejeições e de saber se os casos rejeitados envolvem desproporcionalmente anormalidades urgentes.
A metodologia publicada deve definir o que foi considerado correto antes do início da pontuação. A declaração de relato STARD 2015 solicita que estudos de acurácia diagnóstica descrevam a seleção dos participantes, o padrão de referência e o fluxo dos participantes (Bossuyt et al., 2015). Nosso Página da metodologia de validação é um ponto de partida para perguntas sobre Kantesti; não deve ser tratado como prova de desempenho independente no nível do paciente sem os materiais subjacentes do estudo.
Sensibilidade, especificidade e valor preditivo respondem a perguntas diferentes
A sensibilidade mede a detecção entre os casos positivos segundo o padrão de referência; a especificidade mede os resultados negativos corretos entre os casos negativos segundo o padrão de referência. O valor preditivo positivo mede com que frequência um resultado positivo está correto no contexto testado. Para uma ferramenta hipotética com sensibilidade de 90% e especificidade de 95%, com prevalência de 1%, o valor preditivo positivo é de aproximadamente 15.4%.
Uma matriz de confusão torna a compensação visível. Entre 10.000 pacientes hipotéticos com prevalência de 1%, 100 têm a condição-alvo: 90 são detectados e 10 não são identificados. Dos 9.900 que não a têm, 495 recebem resultados falsos positivos; consequentemente, apenas 90 dos 585 resultados positivos estão corretos, embora a acurácia geral seja de 94.95%.
Precisão não é sinônimo universal de acurácia. Em classificação, precisão geralmente significa valor preditivo positivo, enquanto a rubrica de pontuação narrativa de um fornecedor pode usar a palavra de outra forma. Nossa discussão sobre confirmação de anticorpos com resultados fracamente positivos ilustra o princípio clínico: a interpretação depende da probabilidade pré-teste e da confirmação, não apenas de um resultado inicial que ultrapasse um limiar.
A escolha do limiar altera o equilíbrio entre casos não detectados e alarmes falsos. Solicite a matriz de confusão no limiar de implantação proposto, não apenas uma curva de desempenho que abranja muitos limiares. Em um estudo hipotético de alertas, reduzir o limiar de 0.7 para 0.4 pode melhorar a sensibilidade e, ao mesmo tempo, dobrar os alertas falsos; os compradores devem decidir se essa compensação é adequada às consequências clínicas e à capacidade de revisão.
Testes independentes precisam de um conjunto de dados protegido e de um padrão de referência confiável
Os testes independentes avaliam um modelo congelado em dados indisponíveis durante o desenvolvimento, com divulgação dos vínculos dos avaliadores e um padrão de referência clinicamente defensável. Dados externos, por si só, não garantem uma avaliação independente. Um estudo envolvendo 3 hospitais ainda pode ter rótulos enviesados, pipelines de dados compartilhados ou casos de teste que influenciaram o ajuste do modelo.
A separação no nível do paciente evita uma forma comum de vazamento de dados. Se o relatório de janeiro de um paciente for incluído no treinamento e o relatório de fevereiro do mesmo paciente for incluído no teste, o modelo pode se beneficiar de padrões recorrentes ou identificadores. Os compradores devem perguntar como foram identificados pacientes duplicados, internações repetidas e relatórios de 2 sistemas laboratoriais conectados, e se o conjunto de teste final permaneceu intocado após a seleção do modelo e dos prompts.
O padrão de referência deve corresponder à alegação. A concordância entre especialistas em 300 interpretações pode avaliar a qualidade dos relatórios, mas não confirma automaticamente a presença da doença ou resultados futuros. A distinção é conhecida na acurácia e no momento da realização do ensaio: o teste avaliado, o comparador e o momento da confirmação podem, cada um, alterar o desempenho aparente.
Benchmarks sintéticos testam casos construídos, não a prevalência da doença nem a utilidade clínica no mundo real. Nem mesmo 100,000 cenários sintéticos conseguem reproduzir todo histórico ausente, artefato de amostra ou apresentação inesperada. Para alegações envolvendo limites da interpretação da troponina, um estudo precisa das informações clínicas e do acompanhamento diagnóstico relevantes para a alegação; uma frase correta sobre um limite laboratorial não é um diagnóstico confirmado.
O desempenho por subgrupo pode revelar riscos ocultos pela média
Os testes de validação de subgrupos verificam se o desempenho varia entre grupos de pacientes e condições de entrada clinicamente relevantes. Os compradores devem solicitar denominadores, gravidade dos erros e intervalos de confiança para crianças, idosos, gestantes, pessoas com insuficiência renal e outras populações-alvo. Observar 0 casos não identificados entre 20 casos positivos de referência deixa uma incerteza substancial quanto à verdadeira taxa de casos não identificados.
Os intervalos de referência específicos por idade não são intercambiáveis. Uma interpretação pediátrica não pode herdar com segurança todos os limites para adultos, mesmo quando o analito e a unidade subjacentes são idênticos. Nosso guia sobre Interpretação de IA para crianças explica o limite de segurança; os compradores devem solicitar as contagens reais por faixa etária, em vez de aceitar uma alegação abrangente que cubra pacientes de 1 a 18 anos.
O contexto biológico importa mais do que atalhos demográficos. Uma contagem absoluta de neutrófilos de 1.2 × 10^9/L pode exigir um raciocínio diferente no caso de uma pessoa estável com contagem associada à ausência de Duffy do que no de alguém com uma queda recente durante o tratamento. O explicação sobre neutrófilos Duffy-null dá suporte a um caso de teste direcionado; a ancestralidade, por si só, não deve ser usada para presumir genótipo ou segurança clínica.
Amostras pequenas podem ocultar taxas de falha clinicamente significativas. A regra aproximada dos três significa que 0 eventos observados em 20 observações independentes correspondem a um limite superior de 95% próximo de 15%, não de 0%. As comparações entre subgrupos também exigem análise agrupada por paciente quando os relatórios são repetidos; um estudo deve informar quais grupos não foram testados, em vez de tratar uma diferença não significativa como prova de equivalência de desempenho.
O suporte multilíngue precisa de testes de segurança específicos para cada idioma
A validação multilíngue verifica se o significado clínico é preservado na tradução, na formatação numérica e na explicação voltada ao paciente em cada idioma pretendido. Kantesti é uma plataforma de interpretação de exames de sangue com IA, com suporte para 100+ idiomas; essa capacidade, por si só, não comprova desempenho clínico equivalente nesses idiomas. Cada idioma precisa de uma estratégia de avaliação adequada e de cobertura divulgada.
As convenções decimais podem alterar o valor interpretado. Um resultado de glicose escrito como 5,6 mmol/L em uma localidade não deve se tornar 56 mmol/L após a extração, e a conversão de unidades deve preservar o significado clínico, em vez de apenas substituir a pontuação. Avalie separadamente as entradas no idioma original e as saídas traduzidas; testar apenas laudos laboratoriais em inglês traduzidos para 10 idiomas não detecta erros na entrada.
A negação e o tipo de resultado merecem casos de teste específicos. Afirmações como não detectado, abaixo do limite de quantificação e não é possível excluir comunicam diferentes graus de certeza. Nosso guia qualitativo versus quantitativo explica a distinção; uma rubrica de revisão bilíngue deve testar esses significados, incluindo símbolos de desigualdade como menor que 0.1, em vez de avaliar apenas a fluência do texto.
A legibilidade não garante a compreensão. Uma avaliação linguística útil poderia pedir aos participantes que identifiquem a ação necessária e a incerteza após lerem 3 relatórios curtos, registrando também se a tradução altera a urgência ou as recomendações sobre medicamentos. Essas são tarefas de avaliação propostas, não um limite universal validado; idiomas com menos recursos podem exigir revisão adicional, pois a terminologia clínica disponível e a cobertura de treinamento são diferentes.
A integração de API e os formatos de relatório devem preservar o significado clínico
A validação da integração verifica se a identidade do paciente, os valores, as unidades, as datas e os avisos permanecem corretos entre os limites dos sistemas. As saídas em HTML, JSON e PDF devem comunicar o mesmo conteúdo clínico quando esses formatos forem compatíveis. O significado de um resultado de sódio de 128 mmol/L não deve mudar porque uma saída omite um aviso ou outra trunca um campo.
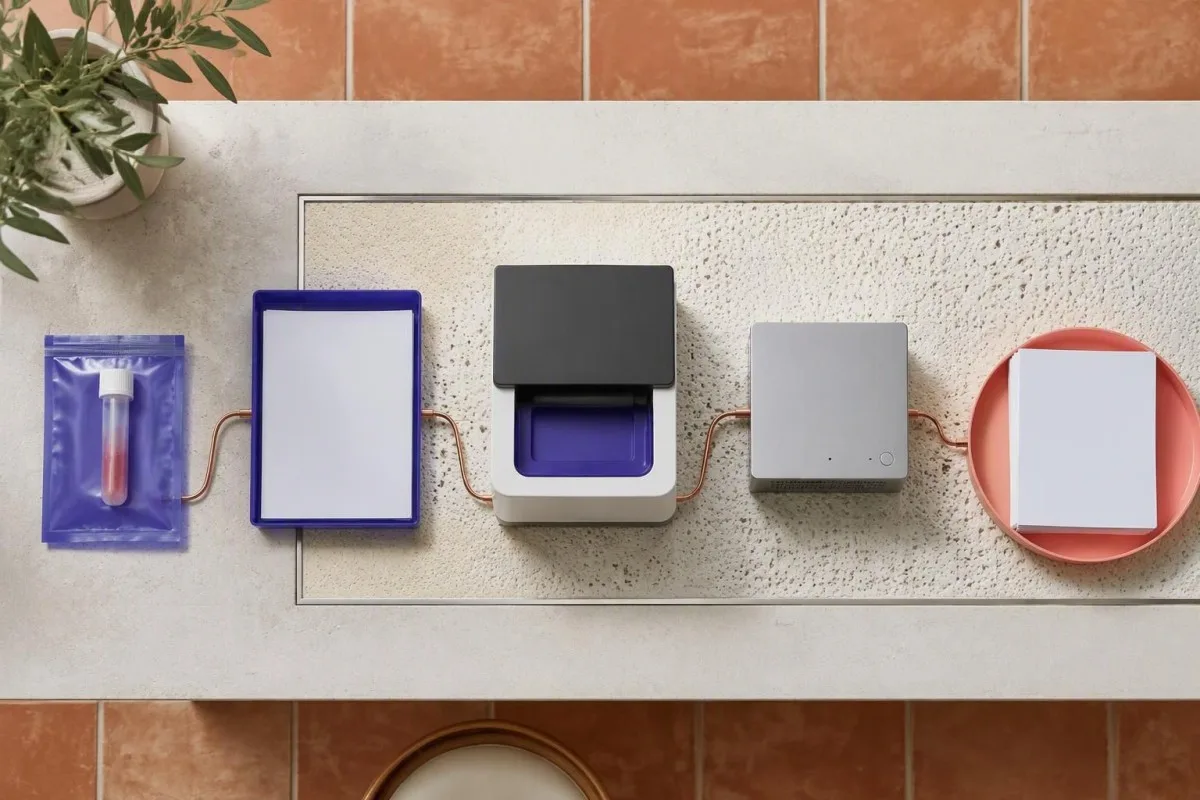
Uma conexão funcional à API não é uma integração clínica validada. Nossa API B2B exige verificações específicas da implantação para mapeamento, autenticação, tratamento de respostas e comportamento das versões; a compatibilidade com EHR ou LIS deve ser demonstrada para a interface efetivamente utilizada. Teste pelo menos 3 classes de falha — unidades ausentes, identificadores de pacientes incompatíveis e respostas duplicadas com atraso — em vez de aceitar uma única solicitação de demonstração bem-sucedida.
Valores derivados exigem entradas explícitas e rastreabilidade da fórmula. O sódio corrigido, por exemplo, depende do sódio medido, da glicose e do método de correção; diferentes coeficientes publicados podem gerar estimativas distintas. Nosso guia de correção do sódio relacionada à glicose fornece um caso de teste clínico, mas os compradores devem verificar se a glicose em mg/dL nunca é tratada como mmol/L e se qualquer cálculo declara suas premissas.
A concordância de formato deve incluir o significado, não apenas o layout. Em um teste hipotético de exportação de 300 relatórios, o JSON pode preservar um sinalizador crítico enquanto um modelo de PDF o oculta abaixo de uma quebra de página. Compare as recomendações clínicas, a incerteza, as unidades e os horários entre os formatos de saída compatíveis; mantenha os valores brutos rastreáveis à fonte e especifique se um campo ausente gera uma rejeição segura ou uma interpretação sem respaldo.
Relatórios rápidos e uma interface amigável ainda precisam de evidências de fatores humanos
Velocidade e usabilidade são benefícios operacionais, não evidências diretas de precisão diagnóstica. Nosso recurso de interpretação normalmente gera uma explicação em aproximadamente 60 segundos, mas a implantação clínica deve medir o atraso de ponta a ponta, as solicitações com falha e a carga de revisão. O tempo mediano de processamento, por si só, não demonstra se os resultados urgentes chegam à pessoa certa com segurança.
A latência deve ser informada como uma distribuição. Solicite a mediana, o percentil 95 e a taxa de tempo limite sob uso simultâneo realista, incluindo arquivos grandes e fotografias de baixa qualidade. Uma mediana hipotética de 45 segundos, com percentil 95 de 240 segundos, descreve um serviço muito diferente de outro que conclui consistentemente perto de 60 segundos; nenhum dos valores comprova que o tratamento seja iniciado mais cedo.
Padrões laboratoriais urgentes exigem apresentação e escalonamento testados. Um resultado de potássio de 6.5 mmol/L pode indicar uma emergência médica, embora a qualidade da amostra e o contexto clínico afetem a interpretação. Nosso guia de urgências eletrolíticas auxilia na elaboração de cenários; pacientes com um alerta laboratorial urgente devem entrar em contato prontamente com o serviço responsável pelo tratamento, em vez de esperar por uma explicação do aplicativo, especialmente quando houver sintomas.
Os testes de fatores humanos avaliam o que os usuários fazem com o relatório. No acesso pela web, iOS, Android e extensões, os compradores devem avaliar pelo menos 3 tarefas: encontrar o valor original, reconhecer a incerteza e identificar a próxima ação adequada. Registre também as ações incorretas, além do tempo de conclusão, porque uma interface refinada pode aumentar a confiança em uma recomendação sem respaldo e dificultar a percepção do viés de automação.
As evidências de segurança e privacidade devem acompanhar a validação clínica
A avaliação de privacidade verifica como as informações laboratoriais sensíveis são coletadas, processadas, retidas, compartilhadas e excluídas. O tratamento alinhado ao GDPR é uma abordagem declarada, não um substituto para evidências contratuais e técnicas. Para Kantesti Ltd, empresa britânica nº 17090423, os compradores devem estabelecer a relação e as responsabilidades aplicáveis entre controlador e operador antes de enviar sequer 1 relatório identificável.
As informações de saúde exigem mais do que a remoção de um nome. Um relatório pode conter um código de barras, uma data de nascimento exata, um número de acesso ou detalhes narrativos que identifiquem alguém quando combinados com outras informações. Nosso precauções de privacidade para uploads explique a minimização prática; um comprador deve avaliar pelo menos 3 camadas separadamente: conteúdo dos arquivos, metadados da conta e registros operacionais.
As alegações de segurança precisam de um escopo definido e de uma data de referência das evidências. Analise os acordos de criptografia, os controles de acesso, as listas de subprocessadores, os termos de notificação de incidentes e as configurações de retenção na documentação de privacidade de dados. Se um fornecedor citar uma auditoria, pergunte a qual serviço e período de controle ela se aplica; um relatório que abrange 1 componente da infraestrutura não avalia automaticamente o acesso ao aplicativo clínico ou o tratamento de dados do modelo.
A implantação internacional cria obrigações adicionais. O uso em países 127+ não significa que um único contrato ou fundamento jurídico abranja todas as jurisdições, e o alinhamento ao GDPR não implica aplicabilidade da HIPAA nem conformidade com seus requisitos. Para recursos familiares, teste os limites das permissões usando 2 contas separadas, incluindo a revogação de acesso e a recuperação da conta; é necessária uma resposta explícita sobre se a exclusão de um relatório também remove os backups e os registros.
O mecanismo de IA: valide previsões e recomendações separadamente
Um mecanismo de IA precisa de validação específica para cada alegação relacionada à interpretação de padrões, à previsão de riscos futuros e às recomendações personalizadas. São tarefas diferentes, mesmo quando geradas em 1 relatório. A arquitetura de aprendizado profundo e a análise multiparamétrica descrevem como um sistema funciona; elas não provam que suas estimativas de probabilidade, sugestões diagnósticas ou orientações dietéticas sejam clinicamente confiáveis.
A interpretação multiparamétrica deve preservar explicações concorrentes. Em um relatório hipotético com ferritina de 40 ng/mL e CRP de 20 mg/L, a ferritina, por si só, não pode determinar a disponibilidade de ferro, pois pode aumentar em resposta a uma reação de fase aguda. Os compradores que avaliam a rede neural de Kantesti devem usar casos sensíveis a esse contexto, enquanto o explicação da tecnologia permanece distinto das evidências de que uma conclusão clínica específica está correta.
A previsão de riscos requer um desfecho e um horizonte temporal definidos. Uma probabilidade de 20% é ininterpretável sem especificar o que pode acontecer, com quem e ao longo de qual período — por exemplo, hospitalização em 30 dias, em vez do início de uma doença em 5 anos. O TRIPOD+AI recomenda a apresentação transparente de estudos de modelos de previsão (Collins et al., 2024); a calibração e a validação externa são importantes, inclusive para a análise de tendências relacionadas a medicamentos.
O aconselhamento personalizado cria uma obrigação de segurança distinta. Uma recomendação nutricional pode ser inadequada quando faltam informações sobre a função renal, os medicamentos ou a gravidez; o Risco de Saúde Familiar também exige um tratamento claro de históricos incertos ou autorrelatados. Nossa guia de segurança nutricional renal oferece cenários de teste pertinentes, mas aceitar um plano alimentar de 3 itens não comprova que ele melhora os desfechos ou substitui com segurança uma avaliação dietética individualizada.
Como funciona a interpretação exame de sangue por IA: uma lista de verificação de validação para compradores
Um comprador deve testar toda a sequência: captura da fonte, normalização, interpretação contextual, geração do relatório e revisão clínica. Avalie cada etapa separadamente antes de testar o sistema integrado. Um plano de aceitação em 5 etapas facilita identificar se um resultado inseguro teve origem em um valor lido incorretamente, em uma suposição errada ou em uma recomendação inadequada.
Comece definindo o uso pretendido e congelando a versão avaliada. A etapa 1 consiste em um inventário escrito de alegações e riscos; a etapa 2, em um conjunto de dados representativo e bloqueado, com critérios de elegibilidade e rótulos de referência predefinidos. Em seguida, a captura de PDFs ou fotos deve ser testada com layouts alterados, convenções decimais e campos ilegíveis; documente as recusas, em vez de excluí-las silenciosamente do denominador final.
Em seguida, teste o contexto e as suposições longitudinais. A etapa 3 verifica as unidades, os intervalos de referência e os metadados; a etapa 4 pontua interpretações e recomendações usando categorias de gravidade clinicamente significativas. Nosso guia sobre alterações entre as visitas ao laboratório fundamenta um desafio útil: uma alteração da creatinina de 80 para 100 µmol/L exige considerar o momento, a variação do ensaio e o paciente, e não declarar automaticamente uma deterioração.
Conclua com uma decisão de implementação, não com um slogan sobre precisão. A etapa 5 avalia o uso prospectivo local e o tratamento de falhas em relação a critérios acordados antes da análise dos resultados, incluindo limites de incerteza e procedimentos de escalonamento. Solicite um dossiê contendo o fluxo da coorte, a versão do modelo, a rubrica completa de pontuação, tabelas de subgrupos, exemplos de resultados adversos e regras de controle de alterações; nenhum percentual universal pode substituir limites de aceitação ajustados às consequências dos erros.
Relatórios de exemplo e depoimentos: separe ilustração de evidências
Um relatório de exemplo demonstra a apresentação e o raciocínio, enquanto um depoimento descreve uma impressão individual. Nenhum dos dois comprova a precisão em nível de paciente ou o benefício clínico. Considere um adulto de 52 anos claramente hipotético, com creatinina de 118 µmol/L, eGFR relatada de 58 mL/min/1,73 m² e sem resultados anteriores disponíveis: a explicação segura deve preservar a incerteza.
Um único eGFR reduzido não estabelece doença renal crônica. A KDIGO define doença renal crônica como anormalidades da estrutura ou função renal presentes por pelo menos 3 meses; um eGFR abaixo de 60 mL/min/1,73 m² requer avaliação da cronicidade e do contexto (KDIGO CKD Work Group, 2024). Neste exemplo hipotético, um relatório deve sugerir avaliação médica e acompanhamento adequado, não diagnosticar dano renal permanente com base em um único resultado.
As estimativas baseadas na creatinina podem ser menos informativas em casos de composição corporal atípica. Se a pessoa hipotética for muito musculosa ou tiver alterado recentemente o uso de suplementos, a interpretação deve reconhecer esses fatores, em vez de descartar o resultado. Nossa discussão sobre creatinina em adultos musculosos oferece contexto; a KDIGO recomenda a estimativa combinada de creatinina e cistatina C, quando disponível, para a avaliação adequada de adultos com doença renal crônica, em vez de presumir que a estimativa inicial seja definitiva.
As demonstrações devem incluir dados difíceis e resultados desfavoráveis. Acrescente um resultado de potássio hipotético separado de 6.0 mmol/L com um problema sinalizado na amostra, usando nossas limitações dos resultados relacionadas à hemólise para explicar por que tanto a confirmação quanto a urgência devem ser consideradas. Para Kantesti, uma avaliação útil é uma comparação cega de relatórios completos; depoimentos de profissionais, quando apresentados com consentimento, continuam sendo relatos baseados em experiências, e não substitutos desses testes.
Abraçando o futuro do diagnóstico: adoção baseada em evidências
Adote a interpretação por IA apenas para os usos respaldados por evidências, com supervisão local e uma resposta a erros documentada. Kantesti é uma ferramenta de análise de exames de sangue com IA; nosso conjunto de funcionalidades deve ser avaliado segundo os mesmos padrões de aquisição descritos aqui. Começar com 1 caso de uso limitado é mais seguro do que presumir que as evidências se aplicam a todos os pacientes e recomendações.
Uma introdução em etapas deve distinguir viabilidade de eficácia. Uma avaliação paralela hipotética de 100 relatórios pode revelar falhas de integração e problemas comuns de redação sem expor pacientes a recomendações não revisadas, mas é improvável que estabeleça uma baixa taxa de erros graves raros. Uma avaliação prospectiva mais ampla precisa de uma justificativa para o tamanho da amostra e de desfechos alinhados à alegação real, incluindo acompanhamentos desnecessários e preocupações não detectadas.
Alterações no software podem modificar o desempenho medido anteriormente. Um novo modelo, prompt, banco de dados de intervalos de referência ou modelo de relatório pode alterar os resultados mesmo quando o nome do produto permanece o mesmo; registre todas as 4 categorias no histórico de implementação. Monitore a gravidade dos erros, as abstenções, a deriva entre subgrupos e as substituições feitas pelos usuários, e defina quando uma alteração exige testes de regressão direcionados, uma nova avaliação local ou a suspensão de uma função específica.
A decisão de adoção deve se basear em uma análise documentada das lacunas de evidências. Identifique o que foi estabelecido de forma independente, o que é respaldado apenas por testes técnicos e o que ainda não foi testado; depois, designe um responsável por cada risco não resolvido. Nosso canal de contato do comprador da área da saúde é o local adequado para solicitar documentação específica do escopo — prefira uma alegação mais restrita e fundamentada a uma chamada 99% com denominador pouco claro.
Publicações de pesquisa: diferencie guias educativos de estudos de validação
As 2 referências DOI do repositório abaixo identificam guias educacionais, não estudos de validação clínica de software de interpretação por IA. Um DOI fornece um identificador persistente; não comprova revisão por pares, recrutamento de pacientes, avaliação independente ou eficácia clínica. Os compradores devem classificar cada publicação citada conforme a pergunta que ela pode de fato responder.
Guias educacionais podem ajudar a elaborar critérios de validação sem validar os próprios produtos. Nosso guia do complemento e do ANA pode orientar casos em que 2 medidas do complemento e o contexto dos anticorpos precisam de explicação cuidadosa. A concordância com um guia não equivale à concordância com desfechos de pacientes adjudicados independentemente, sobretudo quando o guia e o software avaliado compartilham uma fonte organizacional.
Guias sobre o momento do diagnóstico abordam outro modo de falha relevante. Nosso guia de teste diagnóstico Nipah discute um contexto diagnóstico especializado; não deve ser usado para sugerir que a interpretação laboratorial de rotina identifica um vírus específico. Se um comprador incluir mesmo que seja 1 alegação sobre patógenos de alta gravidade no uso previsto, essa alegação precisa de evidências diagnósticas relevantes próprias e de limites adequados para encaminhamento.
Os padrões de relato de estudos apoiam a avaliação, em vez de certificar o desempenho. O STARD 2015 contém 30 itens de relato para pesquisas de acurácia diagnóstica, enquanto o TRIPOD+AI aborda o relato de modelos de predição; nenhuma das listas de verificação confere ao software um selo de aprovação clínica. As referências abaixo distinguem essas fontes metodológicas e a diretriz KDIGO de 2024 das 2 entradas de DOI educacionais, para que os leitores possam diferenciar recomendações clínicas, orientações para relato e evidências específicas do produto.
Perguntas frequentes
O que é a validação clínica de software de IA para exames de sangue?
0 A validação clínica avalia se uma versão específica do software de análise de exames de sangue com IA produz resultados suficientemente precisos e seguros para os pacientes e as decisões a que se destina. Deve separar pelo menos 3 tarefas: leitura do laudo original, interpretação do significado clínico e recomendação de uma ação. As evidências devem descrever o padrão de referência, o tamanho da amostra no nível do paciente, os testes independentes e o tratamento das falhas. Uma explicação tecnicamente correta não comprova, por si só, a melhora dos resultados dos pacientes.
A precisão de 99% é suficiente para confiar em um analisador de exames de sangue com IA?
Uma alegação de precisão de 99% não pode comprovar a segurança sem o denominador, a definição da tarefa e a gravidade dos erros. Em um grupo hipotético em que apenas 1% têm uma condição-alvo, um software que classifica todos como negativos alcança uma precisão de 99% sem detectar nenhum dos pacientes afetados. Os compradores devem solicitar sensibilidade, especificidade, erros nos relatórios em nível de paciente e o número de entradas rejeitadas. Recomendações raras, mas perigosas, não devem desaparecer em uma média dominada por afirmações fáceis.
Qual é a diferença entre um benchmark sintético e a validação clínica?
Um benchmark sintético avalia o software em casos construídos, enquanto a validação clínica exige evidências adequadas à população de pacientes pretendida e à alegação clínica. Mesmo 100.000 casos sintéticos não podem estabelecer a prevalência no mundo real, o benefício clínico ou o desempenho diante de todos os problemas de histórico ausente e qualidade da amostra. Os testes sintéticos podem ajudar a identificar falhas técnicas e apoiar verificações de regressão. Devem complementar, e não substituir, avaliações externas e prospectivas representativas.
De quantos testes independentes a IA na área da saúde precisa?
0. A IA na saúde precisa de testes independentes proporcionais às consequências de um resultado incorreto, não de um número mínimo universal de relatórios. Observar 0 falhas em 100 casos independentes deixa um limite superior aproximado de 95% para a taxa de falhas, próximo de 3%, usando a regra de três. Os compradores devem solicitar dados de teste protegidos, uma versão congelada do modelo e a divulgação das relações dos avaliadores. Alegações sobre erros graves raros geralmente precisam de mais evidências do que um pequeno estudo-piloto de usabilidade ou viabilidade pode fornecer.
O suporte a 100 idiomas significa a mesma precisão em todos os idiomas?
0 Suporte para 100 idiomas não comprova precisão clínica equivalente em todos eles. A avaliação específica por idioma deve testar a extração de dados de entrada, as convenções de decimais, as unidades, a negação e o significado das recomendações. Por exemplo, uma glicose indicada como 5,6 mmol/L não deve ser interpretada como 56 mmol/L. Os compradores devem solicitar denominadores específicos por idioma e informar quais idiomas não foram submetidos a uma revisão clínica.
A IA pode diagnosticar doença renal crônica com base em um único resultado baixo de eGFR?
Um resultado de eGFR abaixo de 60 mL/min/1.73 m², por si só, não estabelece doença renal crônica. A diretriz KDIGO de 2024 define a doença renal crônica por alterações renais presentes por pelo menos 3 meses, com avaliação da cronicidade e do contexto clínico. Alterações agudas, composição corporal e outros fatores podem afetar a interpretação. O software de IA deve explicar a incerteza e apoiar o acompanhamento clínico, em vez de classificar uma única estimativa reduzida como doença permanente.
Entenda os resultados do seu exame de sangue
Envie o laudo do seu exame, e a IA da Kantesti explica cada biomarcador em linguagem simples em segundos. Usada por mais de 2 milhões de pessoas em todo o mundo.
Referências
- Klein, T., Mitchell, S. e Weber, H. (2025). Guia sobre exame de sangue de C3 e C4 e título de ANA. Pesquisa médica com IA da Kantesti. DOI
- Klein, T., Mitchell, S. e Weber, H. (2025). Exame de sangue para o vírus Nipah: guia de detecção precoce e diagnóstico 2026. Pesquisa médica com IA da Kantesti. DOI
- Bossuyt PM et al. (2015). STARD 2015: uma lista atualizada de itens essenciais para relatar estudos de acurácia diagnóstica. BMJ. DOI PubMed
- Collins GS et al. (2024). Declaração TRIPOD+AI: orientações atualizadas para relatar modelos de predição clínica que utilizam métodos de regressão ou aprendizado de máquina. BMJ. DOI
- Grupo de Trabalho de Doença Renal Crônica da Kidney Disease: Improving Global Outcomes (KDIGO) (2024). Diretriz de Prática Clínica KDIGO 2024 para a avaliação e o manejo da doença renal crônica. Kidney International. DOI
- 2 milhões+Exames analisados
- 127+Países
- 100+Idiomas
Sobre a equipe médica


Sinais de confiança E-E-A-T
Experiência
Revisão clínica orientada por médicos dos fluxos de interpretação de exames laboratoriais.
Especialização
Foco em medicina laboratorial sobre como os biomarcadores se comportam no contexto clínico.
Autoridade
Revisado clinicamente pelo Dr. Thomas Klein, com contribuições da Dra. Sarah Mitchell e do Prof. Dr. Hans Weber.
Confiabilidade
Interpretação baseada em evidências, com caminhos de acompanhamento claros para reduzir alarmes.
Aviso médico
Este artigo é apenas para fins educacionais e não constitui aconselhamento médico. Consulte sempre um profissional de saúde qualificado para decisões de diagnóstico e tratamento.
Publicado · Atualizado · Entre em contato com a equipe editorial
Publicado por Kantesti Ltd, registrado na Inglaterra e no País de Gales, número da empresa. 17090423, Londres, Reino Unido.
