
Klinisk validering betyr å teste om programvaren produserer tilstrekkelig nøyaktige og trygge tolkninger for de tiltenkte pasientene – ikke bare om den genererer overbevisende rapporter.

Viktige punkter
- Valideringsomfang må identifisere de tiltenkte pasientene, laboratorieinputtene og kliniske beslutningene; vellykket utførelse av 1 oppgave kan ikke fastslå sikkerhet på tvers av all bruk.
- Nevner for nøyaktighet bør skille mellom pasienter, rapporter, biomarkører og enkeltstående utsagn; 10 000 utsagn kan stamme fra bare 200 rapporter.
- Sensitivity måler påviste referansepositive tilfeller; et hypotetisk resultat på 90/100 betyr at 10 berørte tilfeller ikke ble oppdaget.
- Prediktiv verdi avhenger av prevalensen: Ved en prevalens på 1% gir en sensitivitet på 90% og en spesifisitet på 95% en positiv prediktiv verdi på omtrent 15.4%.
- Uavhengig testing krever beskyttede testdata, en fryst programvareversjon og opplysninger om hvem som utformet, finansierte og vurderte evalueringen.
- Dokumentasjon for undergrupper må inkludere utvalgsstørrelser og usikkerhet; å observere 0 oversette tilfeller blant 20 positive tilfeller fastslår ikke perfekt sensitivitet.
- Operasjonell hastighet på omtrent 60 sekunder beskriver vår tolkningsfunksjon, ikke en påvist reduksjon i diagnostiske feil eller forsinkelser i behandlingen.
- Kriterier for innføring bør omfatte sikkerhet på pasientnivå, ytelse for hvert språk, inndatafeil og en dokumentert respons på programvareendringer.
Fremveksten av KI i medisinsk diagnostikk: Hva validering innebærer
Validering av AI-blodprøver krever dokumentasjon på at en spesifisert programvareversjon gir nøyaktige og trygge tolkninger for de tiltenkte pasientene og beslutningene. Kjøpere bør undersøke nevnerne på pasientnivå, uavhengig testing, resultater for undergrupper og håndtering av feil – ikke bare en overskrift med en nøyaktighetsprosent. Kantesti er en AI-blodprøveanalysator, og resultatene bør underlegges de samme dokumentasjonskravene.
Tolkningsprogramvare måler ikke den opprinnelige prøven. En laboratorieanalysator genererer verdier som natrium på 138 mmol/L; tolkningsprogramvaren leser deretter disse verdiene og forklarer hva de kan bety, noe som skaper en ny mulighet for feil selv når laboratoriemålingen er korrekt. Kjøpere trenger derfor separat dokumentasjon på nøyaktighet ved datauttrekk, håndtering av referanseområder og klinisk resonnering.
Klinisk validitet og klinisk nytte besvarer forskjellige spørsmål. En evaluering kan vise samsvar i 500 rapporter uten å vise at pasienter får bedre behandling, unngår unødvendige undersøkelser eller forstår usikkerhet mer presist. Vår veiledning til forklaring av medisinske rapporter forklarer hvorfor forståelig ordlyd fortsatt krever kontroll mot kilden og passende grenser for eskalering.
Adopsjonsstatistikk kan ikke erstatte en klinisk studie. Plattformens rapporterte rekkevidde på 2M+ brukere i 127+ land beskriver bruk, ikke en representativ valideringskohort med bekreftede utfall. Den selskapsbakgrunn bidrar til å etablere organisatorisk ansvarlighet; en separat dokumentasjonspakke må angi nøyaktig tiltenkt bruk, kvalifisert populasjon og konsekvensene av en feilaktig tolkning.
Påstander om nøyaktighet: Tell pasienter, rapporter og beslutninger separat
En påstand om nøyaktighet kan bare tolkes når teller, nevner og poengsettingsregler oppgis. Et tall som 98.49% kan beskrive uttrekkede felter, godkjente utsagn eller klassifiserte tilfeller – svært forskjellige oppgaver. Her er tallet et eksempel på en overskrift som krever nærmere granskning, ikke et uavhengig verifisert resultat for klinisk ytelse.
Gjentatte utsagn er ikke uavhengige pasienter. I en hypotetisk evaluering gir 200 rapporter med 50 poengsatte utsagn hver 10 000 observasjoner på utsagnsnivå, men fortsatt bare 200 rapporter. En korrekt forklaring av natrium på 140 mmol/L bør ikke oppveie en farlig anbefaling et annet sted i samme rapport; krev både poengsetting på utsagnsnivå og andelen rapporter med klinisk betydningsfulle feil.
Utelatte inndata kan blåse opp den tilsynelatende påliteligheten. Anta at 1 000 rapporter sendes inn, 100 avvises, og 882 av de resterende 900 oppfyller kriteriene: nøyaktigheten blant fullførte rapporter er 98%, mens andelen innsendte rapporter med et godkjent resultat er 88.2%. Ingen av nevnerne er i seg selv uredelig, men kjøpere trenger begge, i tillegg til årsakene til avvisning og om avviste tilfeller uforholdsmessig ofte omfatter akutte avvik.
Publisert metodikk bør definere hva som regnes som korrekt før poengsettingen begynner. STARD 2015-rapporteringsstandarden ber studier av diagnostisk nøyaktighet beskrive deltakerutvelgelse, referansestandarden og deltakerflyten (Bossuyt et al., 2015). Vår valideringsmetodikk-side er et utgangspunkt for spørsmål om Kantesti; den bør ikke betraktes som bevis på uavhengig ytelse på pasientnivå uten det underliggende studiematerialet.
Sensitivitet, spesifisitet og prediktiv verdi besvarer ulike spørsmål
Sensitivitet måler deteksjon blant referansepositive tilfeller; spesifisitet måler korrekte negative resultater blant referansenegative tilfeller. Positiv prediktiv verdi måler hvor ofte et positivt resultat er korrekt i den testede konteksten. For et hypotetisk verktøy med 90% sensitivitet og 95% spesifisitet ved 1% prevalens er positiv prediktiv verdi omtrent 15.4%.
En forvekslingsmatrise synliggjør avveiningen. Blant 10 000 hypotetiske pasienter ved 1% prevalens har 100 måltilstanden: 90 blir oppdaget og 10 oversett. Av de 9 900 som ikke har den, får 495 falskt positive resultater; dermed er bare 90 av 585 positive resultater korrekte, selv om den samlede nøyaktigheten er 94.95%.
Presisjon er ikke et universelt synonym for nøyaktighet. I klassifisering betyr presisjon vanligvis positiv prediktiv verdi, mens en leverandørs vurderingsrubrikk for tekst kan bruke ordet annerledes. Vår diskusjon av bekreftelse av lave antistoffnivåer illustrerer det kliniske prinsippet: tolkningen avhenger av sannsynligheten før testen og bekreftelse, ikke bare av om et innledende resultat overskrider en grenseverdi.
Valg av grenseverdi endrer balansen mellom oversette tilfeller og falske alarmer. Be om forvekslingsmatrisen ved den foreslåtte grenseverdien for bruk, ikke bare en ytelseskurve som dekker mange grenseverdier. I en hypotetisk studie av varsling kan senking av en grenseverdi fra 0.7 til 0.4 forbedre sensitiviteten samtidig som antallet falske varsler dobles; kjøpere må avgjøre om denne avveiningen passer med de kliniske konsekvensene og kapasiteten for gjennomgang.
Uavhengig testing krever et beskyttet datasett og en troverdig referansestandard
Uavhengig testing evaluerer en fryst modell på data som ikke var tilgjengelige under utviklingen, med oppgitte relasjoner til evaluatorene og en klinisk forsvarlig referansestandard. Eksterne data alene garanterer ikke en uavhengig evaluering. En studie som omfatter 3 sykehus kan fortsatt ha skjeve etiketter, delte datapipelines eller testtilfeller som påvirket justeringen av modellen.
Separasjon på pasientnivå forhindrer en vanlig form for datalekkasje. Hvis en pasients rapport fra januar inngår i treningsdataene og rapporten fra februar inngår i testdataene, kan modellen dra nytte av tilbakevendende mønstre eller identifikatorer. Kjøpere bør spørre hvordan dupliserte pasienter, gjentatte innleggelser og rapporter fra 2 tilknyttede laboratoriesystemer ble identifisert, og om det endelige testsettet forble urørt etter valg av modell og prompt.
Referansestandarden må samsvare med påstanden. Ekspertvurdering av 300 tolkninger kan vurdere rapportkvalitet, men bekrefter ikke automatisk sykdomstilværelse eller fremtidige utfall. Skillet er kjent fra testnøyaktighet og tidspunkt: testen som evalueres, sammenligningsgrunnlaget og tidspunktet for bekreftelse kan hver for seg endre den tilsynelatende ytelsen.
Syntetiske referansetester prøver konstruerte tilfeller, ikke prevalens av sykdom eller klinisk nytte i den virkelige verden. Selv 100 000 syntetiske scenarioer kan ikke gjenskape alle manglende sykehistorier, artefakter i prøvemateriale eller uventede presentasjoner. For påstander som gjelder begrensninger ved tolkning av troponin, en studie trenger den kliniske informasjonen og den diagnostiske oppfølgingen som er relevant for påstanden; en korrekt setning om en laboratoriegrense er ikke en bekreftet diagnose.
Ytelse i undergrupper kan avdekke risikoer som skjules av gjennomsnittet
Undergruppevalidering tester om ytelsen endres på tvers av klinisk relevante pasientgrupper og inndataforhold. Kjøpere bør be om nevnerverdier, alvorlighetsgrad for feil og konfidensintervaller for barn, eldre, gravide, personer med nedsatt nyrefunksjon og andre tiltenkte populasjoner. At man observerer 0 oversette tilfeller blant 20 referansepositive tilfeller, gir betydelig usikkerhet om den faktiske andelen oversette tilfeller.
Aldersspesifikke referanseintervaller kan ikke brukes om hverandre. En pediatrisk tolkning kan ikke trygt arve alle voksengrenser, selv når den underliggende analytten og enheten er identiske. Vår veiledning om AI-tolkning for barn forklarer sikkerhetsgrensen; kjøpere bør be om faktiske antall i aldersgrupper i stedet for å godta en bred påstand som omfatter pasienter fra 1 til 18 år.
Biologisk kontekst er viktigere enn demografiske snarveier. Et absolutt nøytrofiltall på 1.2 × 10^9/L kan kreve en annen vurdering hos en stabil person med et Duffy-null-assosiert antall enn hos noen med en ny nedgang under behandling. Den forklaring av Duffy-null-nøytrofiler støtter en målrettet testsak; etnisitet alene må ikke brukes til å anta genotype eller klinisk sikkerhet.
Små utvalg kan skjule klinisk betydningsfulle feilrater. Den omtrentlige tre-regelen innebærer at 0 observerte hendelser i 20 uavhengige observasjoner tilsvarer en øvre grense på nær 15% for 95%, ikke 0%. Sammenligninger mellom undergrupper krever også pasientgruppert analyse når rapporter gjentas; en studie bør opplyse om uprøvde grupper i stedet for å behandle en ikke-signifikant forskjell som bevis på at ytelsen er tilsvarende.
Flerspråklig støtte krever sikkerhetstesting spesifikk for hvert språk
Flerspråklig validering undersøker om den kliniske betydningen bevares gjennom oversettelse, numerisk formatering og pasientrettet forklaring på hvert tiltenkt språk. Kantesti er en AI-plattform for tolkning av blodprøver med støtte for 100+ språk; denne egenskapen fastslår ikke i seg selv tilsvarende klinisk ytelse på tvers av språkene. Hvert språk trenger en egnet evalueringsstrategi og oppgitt dekning.
Desimalkonvensjoner kan endre den tolkede verdien. Et glukoseresultat skrevet som 5,6 mmol/L i én lokal innstilling må ikke bli til 56 mmol/L etter uthenting, og en enhetskonvertering må bevare klinisk betydning i stedet for bare å erstatte tegnsetting. Evaluer inndata på originalspråket og oversatte utdata hver for seg; testing kun av engelske laboratorierapporter oversatt til 10 språk overser feil på inndatasiden.
Negasjon og resultattype fortjener egne testsaker. Utsagn som ikke påvist, under kvantifiseringsgrensen og kan ikke utelukke uttrykker ulike grader av sikkerhet. Vår kvalitativ versus kvantitativ veiledning forklarer forskjellen; en tospråklig vurderingsrubrikk bør teste disse betydningene, inkludert ulikhetssymboler som mindre enn 0.1, i stedet for bare å belønne flytende formuleringer.
Lesbarhet garanterer ikke forståelse. En nyttig språkevaluering kan be deltakerne identifisere nødvendig handling og usikkerhet etter å ha lest 3 korte rapporter, samtidig som man registrerer om oversettelsen endrer hastegrad eller legemiddelråd. Dette er foreslåtte evalueringsoppgaver, ikke en validert universell grense; språk med færre ressurser kan trenge ytterligere gjennomgang fordi tilgjengelig klinisk terminologi og opplæringsdekning varierer.
API-integrasjon og rapporteringsformater må bevare den kliniske betydningen
Integrasjonsvalidering undersøker om pasientidentitet, verdier, enheter, datoer og advarsler forblir korrekte på tvers av systemgrenser. HTML-, JSON- og PDF-utdata bør formidle det samme kliniske innholdet når disse formatene støttes. Et natriumresultat på 128 mmol/L må ikke endre betydning fordi én utdata mangler en advarsel eller en annen forkorter et felt.
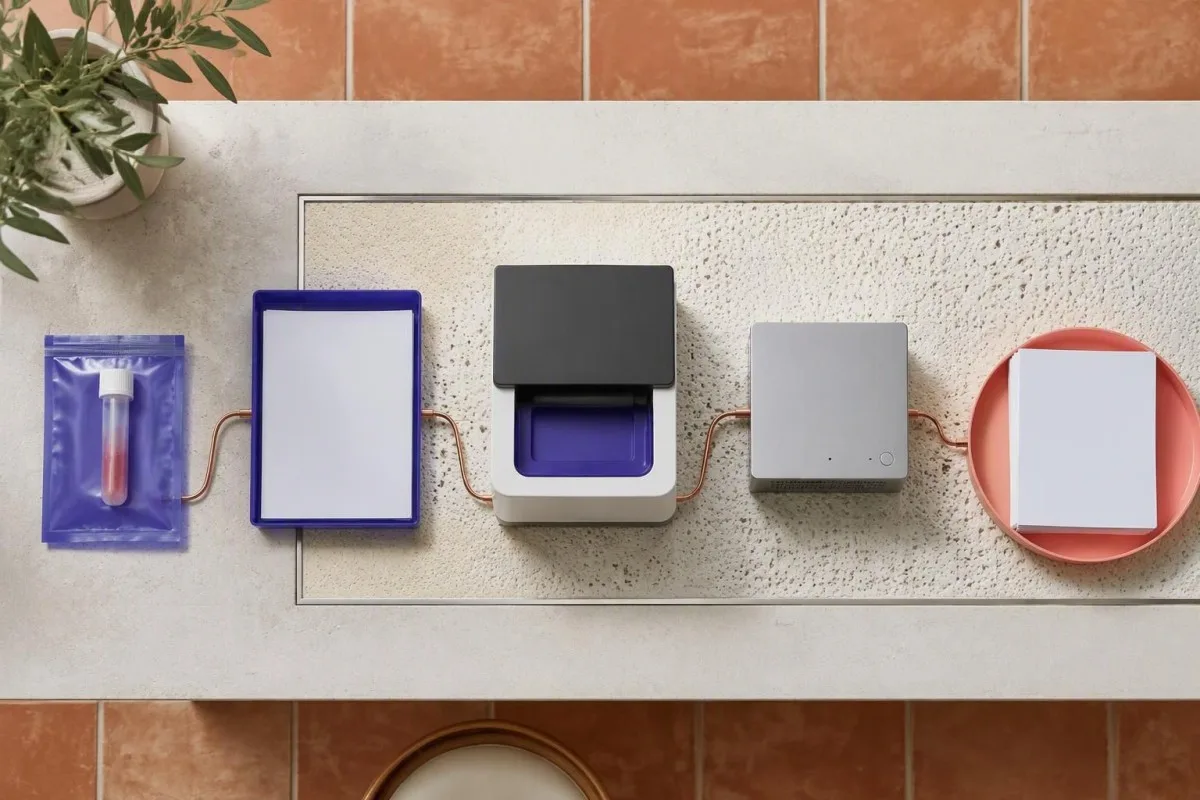
En fungerende API-tilkobling er ikke en validert klinisk integrasjon. Vårt B2B-API krever kontroller som er spesifikke for utrullingen, av kartlegging, autentisering, svarhåndtering og versjonsatferd; kompatibilitet med EHR eller LIS bør dokumenteres for det faktiske grensesnittet. Test minst 3 feilklasser – manglende enheter, pasientidentifikatorer som ikke samsvarer, og forsinkede dupliserte svar – i stedet for å godta én vellykket demonstrasjonsforespørsel.
Avledede verdier krever eksplisitte inndata og dokumentasjon av formelens opphav. Korrigert natrium avhenger for eksempel av målt natrium, glukose og korrigeringsmetoden; ulike publiserte koeffisienter kan gi ulike estimater. Vår veiledning for glukoserelatert natriumkorreksjon gir et klinisk testtilfelle, men kjøpere bør kontrollere at glukose i mg/dL aldri behandles som mmol/L, og at enhver beregning oppgir forutsetningene sine.
Enighet om format bør omfatte betydning, ikke bare utforming. I en hypotetisk eksporttest med 300 rapporter kan JSON bevare et kritisk flagg, mens en PDF-mal skjuler det under et sideskift. Sammenlign kliniske anbefalinger, usikkerhet, enheter og tidsstempler på tvers av støttede utdataformater; sørg for at råverdier kan spores til kilden, og angi om et manglende felt fører til en sikker avvisning eller en tolkning uten grunnlag.
Raske rapporter og et brukervennlig grensesnitt krever fortsatt dokumentasjon på menneskelige faktorer
Hastighet og brukervennlighet er driftsmessige fordeler, ikke direkte dokumentasjon på diagnostisk nøyaktighet. Tolkningsfunksjonen vår genererer vanligvis en forklaring på omtrent 60 sekunder, men ved klinisk bruk bør forsinkelser fra ende til ende, mislykkede forespørsler og arbeidsmengden for gjennomgang måles. En median behandlingstid alene kan ikke vise om hasteprøveresultater når riktig person på en sikker måte.
Forsinkelse bør rapporteres som en fordeling. Be om medianen, 95-persentilen og tidsavbruddsraten ved realistisk samtidig bruk, også med store filer og bilder av dårlig kvalitet. En hypotetisk median på 45 sekunder med en 95-persentil på 240 sekunder beskriver en helt annen tjeneste enn en som konsekvent fullfører nær 60 sekunder; ingen av tallene dokumenterer at behandlingen starter tidligere.
Hastekritiske laboratoriemønstre krever testet presentasjon og eskalering. Et kaliumresultat på 6.5 mmol/L kan tyde på en medisinsk nødsituasjon, selv om prøvekvalitet og klinisk kontekst påvirker tolkningen. Vår veiledning om elektrolyttverdier som krever rask oppfølging støtter utformingen av scenarier; pasienter med et varsel om et hasteprøveresultat bør kontakte behandlingsstedet raskt i stedet for å vente på en forklaring i en app, særlig hvis de har symptomer.
Testing av menneskelige faktorer måler hva brukerne gjør med rapporten. På tvers av nettilgang, iOS, Android og utvidelsesbasert tilgang bør kjøpere undersøke minst 3 oppgaver: finne den opprinnelige verdien, forstå usikkerheten og identifisere neste hensiktsmessige handling. Registrer feilhandlinger så vel som fullføringstid, fordi et polert grensesnitt kan øke tilliten til en anbefaling uten grunnlag og gjøre automatiseringsbias vanskeligere å oppdage.
Dokumentasjon på sikkerhet og personvern hører hjemme ved siden av klinisk validering
Personvernvurderingen verifiserer hvordan sensitiv laboratorieinformasjon samles inn, behandles, oppbevares, deles og slettes. Håndtering i tråd med GDPR er en uttalt tilnærming, ikke en erstatning for kontraktsmessig og teknisk dokumentasjon. For Kantesti Ltd, UK Company No. 17090423, bør kjøpere avklare det relevante forholdet mellom behandlingsansvarlig og databehandler og deres respektive ansvarsområder før de sender selv én identifiserbar rapport.
Helseopplysninger krever mer enn at et navn fjernes. En rapport kan inneholde en strekkode, nøyaktig fødselsdato, prøvenummer eller beskrivende detalj som kan identifisere noen når den kombineres med annen informasjon. Våre personverntiltak ved opplasting forklarer praktisk minimering; en kjøper bør evaluere minst 3 lag hver for seg: filinnhold, kontometadata og driftslogger.
Sikkerhetspåstander trenger et definert omfang og en dato for dokumentasjonen. Gå gjennom krypteringsordninger, tilgangskontroller, lister over underdatabehandlere, vilkår for varsling om hendelser og innstillinger for oppbevaring i dokumentasjonen om personvern. Hvis en leverandør viser til en revisjon, spør hvilken tjeneste og kontrollperiode den dekker; en rapport som dekker 1 infrastrukturkomponent, vurderer ikke automatisk tilgang til kliniske applikasjoner eller håndtering av modelldata.
Internasjonal distribusjon medfører ytterligere forpliktelser. Bruk i 127+ land betyr ikke at én kontrakt eller ett rettslig grunnlag dekker alle jurisdiksjoner, og samsvar med GDPR innebærer ikke at HIPAA gjelder eller at kravene i HIPAA er oppfylt. For familiefunksjoner bør tillatelsesgrenser testes med 2 separate kontoer, inkludert tilbaketrekking av tilgang og kontogjenoppretting; hvorvidt sletting av en rapport også fjerner sikkerhetskopier og logger, krever et tydelig svar.
KI-motoren: Valider prediksjoner og anbefalinger separat
En AI-motor trenger påstandsspesifikk validering for mønstertolkning, prediksjon av fremtidig risiko og persontilpassede anbefalinger. Dette er ulike oppgaver, selv når de genereres i 1 rapport. Arkitektur for dyp læring og analyse av flere parametere beskriver hvordan et system fungerer; de beviser ikke at sannsynlighetsestimatene, de diagnostiske forslagene eller kostholdsrådene er klinisk pålitelige.
Tolkning av flere parametere bør ivareta alternative forklaringer. I en hypotetisk rapport med ferritin på 40 ng/mL og CRP på 20 mg/L kan ferritin alene ikke avgjøre spørsmålet om jerntilgjengelighet, fordi ferritin kan øke ved en akuttfasereaksjon. Kjøpere som evaluerer Kantestis nevrale nettverk, bør bruke slike kontekstsensitive tilfeller, mens teknologiforklaring fortsatt er forskjellig fra dokumentasjon på at en spesifikk klinisk konklusjon er korrekt.
Risikoprediksjon krever et definert utfall og en tidshorisont. En sannsynlighet på 20% er umulig å tolke uten å angi hva som kan skje, med hvem og i løpet av hvilken periode – for eksempel sykehusinnleggelse innen 30 dager i stedet for sykdomsdebut innen 5 år. TRIPOD+AI anbefaler transparent rapportering for studier av prediksjonsmodeller (Collins et al., 2024); kalibrering og ekstern validering er viktig, også for analyse av legemiddelrelaterte trender.
Persontilpassede råd medfører en separat sikkerhetsforpliktelse. En ernæringsanbefaling kan være upassende når informasjon om nyrefunksjon, legemidler eller graviditet mangler; Family Health Risk trenger også tydelige rutiner for usikker eller selvrapportert sykehistorie. Vår kostholdsveiledning for nyrehelse tilbyr relevante testsituasjoner, men det at man godtar en måltidsplan med 3 elementer, er ikke dokumentasjon på at den forbedrer utfall eller trygt erstatter en individuell kostholdsfaglig vurdering.
Slik fungerer KI-tolkning av blodprøver: En valideringssjekkliste for kjøpere
En kjøper bør teste hele sekvensen: registrering av kildedata, normalisering, kontekstuell tolkning, rapportgenerering og klinisk gjennomgang. Evaluer hvert trinn separat før det kombinerte systemet testes. En akseptanseplan i 5 trinn gjør det enklere å identifisere om et utrygt resultat startet med en feiltolket verdi, en feil antakelse eller en upassende anbefaling.
Begynn med å definere tiltenkt bruk og låse den evaluerte versjonen. Trinn 1 er en skriftlig oversikt over påstander og risikoer; trinn 2 er et låst, representativt datasett med forhåndsdefinerte kriterier for kvalifisering og referanseetiketter. Deretter bør PDF- eller bildefangst testes med endrede oppsett, desimalkonvensjoner og uleselige felt; dokumenter avvisninger i stedet for å utelate dem i det stille fra den endelige nevneren.
Test deretter antakelser om kontekst og utvikling over tid. Trinn 3 kontrollerer enheter, referanseintervaller og metadata; trinn 4 vurderer tolkninger og anbefalinger ved hjelp av klinisk meningsfulle alvorlighetskategorier. Guiden vår til endringer mellom laboratoriebesøk støtter en nyttig utfordring: En kreatininendring fra 80 til 100 µmol/L krever at man tar hensyn til tidspunkt, analysevariasjon og pasienten, ikke at man automatisk erklærer forverring.
Avslutt med en beslutning om innføring, ikke en slagordpreget påstand om nøyaktighet. Trinn 5 vurderer prospektiv lokal bruk og håndtering av feil opp mot kriterier som er avtalt før resultatene gjennomgås, inkludert usikkerhetsgrenser og eskaleringsatferd. Be om en dokumentasjonspakke med kohortflyt, modellversjon, fullstendig vurderingsrubrikk, undergruppetabeller, eksempler på uheldige resultater og regler for endringskontroll; ingen universell prosentandel kan erstatte akseptgrenser tilpasset konsekvensene av feil.
Eksempelrapporter og kundeuttalelser: Skill illustrasjoner fra dokumentasjon
En eksempelrapport viser presentasjon og resonnering, mens en anbefaling beskriver et individuelt inntrykk. Ingen av delene fastslår nøyaktighet på pasientnivå eller klinisk nytte. Tenk på en helt hypotetisk voksen på 52 år med kreatinin på 118 µmol/L, rapportert eGFR på 58 mL/min/1,73 m² og ingen tilgjengelige tidligere resultater: Den trygge forklaringen må bevare usikkerheten.
Én redusert eGFR fastslår ikke kronisk nyresykdom. KDIGO definerer kronisk nyresykdom som avvik i nyrenes struktur eller funksjon som foreligger i minst 3 måneder; en eGFR under 60 mL/min/1,73 m² krever vurdering av varighet og kontekst (KDIGO CKD Work Group, 2024). I dette hypotetiske eksempelet bør en rapport anbefale klinisk vurdering og passende oppfølging, ikke diagnostisere permanent nyreskade ut fra ett enkelt resultat.
Kreatininbaserte estimater kan være mindre informative ved uvanlig kroppssammensetning. Hvis den hypotetiske personen er svært muskuløs eller nylig har endret bruk av kosttilskudd, bør tolkningen ta hensyn til disse faktorene i stedet for å avfeie resultatet. Diskusjonen vår om kreatinin hos muskuløse voksne gir kontekst; KDIGO støtter estimering med kreatinin–cystatin C der dette er tilgjengelig, for egnet vurdering av kronisk nyresykdom hos voksne, fremfor å anta at det første estimatet er endelig.
Demonstrasjoner bør omfatte vanskelige inndata og uheldige resultater. Legg til et separat hypotetisk kaliumresultat på 6.0 mmol/L med et flagg for et prøveproblem, ved hjelp av vår begrensninger ved resultater knyttet til hemolyse for å forklare hvorfor både bekreftelse og hastegrad må vurderes. For Kantesti er en nyttig evaluering en blindet sammenligning av fullstendige rapporter; fagpersoners anbefalinger, dersom de presenteres med samtykke, er fortsatt erfaringsbaserte tilbakemeldinger og ikke en erstatning for slik testing.
Omfavn diagnostikkens fremtid: Evidensbasert innføring
Ta i bruk KI-tolkning bare innenfor bruksområdene som støttes av dokumentasjon, med lokal oppfølging og en dokumentert håndtering av feil. Kantesti er et KI-drevet verktøy for analyse av blodprøver; funksjonene våre bør vurderes etter de samme innkjøpsstandardene som beskrives her. Det er tryggere å begynne med ett begrenset bruksområde enn å anta at dokumentasjonen gjelder alle pasienter og anbefalinger.
En trinnvis innføring bør skille mellom gjennomførbarhet og effektivitet. En hypotetisk skyggeevaluering av 100 rapporter kan avdekke integrasjonsfeil og vanlige problemer med formuleringer uten å utsette pasienter for anbefalinger som ikke er gjennomgått, men den vil neppe kunne fastslå en lav forekomst av sjeldne, alvorlige feil. En bredere prospektiv evaluering krever en begrunnelse for utvalgsstørrelsen og utfall som er tilpasset den faktiske påstanden, inkludert unødvendig oppfølging så vel som oversette risikoforhold.
Programvareendringer kan endre tidligere målt ytelse. En ny modell, prompt, database med referanseområder eller rapportmal kan endre resultatene selv om produktnavnet forblir det samme; registrer alle 4 kategoriene i historikken over innføringen. Overvåk feilens alvorlighetsgrad, avståelser, avvik mellom undergrupper og brukeroverstyringer, og definer når en endring utløser målrettet regresjonstesting, en ny lokal evaluering eller stans i en bestemt funksjon.
Beslutningen om innføring bør bygge på en skriftlig analyse av dokumentasjonsgap. Identifiser hva som er uavhengig fastslått, hva som kun støttes av teknisk testing, og hva som fortsatt ikke er testet; utpek deretter en ansvarlig for hver uavklart risiko. Vår kontaktkanal for innkjøpere i helsevesenet er riktig sted å be om dokumentasjon som gjelder det aktuelle omfanget—foretrekk en snevrere, underbygget påstand fremfor en 99%-overskrift med en uklar nevner.
Forskningspublikasjoner: Skill pedagogiske veiledninger fra valideringsstudier
De 2 DOI-referansene til arkivene nedenfor viser til opplæringsguider, ikke kliniske valideringsstudier av programvare for AI-tolkning. En DOI gir en permanent identifikator; den dokumenterer ikke fagfellevurdering, rekruttering av pasienter, uavhengig evaluering eller klinisk effekt. Innkjøpere bør klassifisere hver publikasjon det vises til, etter hvilket spørsmål den faktisk kan besvare.
Opplæringsguider kan bidra til å utforme et valideringsrammeverk uten selv å validere produktet. Vår komplement og ANA-veiledning kan være relevant i tilfeller der 2 komplementmålinger og antistoffkontekst må forklares nøye. Samsvar med en guide er ikke det samme som samsvar med pasientutfall vurdert uavhengig, særlig når guiden og den evaluerte programvaren har samme organisatoriske opphav.
Guider om diagnostisk timing tar for seg en annen nyttig feilkilde. Vår Nipah diagnostisk testveiledning omtaler en spesialisert diagnostisk kontekst; den bør ikke brukes til å antyde at rutinemessig laboratorietolkning påviser et bestemt virus. Hvis en innkjøper inkluderer selv bare 1 påstand om et patogen med store konsekvenser i den tiltenkte bruken, trenger påstanden egne relevante diagnostiske bevis og hensiktsmessige rammer for eskalering.
Standarder for rapportering av studier støtter vurdering, men sertifiserer ikke ytelse. STARD 2015 inneholder 30 rapporteringselementer for forskning på diagnostisk nøyaktighet, mens TRIPOD+AI omhandler rapportering av prediksjonsmodeller; ingen av sjekklistene gir programvare et klinisk godkjenningsstempel. Referansene nedenfor skiller disse metodiske kildene og KDIGO-retningslinjen fra 2024 fra de 2 pedagogiske DOI-oppføringene, slik at leserne kan skille mellom kliniske anbefalinger, rapporteringsveiledning og produktspesifikke bevis.
Ofte stilte spørsmål
Hva er klinisk validering av AI-programvare for blodprøver?
Klinisk validering vurderer om en spesifisert versjon av AI-programvare for blodprøver gir tilstrekkelig nøyaktige og trygge resultater for de tiltenkte pasientene og beslutningene. Den bør skille mellom minst 3 oppgaver: å lese kilderapporten, å tolke klinisk betydning og å anbefale en handling. Dokumentasjonen bør beskrive referansestandarden, utvalgsstørrelsen på pasientnivå, uavhengig testing og håndtering av feil. En teknisk korrekt forklaring beviser ikke i seg selv at pasientutfallene er forbedret.
Er 99%s nøyaktighet tilstrekkelig til å stole på en AI-blodprøveanalysator?
Et nøyaktighetskrav på 99% kan ikke fastslå sikkerhet uten nevneren, oppgavebeskrivelsen og alvorlighetsgraden av feilene. I en hypotetisk gruppe der bare 1% har en måltilstand, oppnår programvare som klassifiserer alle som negative, en nøyaktighet på 99% uten å oppdage noen av de berørte pasientene. Kjøpere bør be om sensitivitet, spesifisitet, feil i rapporter på pasientnivå og antall avviste inndata. Sjeldne, men farlige anbefalinger må ikke forsvinne i et gjennomsnitt dominert av enkle utsagn.
Hva er forskjellen mellom en syntetisk referansetest og klinisk validering?
0 En syntetisk benchmark evaluerer programvare på konstruerte tilfeller, mens klinisk validering krever dokumentasjon som er relevant for den tiltenkte pasientpopulasjonen og den kliniske påstanden. Selv 100 000 syntetiske tilfeller kan ikke fastslå forekomst i den virkelige verden, klinisk nytte eller ytelse ved alle problemer med manglende sykehistorie og prøvekvalitet. Syntetisk testing kan bidra til å avdekke tekniske feil og støtte regresjonstesting. Den bør supplere, ikke erstatte, representativ ekstern evaluering og prospektiv evaluering.
Hvor mye uavhengig testing trenger helse-AI?
0. KI i helsetjenesten trenger uavhengig testing som står i forhold til konsekvensene av et feilaktig resultat, ikke et universelt minimumsantall rapporter. Hvis man observerer 0 feil i 100 uavhengige tilfeller, ligger den omtrentlige øvre grensen for feilraten på 95%, nær 3%, ved bruk av tre-regelen. Kjøpere bør be om beskyttede testdata, en fryst modellversjon og opplysninger om evaluatørens relasjoner. Påstander om sjeldne, alvorlige feil krever vanligvis mer dokumentasjon enn en liten pilot for brukervennlighet eller gjennomførbarhet kan gi.
Betyr støtte for 100 språk like høy nøyaktighet på alle språk?
Støtte for 100 språk dokumenterer ikke lik klinisk nøyaktighet på tvers av språkene. Språkspesifikk evaluering bør teste uttrekk av inndata, desimalkonvensjoner, enheter, negasjon og betydningen av anbefalinger. Glukose angitt som 5,6 mmol/L må for eksempel ikke tolkes som 56 mmol/L. Kjøpere bør be om språkspesifikke nevnere og opplyse hvilke språk som ikke har gjennomgått klinisk vurdering.
Kan KI diagnostisere kronisk nyresykdom ut fra én lav eGFR-verdi?
Ett eGFR-resultat under 60 mL/min/1.73 m² fastslår ikke i seg selv kronisk nyresykdom. KDIGO-retningslinjen fra 2024 definerer kronisk nyresykdom ut fra nyreavvik som har vært til stede i minst 3 måneder, med vurdering av kronisitet og klinisk kontekst. Akutte endringer, kroppssammensetning og andre faktorer kan påvirke tolkningen. AI-programvare bør forklare usikkerheten og støtte oppfølging hos kliniker i stedet for å klassifisere et enkelt redusert estimat som permanent sykdom.
Få forklart blodprøveresultatene dine
Last opp laboratorierapporten din, så forklarer AI-en til Kantesti hver biomarkør på et lettfattelig språk i løpet av sekunder. Brukt av mer enn 2 millioner mennesker verden over.
References
- Klein, T., Mitchell, S. og Weber, H. (2025). Veiledning om C3-, C4-komplementblodprøver og ANA-titer. Kantesti AI medisinsk forskning. DOI
- Klein, T., Mitchell, S. og Weber, H. (2025). Blodprøve for Nipah-virus: veiledning om tidlig påvisning og diagnostisering 2026. Kantesti AI medisinsk forskning. DOI
- Bossuyt PM et al. (2015). STARD 2015: en oppdatert liste over viktige elementer for rapportering av studier av diagnostisk nøyaktighet. BMJ. DOI PubMed
- Collins GS et al. (2024). TRIPOD+AI-erklæringen: oppdatert veiledning for rapportering av kliniske prediksjonsmodeller som bruker regresjon eller maskinlæringsmetoder. BMJ. DOI
- Arbeidsgruppen for kronisk nyresykdom i Kidney Disease: Improving Global Outcomes (KDIGO) (2024). KDIGO 2024-retningslinje for klinisk praksis ved utredning og behandling av kronisk nyresykdom. Kidney International. DOI
- 2M+Analyserte prøver
- 127+Countries
- 100+Språk
Om det medisinske teamet


E-E-A-T tillitssignaler
Experience
Klinisk gjennomgang ledet av lege av arbeidsflyter for laboratorietolkning.
Expertise
Fagområde laboratoriemedisin med fokus på hvordan biomarkører oppfører seg i klinisk kontekst.
Authoritativeness
Medisinsk gjennomgått av Dr. Thomas Klein, med bidrag fra Dr. Sarah Mitchell og Prof. Dr. Hans Weber.
Trustworthiness
Evidensbasert tolkning med tydelige oppfølgingsveier for å redusere uro.


Medisinsk ansvarsfraskrivelse
Denne artikkelen er kun for informasjonsformål og utgjør ikke medisinsk rådgivning. Rådfør deg alltid med en kvalifisert helsepersonell for beslutninger om diagnose og behandling.
Publisert · Oppdatert · Kontakt redaksjonen
Publisert av Kantesti Ltd, registrert i England og Wales, selskapsnr. 17090423, London, Storbritannia.
