
Клиничката валидација значи тестирање дали софтверот дава доволно точни и безбедни толкувања за пациентите за кои е наменет — а не само дали генерира уверливи извештаи.

Клучни заклучоци
- Опсег на валидацијата мора да ги идентификува пациентите за кои е наменета, лабораториските влезни податоци и клиничките одлуки; успехот во 1 задача не може да ја утврди безбедноста при сите примени.
- Именители за точноста треба да разликуваат пациенти, извештаи, биомаркери и поединечни тврдења; 10.000 тврдења може да потекнуваат од само 200 извештаи.
- Чувствителност мери откриени референтно позитивни случаи; хипотетички резултат од 90/100 значи дека биле пропуштени 10 засегнати случаи.
- Предиктивната вредност зависи од преваленцата: при преваленца од 1%, сензитивност од 90% и специфичност од 95% даваат позитивна предиктивна вредност од околу 15.4%.
- Независно тестирање бара заштитени податоци за тестирање, замрзната верзија на софтверот и откривање кој ја дизајнирал, финансирал и пресудувал евалуацијата.
- Докази за подгрупите мора да ги вклучува големините на примероците и неизвесноста; набљудувањето 0 пропусти меѓу 20 позитивни случаи не докажува совршена чувствителност.
- Оперативната брзина од приближно 60 секунди го опишува нашето толкување на функцијата, а не докажано намалување на дијагностичките грешки или доцнењето на лекувањето.
- Критериумите за усвојување треба да ги опфатат безбедноста на ниво на пациент, перформансите специфични за јазикот, неуспешните внесувања и документираниот одговор на промените во софтверот.
Подемот на вештачката интелигенција во медицинската дијагностика: што значи валидацијата
Валидација на тестови на крв со ВИ бара докази дека одредена верзија на софтверот дава точни и безбедни толкувања за пациентите и одлуките за кои е наменета. Купувачите треба да ги испитаат именителите на ниво на пациент, независното тестирање, резултатите за подгрупите и постапувањето при неуспех — а не само истакнатиот процент на точност. Kantesti е анализатор на тестови на крв со ВИ, чии резултати треба да подлежат на истите барања за докази.
Софтверот за толкување не го мери оригиналниот примерок. Лабораториски анализатор генерира вредности, како што е натриум од 138 mmol/L; потоа софтверот за толкување ги чита тие вредности и го објаснува нивното можно значење, создавајќи втора можност за грешка дури и кога лабораториското мерење е точно. Затоа купувачите треба да бараат одделни докази за точноста на извлекувањето податоци, постапувањето со референтните опсези и клиничкото расудување.
Клиничката валидност и клиничката корисност одговараат на различни прашања. Евалуацијата може да покаже согласност во 500 извештаи без да покаже дека пациентите добиваат подобра нега, избегнуваат непотребни испитувања или поточно ја разбираат неизвесноста. Нашиот водич за објаснување на медицински извештаи објаснува зошто разбирливите формулации и понатаму бараат проверка според изворот и соодветни граници за упатување на повисоко ниво.
Статистиката за усвојување не може да ја замени клиничката студија. Нашиот опфат од 2M+ корисници низ 127+ земји, пријавен од платформата, ја опишува употребата, а не репрезентативна група за валидација со потврдени исходи. Kantesti позадина на компанијата помага да се воспостави организациска одговорност; во посебен досие со докази мора да се наведат точната намена, подобната популација и последиците од погрешно толкување.
Тврдења за точноста: одделно броење пациенти, извештаи и одлуки
Тврдењето за точност може да се протолкува само кога се објавени неговиот броител, именител и правилата за бодување. Вредност како 98.49% може да се однесува на извлечени полиња, прифатени тврдења или класифицирани случаи — многу различни задачи. Тука тој број е пример за истакната бројка што бара проверка, а не независно потврден резултат од клинички перформанси.
Повторените тврдења не се независни пациенти. Во хипотетичка евалуација, 200 извештаи со по 50 бодувани тврдења даваат 10.000 набљудувања на ниво на тврдење, но сепак само 200 извештаи. Точно објаснување на натриум од 140 mmol/L не треба да поништи опасна препорака на друго место во истиот извештај; барајте и бодување на ниво на тврдење и процент на извештаи што содржат клинички значајни грешки.
Исклучените внесувања може да ја зголемат привидната сигурност. Да претпоставиме дека се поднесени 1.000 извештаи, 100 се одбиени, а 882 од преостанатите 900 го исполнуваат критериумот: точноста меѓу завршените извештаи е 98%, додека успешниот прифатлив резултат кај сите поднесени извештаи е 88.2%. Ниту еден од двата именители не е сам по себе нечесен, но купувачите треба да ги знаат двата, како и причините за одбивањето и дали одбиените случаи несразмерно често вклучуваат итни абнормалности.
Објавената методологија треба да дефинира што се сметало за точно пред да започне бодувањето. Изјавата за известување STARD 2015 бара студиите за дијагностичка точност да ги опишат изборот на учесници, референтниот стандард и текот на учесниците (Bossuyt et al., 2015). Нашата страница за методологија на валидација е почетна точка за прашања во врска со Kantesti; не треба да се третира како доказ за независни перформанси на ниво на пациент без основните материјали од студијата.
Сензитивноста, специфичноста и предиктивната вредност одговараат на различни прашања
Сензитивноста го мери откривањето меѓу случаите позитивни според референтниот стандард; специфичноста ги мери точно утврдените негативни случаи меѓу случаите негативни според референтниот стандард. Позитивната предиктивна вредност мери колку често позитивниот резултат е точен во тестираниот амбиент. За хипотетичка алатка со сензитивност од 90% и специфичност од 95% при преваленца од 1%, позитивната предиктивна вредност е приближно 15.4%.
Матрицата на конфузија јасно ја прикажува рамнотежата. Меѓу 10.000 хипотетички пациенти при преваленца од 1%, 100 ја имаат целната состојба: кај 90 таа е откриена, а кај 10 е пропуштена. Од 9.900 пациенти што ја немаат, 495 добиваат лажно позитивни резултати; следствено, точни се само 90 од 585 позитивни резултати, иако вкупната точност е 94.95%.
Прецизноста не е универзален синоним за точност. Во класификацијата, прецизноста најчесто значи позитивна предиктивна вредност, додека во рубрика за оценување наратив на добавувачот зборот може да се користи со поинакво значење. Нашата дискусија за потврда на нископозитивни антитела го илустрира клиничкиот принцип: толкувањето зависи од претестната веројатност и потврдата, а не само од тоа дали почетниот резултат надминува праг.
Изборот на праг ја менува рамнотежата меѓу пропуштените случаи и лажните аларми. Побарајте матрица на конфузија при предложениот праг за воведување во пракса, а не само крива на перформанси што опфаќа повеќе прагови. Во хипотетичка студија за алармирање, намалувањето на прагот од 0.7 на 0.4 може да ја подобри сензитивноста, а истовремено да ги удвои лажните аларми; купувачите мора да одлучат дали таа рамнотежа одговара на клиничките последици и капацитетот за преглед.
Независното тестирање бара заштитен сет на податоци и веродостоен референтен стандард
Независното тестирање оценува замрзнат модел на податоци што не биле достапни за време на развојот, со обелоденети односи на оценувачот и клинички оправдан референтен стандард. Самите надворешни податоци не гарантираат независна евалуација. Студија во која учествуваат 3 болници сè уште може да има пристрасни ознаки, заеднички цевководи за податоци или тест-примери што влијаеле врз дотерувањето на моделот.
Раздвојувањето на податоците на ниво на пациент спречува чест облик на протекување на податоци. Ако јануарскиот извештај на пациент влезе во податоците за тренирање, а неговиот февруарски извештај во податоците за тестирање, моделот може да има корист од обрасци што се повторуваат или од идентификатори. Купувачите треба да прашаат како биле идентификувани дуплираните пациенти, повторените приеми и извештаите од 2 поврзани лабораториски системи, и дали конечниот тест-сет останал недопрен по изборот на моделот и промптот.
Референтниот стандард мора да одговара на тврдењето. Согласноста на експертите за 300 толкувања може да го оцени квалитетот на извештаите, но таа автоматски не потврдува присуство на заболување или идни исходи. Разликата е позната од точноста и времето на тестовите: тестот што се оценува, компараторот и времето на потврдата може да влијаат врз привидните перформанси.
Синтетичките репери тестираат конструирани случаи, а не преваленца на заболувања во реални услови или клиничка корисност. Дури ни 100.000 синтетички сценарија не можат да ја репродуцираат секоја недостасувачка анамнеза, артефакт од примерокот или неочекувана клиничка слика. За тврдења во врска со ограничувањата на толкувањето на тропонинот, студијата ги бара клиничките информации и дијагностичкото следење релевантни за тврдењето; точна реченица за лабораториски праг не е потврдена дијагноза.
Перформансите во подгрупите може да откријат ризици скриени со просекот
Тестирањето на подгрупи проверува дали перформансите се менуваат кај клинички релевантни групи пациенти и услови на внесување. Купувачите треба да побараат именители, тежина на грешките и интервали на доверба за деца, постари возрасни лица, бременост, бубрежно оштетување и други целни популации. Набљудувањето 0 пропусти во 20 референтно позитивни случаи остава значителна неизвесност за вистинската стапка на пропусти.
Референтните интервали специфични за возраста не се заменливи. Педијатриското толкување не може безбедно да го преземе секој праг за возрасни, дури и кога основниот аналит и единицата се идентични. Нашиот водич за AI толкување за деца ја објаснува безбедносната граница; купувачите треба да побараат вистински броеви по возрасни групи, наместо да прифатат општо тврдење што опфаќа пациенти од 1 до 18 години.
Биолошкиот контекст е поважен од демографските кратенки. Апсолутен број на неутрофили од 1.2 × 10^9/L може да бара различно расудување кај стабилно лице со број поврзан со Duffy-null, отколку кај лице со ново намалување за време на лекувањето. објаснување за неутрофилите со Duffy-null поддржува насочен тест-случај; потеклото само по себе не смее да се користи за претпоставување генотип или клиничка безбедност.
Малите примероци можат да сокријат клинички значајни стапки на неуспех. Приближното правило на три значи дека 0 набљудувани настани во 20 независни набљудувања одговараат на горна граница од приближно 15%, а не 0%. За споредби меѓу подгрупи е потребна и анализа групирана според пациент кога извештаите се повторуваат; студијата треба да ги наведе нетестираните групи, наместо несигнификантната разлика да ја третира како доказ дека перформансите се еквивалентни.
Повеќејазичната поддршка бара тестирање на безбедноста специфично за секој јазик
Мултијазичната валидација проверува дали клиничкото значење се зачувува при преводот, форматирањето на нумеричките вредности и објаснувањето наменето за пациентот на секој целен јазик. Kantesti е платформа за толкување крвна слика со вештачка интелигенција, со поддршка за 100+ јазици; таа можност сама по себе не воспоставува еквивалентни клинички перформанси на тие јазици. За секој јазик е потребна соодветна стратегија за евалуација и наведување на опфатот.
Децималните конвенции можат да ја променат толкуваната вредност. Резултат за гликоза запишан како 5,6 mmol/L во еден регион не смее по екстракцијата да стане 56 mmol/L, а конверзијата на единици треба да го зачува клиничкото значење, а не само да ја замени интерпункцијата. Оценувајте ги влезните податоци на оригиналниот јазик и преведените излези одделно; тестирањето само англиски лабораториски извештаи преведени на 10 јазици ги пропушта грешките при внесување.
Негацијата и видот на резултатот заслужуваат посебни тест-случаи. Изрази како не е детектирано, под границата на квантификација и не може да се исклучи означуваат различни степени на сигурност. Нашиот водич за квалитативно наспроти квантитативно ја објаснува разликата; рубриката за двојазична проверка треба да ги тестира овие значења, вклучувајќи ги и симболите за нееднаквост како помало од 0.1, наместо да наградува само течна формулација.
Читливоста не гарантира разбирање. Корисна јазична евалуација би можела да побара од учесниците да го идентификуваат потребното дејство и неизвесноста откако ќе прочитаат 3 кратки извештаи, а истовремено да бележи дали преводот ја менува итноста или советот за лекување. Ова се предложени задачи за евалуација, а не универзален валидиран праг; јазиците со помалку ресурси можеби ќе бараат дополнителна проверка бидејќи достапната клиничка терминологија и опфатот на обуката се разликуваат.
Интеграцијата на API и форматите за известување мора да го зачуваат клиничкото значење
Валидацијата на интеграцијата проверува дали идентитетот на пациентот, вредностите, единиците, датумите и предупредувањата остануваат точни при премин меѓу системи. Излезите во HTML, JSON и PDF треба да ја пренесуваат истата клиничка содржина кога се поддржани тие формати. Резултат за натриум од 128 mmol/L не смее да го менува значењето затоа што во еден излез недостасува предупредување или затоа што друг го отсекува полето.
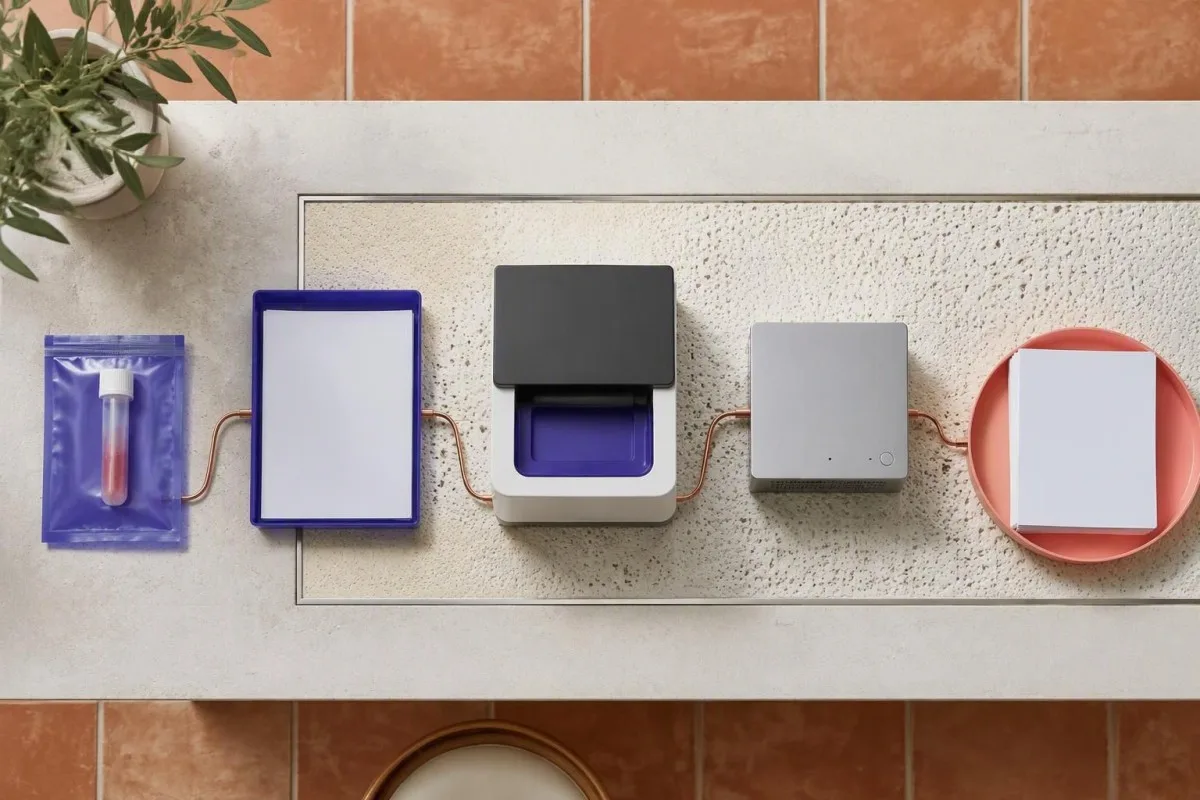
Работната API-врска не претставува валидирана клиничка интеграција. Нашиот B2B API бара проверки специфични за имплементацијата на мапирањето, автентикацијата, обработката на одговорите и однесувањето на верзиите; компатибилноста со EHR или LIS треба да се докаже за конкретниот интерфејс. Тестирајте најмалку 3 класи на грешки — единици што недостасуваат, неусогласени идентификатори на пациенти и одложени дупликатни одговори — наместо да прифатите едно успешно демонстративно барање.
Изведените вредности бараат експлицитни влезни податоци и потекло на формулата. Коригираниот натриум, на пример, зависи од измерениот натриум, гликозата и пристапот за корекција; различни објавени коефициенти може да дадат различни проценки. Нашиот водич за корекција на натриумот поврзана со гликоза нуди клинички тест-случај, но купувачите треба да проверат дека гликозата во mg/dL никогаш не се третира како mmol/L и дека во секоја пресметка се наведени претпоставките.
Усогласувањето на форматот треба да го опфаќа значењето, а не само изгледот. Во хипотетички тест за извоз на 300 извештаи, JSON може да зачува критично предупредување, додека шаблон за PDF да го скрие под прелом на страница. Споредете ги клиничките препораки, неизвесноста, единиците и временските ознаки низ поддржаните излези; овозможете следливост на суровите вредности до изворот и наведете дали поле што недостасува предизвикува безбедно одбивање или неподдржано толкување.
Брзите извештаи и интуитивниот интерфејс сепак бараат докази од истражувања на човечки фактори
Брзината и употребливоста се оперативни придобивки, а не директен доказ за дијагностичка точност. Нашата функција за толкување вообичаено генерира објаснување за приближно 60 секунди, но при клиничка имплементација треба да се мерат времето од почеток до крај, неуспешните барања и обемот на потребниот преглед. Самото просечно време на обработка не покажува дали итните резултати безбедно стигнуваат до вистинското лице.
Латентноста треба да се прикажува како распределба. Побарајте го медијанот, 95-тиот перцентил и стапката на истекување на времето при реалистично истовремено користење, вклучувајќи големи датотеки и фотографии со низок квалитет. Хипотетички медијан од 45 секунди со 95-ти перцентил од 240 секунди опишува услуга што многу се разликува од онаа што постојано завршува за околу 60 секунди; ниту една од овие вредности не докажува дека лекувањето започнува порано.
Итните лабораториски наоди бараат тестирана презентација и ескалација. Резултат на калиум од 6.5 mmol/L може да укажува на медицинска итна состојба, иако квалитетот на примерокот и клиничкиот контекст влијаат врз толкувањето. Нашиот водич за итност кај електролити помага во дизајнирањето сценарија; пациентите со итно лабораториско предупредување треба веднаш да се јават кај здравствената служба што ги лекува, наместо да чекаат објаснување од апликација, особено ако имаат симптоми.
Тестирањето на човечките фактори мери што прават корисниците со извештајот. Кај пристапот преку веб, iOS, Android и екстензија, купувачите треба да проверат најмалку 3 задачи: пронаоѓање на оригиналната вредност, препознавање на неизвесноста и идентификување на следното соодветно дејство. Забележувајте ги и погрешните дејства, а не само времето на завршување, бидејќи добро дизајнираниот интерфејс може да ја зголеми довербата во неподдржана препорака и да го отежне забележувањето на пристрасноста во корист на автоматизацијата.
Доказите за безбедност и приватност се дел од клиничката валидација
Проценката на приватноста проверува како се собираат, обработуваат, чуваат, споделуваат и бришат чувствителните лабораториски податоци. Усогласеното постапување со GDPR е наведениот пристап, а не замена за договорни и технички докази. За Kantesti Ltd, компанија во Обединетото Кралство со бр. 17090423, купувачите треба да ги утврдат применливиот однос и одговорностите на контролорот и обработувачот пред да испратат дури и 1 извештај со податоци што овозможуваат идентификација.
За здравствените информации не е доволно само да се отстрани името. Извештајот може да содржи баркод, точен датум на раѓање, број на прием или текстуален детаљ што може да идентификува лице кога ќе се комбинира со други информации. Нашите мерки на претпазливост за приватност при прикачување објаснува практична минимизација; купувачот треба одделно да процени најмалку 3 слоја: содржината на датотеката, метаподатоците за сметката и оперативните дневници.
Безбедносните тврдења треба да имаат дефиниран опсег и датум на докази. Прегледајте ги договореностите за шифрирање, контролите на пристап, списоците на подизвршители, условите за известување за инциденти и поставките за задржување во документацијата за приватност на податоците. Ако добавувачот наведува извршена ревизија, прашајте која услуга и кој период на контрола ги опфаќа; извештај што опфаќа 1 инфраструктурна компонента не ја проценува автоматски пристапноста на клиничката апликација или постапувањето со податоците за моделот.
Меѓународното распоредување создава дополнителни обврски. Користењето во земјите на 127+ не значи дека еден договор или правна основа ги опфаќа сите јурисдикции, а усогласеноста со GDPR не подразбира применливост на HIPAA или исполнување на неговите барања. Кај функциите за семејства, тестирајте ги границите на дозволите со 2 одделни сметки, вклучувајќи повлекување на пристапот и обновување на сметката; потребен е изричен одговор на прашањето дали бришењето извештај ги отстранува и резервните копии и дневниците.
Механизмот на вештачката интелигенција: одделна валидација на предвидувањата и препораките
На една вештачка интелигенција ѝ е потребна валидација специфична за секое тврдење во врска со толкувањето на обрасците, предвидувањето на идниот ризик и персонализираните препораки. Станува збор за различни задачи, дури и кога се генерирани во 1 извештај. Архитектурата на длабоко учење и повеќепараметарската анализа опишуваат како функционира системот; тие не докажуваат дека неговите процени на веројатноста, дијагностички предлози или совети за исхрана се клинички веродостојни.
Повеќепараметарското толкување треба да задржи простор за конкурентни објаснувања. Во хипотетички извештај со феритин од 40 ng/mL и CRP од 20 mg/L, само вредноста на феритинот не може да го разреши прашањето за достапноста на железото, бидејќи феритинот може да се зголеми како дел од одговорот на акутната фаза. Купувачите што ја оценуваат невронската мрежа на Kantesti треба да користат вакви случаи чувствителни на контекст, додека објаснување на технологијата останува различно од доказите дека конкретен клинички заклучок е точен.
За предвидување на ризикот е потребен дефиниран исход и временски хоризонт. Веројатноста од 20% не може да се толкува без да се наведе што може да се случи, кому и во кој период — на пример, хоспитализација во рок од 30 дена наместо почеток на болеста во рок од 5 години. TRIPOD+AI препорачува транспарентно известување за студии на модели за предвидување (Collins et al., 2024); калибрацијата и надворешната валидација се важни, вклучително и за анализа на трендови поврзани со лекови.
Персонализираниот совет создава посебна обврска за безбедност. Препораката за исхрана може да биде несоодветна кога недостасуваат податоци за бубрежната функција, лековите или бременоста; и Family Health Risk бара јасен пристап кон несигурна или самопријавена анамнеза. Нашиот водич за безбедност на исхраната на бубрезите нуди релевантни сценарија за тестирање, но прифаќањето план за оброци од 3 ставки не е доказ дека тој ги подобрува исходите или безбедно ја заменува индивидуализираната процена од диететичар.
Како функционира толкувањето крвна слика со вештачка интелигенција: контролен список за валидација за купувачите
Купувачот треба да го тестира целиот тек: внесување на изворните податоци, нормализација, контекстуално толкување, генерирање извештај и клинички преглед. Оценете го секој чекор одделно пред да го тестирате комбинираниот систем. План за прифаќање од 5 фази го олеснува утврдувањето дали небезбедниот излез започнал со погрешно прочитана вредност, погрешна претпоставка или несоодветна препорака.
Започнете со дефинирање на наменетата употреба и фиксирање на оценуваната верзија. Чекор 1 е писмен попис на тврдењата и ризиците; чекор 2 е заклучен, репрезентативен сет на податоци со однапред дефинирани критериуми за подобност и референтни ознаки. Потоа треба да се тестира внесувањето PDF или фотографија со изменети распореди, децимални конвенции и нечитливи полиња; документирајте ги одбивањата наместо тивко да ги исклучувате од конечниот именител.
Потоа тестирајте ги претпоставките за контекстот и надолжните податоци. Чекорот 3 ги проверува единиците, референтните интервали и метаподатоците; чекорот 4 ги оценува толкувањата и препораките според клинички значајни категории на тежина. Нашиот водич за промени помеѓу посети на лабораторија поддржува корисен предизвик: промена на креатининот од 80 на 100 µmol/L бара да се земат предвид времето, варијациите во анализата и пациентот, а не автоматски да се прогласи влошување.
Завршете со одлука за воведување, а не со слоган за точност. Чекорот 5 ја оценува проспективната локална употреба и справувањето со неуспеси според критериуми договорени пред прегледот на резултатите, вклучувајќи граници на неизвесност и постапки за ескалација. Побарајте досие со текот на кохортата, верзијата на моделот, целосната рубрика за оценување, табели по подгрупи, примери на штетни излези и правила за контрола на промени; ниту еден универзален процент не може да ги замени праговите за прифаќање усогласени со последиците од грешките.
Примероци од извештаи и сведоштва: разликувајте илустрација од доказ
Примерен извештај ги демонстрира презентацијата и расудувањето, додека сведоштвото опишува личен впечаток. Ниту едното не ја утврдува точноста на ниво на пациент или клиничката корист. Разгледајте јасно хипотетичен возрасен на 52 години со креатинин од 118 µmol/L, пријавен eGFR од 58 mL/min/1.73 m² и без достапни претходни резултати: безбедното објаснување мора да ја зачува неизвесноста.
Една намалена вредност на eGFR не утврдува хронична бубрежна болест. KDIGO ја дефинира хроничната бубрежна болест преку абнормалности во структурата или функцијата на бубрезите што траат најмалку 3 месеци; eGFR под 60 mL/min/1.73 m² бара процена на хроничноста и контекстот (KDIGO CKD Work Group, 2024). Во овој хипотетичен пример, извештајот треба да предложи процена од клиничар и соодветно следење, а не да дијагностицира трајно оштетување на бубрезите врз основа на еден резултат.
Проценките засновани на креатинин може да бидат помалку информативни при невообичаен телесен состав. Ако хипотетичкото лице е многу мускулесто или неодамна ги сменило суплементите, толкувањето треба да ги земе предвид тие фактори наместо да го отфрли резултатот. Нашата дискусија за креатинин кај мускулести возрасни дава контекст; KDIGO поддржува процена со креатинин–цистатин C кога е достапна, за соодветна процена на ХББ кај возрасни, наместо да се претпостави дека почетната процена е дефинитивна.
Демонстрациите треба да вклучуваат тешки влезни податоци и неповолни излези. Додајте посебен хипотетичен резултат на калиум од 6.0 mmol/L со означен проблем со примерокот, користејќи ги нашите ограничувања на резултатите поврзани со хемолиза за да објасните зошто мора да се земат предвид и потврдата и итноста. За Kantesti, корисна е заслепена споредба на целосни извештаи; професионалните сведоштва, ако се презентираат со согласност, остануваат повратни информации засновани на искуство, а не замена за таквото тестирање.
Прифаќање на иднината на дијагностиката: усвојување засновано на докази
Усвојте толкување со AI само во рамките на употребите поткрепени со докази, со локален надзор и документиран одговор на грешките. Kantesti е алатка за анализа на крвни тестови со AI; нашиот сет на функции треба да се процени според истите стандарди за набавка опишани овде. Почнувањето со 1 ограничен случај на употреба е побезбедно отколку да се претпостави дека доказите важат за секој пациент и секоја препорака.
Постепеното воведување треба да ја разликува изводливоста од ефективноста. Хипотетична процена во сенка на 100 извештаи може да открие проблеми со интеграцијата и чести проблеми со формулациите без пациентите да бидат изложени на непроверени препораки, но веројатно нема да утврди ниска стапка на ретки сериозни грешки. За поширока проспективна процена потребна е образложена големина на примерокот и исходи усогласени со конкретното тврдење, вклучувајќи непотребно следење, како и пропуштени проблеми.
Промените во софтверот може да ги изменат претходно измерените перформанси. Нов модел, промпт, база на податоци за референтни опсези или шаблон за извештај може да ги промени излезите дури и кога името на производот останува исто; евидентирајте ги сите 4 категории во историјата на воведување. Следете ја сериозноста на грешките, воздржувањата од давање одговор, отстапувањата кај подгрупите и корисничките презапишувања, и утврдете кога промената наложува насочено регресивно тестирање, повторна локална процена или суспензија на одредена функција.
Одлуката за усвојување треба да се темели на писмена анализа на празнините во доказите. Утврдете што е независно потврдено, што е поткрепено само со техничко тестирање и што останува непроверено; потоа назначете одговорно лице за секој нерешен ризик. Нашата канал за контакт со купувач од здравствениот сектор е соодветното место за да побарате документација специфична за опсегот — претпочитајте потесно, поткрепено тврдење наместо наслов 99% со нејасен именител.
Научни публикации: разликувајте едукативни водичи од студии за валидација
Двата референтни DOI-записа од репозиториумот подолу идентификуваат едукативни водичи, а не студии за клиничка валидација на софтвер за AI толкување. DOI обезбедува постојан идентификатор; тој не потврдува рецензија од колеги, регрутирање пациенти, независна евалуација или клиничка ефикасност. Купувачите треба да ја класифицираат секоја цитирана публикација според прашањето на кое навистина може да одговори.
Едукативните водичи можат да помогнат во составувањето критериуми за валидација, без самите да го валидираат производот. Нашето водичот за комплемент и ANA може да помогне во случаи кога 2 мерења на комплементот и контекстот на антителата бараат внимателно објаснување. Усогласеноста со водич не е исто што и усогласеноста со независно утврдени исходи кај пациентите, особено кога водичот и евалуираниот софтвер имаат заеднички организациски извор.
Водичите за дијагностичко време опфаќаат друг корисен начин на неуспех. Нашето упатство за дијагностичко тестирање на Нипах опфаќа специјализиран дијагностички контекст; не треба да се користи за да се навести дека рутинското лабораториско толкување идентификува одреден вирус. Ако купувачот вклучи дури и 1 тврдење за патоген со сериозни последици во наменетата употреба, тоа тврдење бара сопствени релевантни дијагностички докази и соодветни граници за ескалација.
Стандардите за известување на студиите помагаат при процената, наместо да ги потврдуваат перформансите. STARD 2015 содржи 30 ставки за известување за истражувања на дијагностичка точност, додека TRIPOD+AI се однесува на известување за предиктивни модели; ниту една од контролните листи не му дава на софтверот официјален печат за клиничко одобрување. Референците подолу ги раздвојуваат тие методолошки извори и упатството KDIGO од 2024 година од двата едукативни DOI-записа, за читателите да можат да ги разликуваат клиничките препораки, упатствата за известување и доказите специфични за производот.
Најчесто поставувани прашања
Што е клиничка валидација на софтвер со вештачка интелигенција за крвни тестови?
Клиничката валидација проценува дали одредена верзија на софтвер за тестирање на крв со AI произведува доволно точни и безбедни резултати за пациентите и одлуките за кои е наменета. Треба да разликува најмалку 3 задачи: читање на изворниот извештај, толкување на клиничкото значење и препорачување дејство. Доказите треба да ги опишат референтниот стандард, големината на примерокот на ниво на пациент, независното тестирање и справувањето со неуспеси. Технички точни објаснувања сами по себе не докажуваат подобрување на исходите кај пациентите.
Дали точноста на 99% е доволна за да му се верува на анализатор за крвни тестови со вештачка интелигенција?
Тврдењето за точност од 99% не може да ја потврди безбедноста без да се наведат именителот, дефиницијата на задачата и тежината на грешките. Во хипотетичка група во која само 1% имаат целна состојба, софтверот што ги означува сите како негативни постигнува точност од 99%, а притоа не открива ниту еден од засегнатите пациенти. Купувачите треба да побараат чувствителност, специфичност, грешки во извештаите на ниво на пациент и број на отфрлени влезови. Ретките, но опасни препораки не смеат да се изгубат во просекот во кој преовладуваат едноставни тврдења.
Која е разликата помеѓу синтетички бенчмарк и клиничка валидација?
Синтетичкиот бенчмарк го оценува софтверот на конструирани случаи, додека клиничката валидација бара докази соодветни на предвидената популација на пациенти и клиничкото тврдење. Дури и 100.000 синтетички случаи не можат да ја утврдат преваленцата во реални услови, клиничката корист или перформансите при секој проблем со недостасувачка анамнеза и квалитетот на примерокот. Синтетичкото тестирање може да помогне во идентификувањето технички дефекти и да поддржи проверки при регресија. Тоа треба да ја надополнува, а не да ја заменува, репрезентативната надворешна и проспективна евалуација.
Колку независно тестирање ѝ е потребно на здравствената вештачка интелигенција?
За вештачката интелигенција во здравството е потребно независно тестирање сразмерно на последиците од погрешен резултат, а не универзален минимален број извештаи. Ако не се забележат неуспеси во 100 независни случаи, приближната горна граница на стапката на неуспеси е близу 3%, според правилото на три. Купувачите треба да побараат заштитени податоци за тестирање, замрзната верзија на моделот и откриени односи меѓу евалуаторите. За тврдењата за ретки сериозни грешки обично се потребни повеќе докази отколку што може да обезбеди мал пилот-проект за употребливост или изводливост.
Дали поддршката за 100 јазици значи еднаква точност на секој јазик?
0 Поддршката за 100 јазици не значи иста клиничка точност на сите тие јазици. Евалуацијата за секој јазик треба да ги тестира извлекувањето на влезните податоци, децималните конвенции, мерните единици, негацијата и значењето на препораките. На пример, гликозата запишана како 5,6 mmol/L не смее да се толкува како 56 mmol/L. Купувачите треба да побараат именители специфични за секој јазик и да наведат кои јазици не биле клинички прегледани.
Може ли вештачката интелигенција да дијагностицира хронична бубрежна болест врз основа на еден низок резултат на eGFR?
Еден резултат од eGFR под 60 mL/min/1.73 m², сам по себе, не утврдува хронична бубрежна болест. Насоките на KDIGO од 2024 година ја дефинираат хроничната бубрежна болест преку бубрежни абнормалности присутни најмалку 3 месеци, со процена на хроничноста и клиничкиот контекст. Акутните промени, составот на телото и други фактори можат да влијаат врз толкувањето. Софтверот со вештачка интелигенција треба да ја објасни неизвесноста и да го поддржи понатамошното следење од страна на лекар, наместо една намалена процена да ја означи како трајна болест.
Дознајте како да ги читате крвните резултати
Поставете го вашиот лабораториски извештај и AI на Kantesti ќе го објасни секој биомаркер на разбирлив јазик за неколку секунди. Го користат повеќе од 2 милиони луѓе ширум светот.
Референци
- Klein, T., Mitchell, S., & Weber, H. (2025). Водич за тест на крвта за C3 C4 комплемент и титар на ANA. Kantesti AI за медицински истражувања. ДОИ
- Klein, T., Mitchell, S., & Weber, H. (2025). Тест на крвта за вирусот Нипах: водич за рано откривање и дијагностицирање 2026. Kantesti AI за медицински истражувања. ДОИ
- Bossuyt PM и др. (2015). STARD 2015: ажуриран список на суштински ставки за известување за студии на дијагностичка точност. BMJ. ДОИ ПабМед
- Collins GS и др. (2024). Изјава TRIPOD+AI: ажурирани упатства за известување за клинички предиктивни модели што користат регресија или методи на машинско учење. BMJ. ДОИ
- Работна група за ХББ на Kidney Disease: Improving Global Outcomes (KDIGO) (2024). Клиничко упатство на KDIGO за 2024 година за процена и третман на хронична бубрежна болест. Меѓународно списание за бубрези. ДОИ
- 2 милиони+Анализирани тестови
- 127+Земји
- 100+Јазици
За медицинскиот тим


Сигнали за доверба E-E-A-T
Искуство
Клиничка ревизија водена од лекар за работните текови на толкување на лабораториски резултати.
Експертиза
Фокус на лабораториска медицина за тоа како биомаркерите се однесуваат во клинички контекст.
Авторитивност
Медицински рецензирано од д-р Thomas Klein, со придонес од д-р Sarah Mitchell и проф. д-р Hans Weber.
Доверливост
Толкување засновано на докази со јасни патеки за следење за да се намали алармирањето.
Медицинско одрекување од одговорност
Овој напис е само за едукативни цели и не претставува медицински совет. Секогаш консултирајте се со квалификуван здравствен работник за одлуки за дијагноза и третман.
Објавено · Ажурирано · Контактирајте го уредничкиот тим
Објавено од Kantesti Ltd, регистрирана во Англија и Велс, регистарски број на компанијата. 17090423, Лондон, Обединето Кралство.
